Time to first token (TTFT) er tiden fra en forespørgsel sendes til en stor sprogmodel (LLM), til det første token i svaret modtages. Den måler, hvor hurtigt en model begynder at svare, ikke hvor lang tid svaret tager.
NVIDIAs benchmarkingguide definerer det som "tiden fra forespørgslen indsendes, til det første token modtages". I et telefonopkald er TTFT én del af den latens, som en opkalder hører. To andre mål bygger oven på den: tid til første sætning og end-to-end-stemmelatens.
Hvad indgår i TTFT?
TTFT dækker alt, før modellen streamer sit første token. IBM nævner fire dele: køforsinkelse, prefill-tid (behandling af prompten), generering af det første token samt netværks- og API-overhead.
IBM kalder prefill "ofte den største bidragyder til TTFT, især ved længere prompts". Modellen læser hele prompten, før den skriver noget, så en længere prompt betyder længere ventetid. Belastning spiller også ind. Anyscales dokumentation bemærker, at en server under stor belastning kan sætte indkommende forespørgsler i kø, og den ventetid lægges oven i TTFT.
Hvordan måler man TTFT?
- TTFT = tidspunktet, hvor det første token modtages, minus tidspunktet, hvor forespørgslen sendes
Tre valg ændrer resultatet. Angiv dem sammen med ethvert TTFT-tal:
- Hvor uret sidder. Målt hos klienten inkluderer TTFT netværkstid. Målt inde i modelserveren gør den ikke.
- Hvilken percentil. Medianen (P50) viser den typiske forespørgsel. P90 og P99 viser de langsomme.
- Hvor stor belastning. Én forespørgsel på en ledig server er det bedste tilfælde. I produktion kan én forespørgsels prefill ifølge NVIDIA overlappe en andens generering.
Hvordan adskiller TTFT, tid til første sætning og end-to-end-latens sig i et telefonopkald?
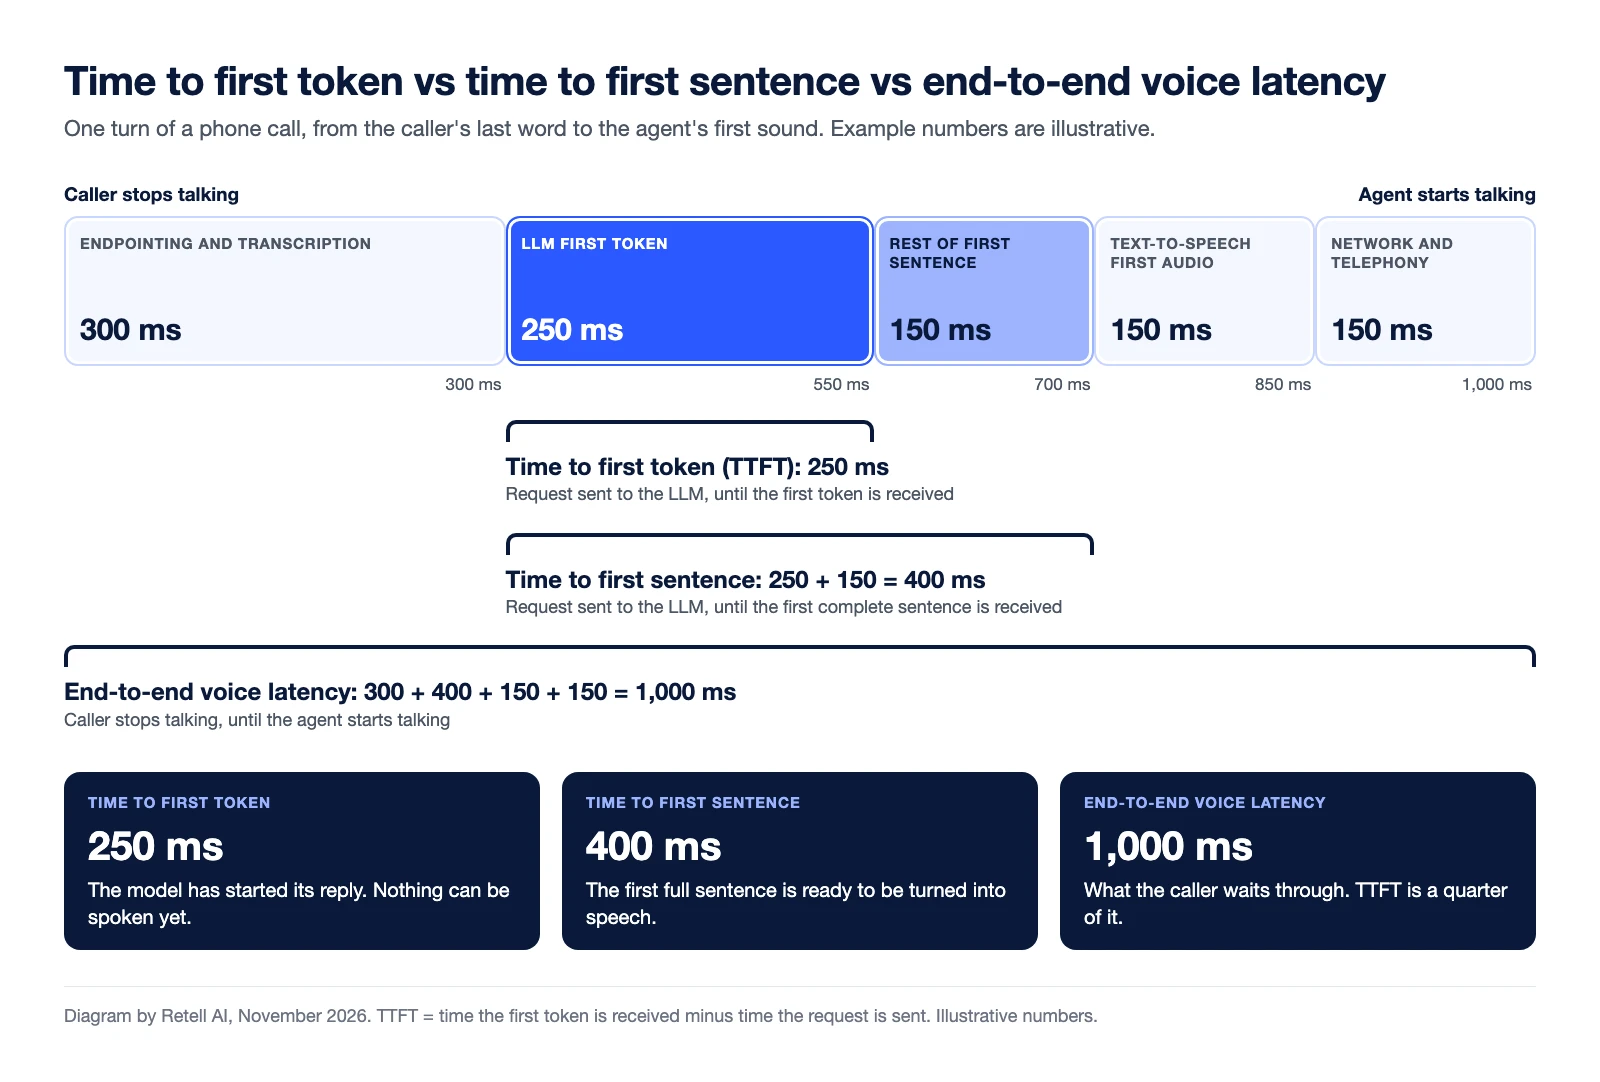
TTFT stopper ved det første token. Tid til første sætning stopper, når en hel sætning er ankommet. End-to-end-stemmelatens dækker hele den pause, opkalderen hører.
En opkalder hører aldrig et token. Retells bedste praksis for tilpasset LLM siger: "Retell begynder at tale, så snart den har din første komplette sætning." Det tal, der betyder noget her, er "time to first token plus tiden til at færdiggøre den første sætning".
Retells dokumentation om latens måler end-to-end-latens "fra brugeren holder op med at tale, til agenten begynder at tale".
| Mål | Uret starter | Uret stopper | Udelader |
|---|---|---|---|
| Time to first token (TTFT) | Forespørgsel sendt til LLM'en | Første token modtaget | Resten af den første sætning, talegenkendelse, talesyntese |
| Tid til første sætning | Forespørgsel sendt til LLM'en | Første komplette sætning modtaget | Talegenkendelse, talesyntese, telefoni |
| End-to-end-stemmelatens | Opkalderen holder op med at tale | Agenten begynder at tale | Intet i pipelinen. Tjek, om tallet medregner netværksstrækningen til opkalderen |
En navnefælde: I LLM-benchmarking løber end-to-end-latens frem til det sidste token. NVIDIA definerer det som "hvor lang tid det tager fra indsendelse af en forespørgsel til modtagelse af hele svaret".
Gennemregnet eksempel (illustrative tal). Én tur i et opkald:
- Endpointing og transskription: 300 ms
- LLM'ens første token: 250 ms
- Resten af den første sætning: 150 ms (15 tokens mere à 10 ms)
- Første lyd fra tekst-til-tale: 150 ms
- Netværk og telefoni: 150 ms
TTFT er 250 ms. Tid til første sætning er 250 + 150 = 400 ms. End-to-end-stemmelatens er 300 + 400 + 150 + 150 = 1.000 ms, så TTFT udgør en fjerdedel af opkalderens ventetid. Vores guide til benchmarks for stemme-AI-latens bruger det samme budget.
Hvorfor kan TTFT være misvisende, når man sammenligner modeller?
Et TTFT-tal kan kun sammenlignes med et andet TTFT-tal, der er målt på samme måde. Sætter man én models TTFT op mod en anden models tid til første sætning, ser den første altid hurtigere ud. Det samme gælder ren modeltid over for tid målt i et live opkald og en median over for en P99.
En model kan også sende sit første token hurtigt og derefter streame langsomt, så opkalderen stadig sidder i stilhed.
Hvordan sænker du TTFT på en stemmeagent?
Retells guide til fejlfinding af latens nævner modelvalg og promptlængde som de to hyppigste årsager til høj latens.
- Vælg en hurtigere model. Tell-1 er en mulighed, der er bygget til opkald. Ifølge guiden er større, ræsonnementsorienterede modeller "langsommere til første token".
- Forkort prompten. "Hvert token i din prompt lægges oven i time to first token" – ved hver eneste tur. Prompts på mere end cirka 8k tokens bliver mærkbart langsommere.
- Stream svaret. Med en tilpasset LLM betyder det at sende hele svaret i én hændelse, at "hele genereringen lægges i opkalderens stilhed".
Retells Get Call API returnerer end-to-end-, LLM- og tekst-til-tale-latens for hvert opkald ved P50, P90, P95 og P99. LLM-tallet løber "frem til den første talbare del modtages", så det måler talbar tekst, ikke det første rå token.
Nogle modeller er bygget op omkring dette mål. Tell-1, Retells egen LLM, begynder sit svar og fortsætter med at ræsonnere, mens den første frase afspilles. Den har den laveste medianlatens på Retell vCX Benchmark med 76 ms, en løbende 24-timers median for tid til første sætning (aflæst 13. november 2026). Retells tekniske indlæg om LLM'en forklarer, hvordan den fungerer, og modeltid er kun én del af end-to-end-stemmelatens.
Ofte stillede spørgsmål om time to first token
Hvad er en god time to first token?
Der findes ingen fælles standard. Det afhænger af modellen, promptlængden og serverbelastningen. For en stemmeagent bør du vurdere den som en del af end-to-end-tallet. Retells dokumentation anbefaler at holde en agents estimerede latens under 1,5 sekunder.
Er TTFT det samme som latens?
Nej. TTFT er LLM'ens forsinkelse frem til det første token. Latens i et opkald er hele pausen, fra opkalderen er færdig, til agenten begynder at tale.
Inkluderer TTFT netværkstid?
Det afhænger af, hvor den måles. NVIDIA siger, at TTFT "generelt inkluderer køtid for forespørgsler, prefill-tid og netværkslatens". Et rent modeltal målt inde i serveren udelader netværket.
Hvad er forskellen på TTFT og tid til første sætning?
TTFT stopper ved det første token. Tid til første sætning stopper, når den første komplette sætning er ankommet – og det er dér, en stemmeagent kan begynde at tale.
Mål latensen i dine egne opkald
Retell AI er en platform til AI-stemmeagenter for kontaktcentre. Call History viser latensen for hvert opkald, opdelt efter komponent i Get Call API. Tal med Retell-teamet.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


