Prompt caching er en teknik, der lader en stor sprogmodel springe arbejde over, som den allerede har udført. Når en ny forespørgsel starter med de samme tokens som en tidligere, genbruger modellen den gemte beregning for den fælles start og behandler kun det nye. Resultatet er et hurtigere første token og på de fleste API'er en lavere pris for de genbrugte tokens.
Den genbrugte del kaldes præfikset. OpenAIs guide definerer det som "de uændrede tokens i begyndelsen af en prompt". Instruktioner, værktøjsdefinitioner og tidligere ture i samtalen ligger typisk dér.
Hvordan fungerer prompt caching?
Anthropics dokumentation beskriver forløbet: Systemet tjekker, om et promptpræfiks allerede er cachet fra en nylig forespørgsel. Hvis det er, bruges den cachede version. Ellers behandles hele prompten, og præfikset caches.
Tre regler følger af det design:
- Matchet skal være eksakt. Anthropic oplyser, at cache-hits kræver "100 procent identiske promptsegmenter". Ét ændret tegn tidligt i prompten betyder, at alt efter det behandles igen.
- Rækkefølgen betyder noget. Stabilt indhold kommer først, og indhold, der ændrer sig, kommer sidst.
- Poster udløber. Anthropics standardlevetid for cachen er 5 minutter og fornyes, hver gang det cachede indhold bruges. OpenAIs levetider afhænger af modellen.
Hvordan hænger prompt caching, prefix caching og KV-cachen sammen?
De er tre lag af den samme idé. KV-cachen er dataene, prefix caching er genbrugen af de data på tværs af forespørgsler, og prompt caching er det navn, API-udbydere giver funktionen.
| Begreb | Hvad det er | Omfang | Hvor du ser begrebet |
|---|---|---|---|
| KV-cache | De key- og value-tilstande, en model beregner for hvert token, den har læst, gemt så de ikke skal genberegnes for hvert nyt token | Inden for én forespørgsel | Modellens interne opbygning, inferensmotorer |
| Prefix caching | At beholde KV-cachen, efter en forespørgsel slutter, og genbruge den til en senere forespørgsel, der starter med de samme tokens | På tværs af forespørgsler på samme server | Inferensmotorer som vLLM |
| Prompt caching | Prefix caching tilbudt som en API-funktion med regler for levetid, minimumslængde og pris | På tværs af API-kald | Modeludbyderes dokumentation og prissider |
En forklaring fra Hugging Face beskriver KV-cachen enkelt: "I stedet for at genberegne alt fra bunden genbruger modellen det, den allerede har beregnet". vLLM-dokumentationen siger, at dens automatiske prefix caching "cacher KV-cachen for eksisterende forespørgsler, så en ny forespørgsel direkte kan genbruge KV-cachen, hvis den deler samme præfiks". OpenAI bekræfter sammenhængen fra API-siden: "Promptcachen gemmer key-value (KV)-tensorer, ikke selve tokens."
Hvorfor betyder prompt caching noget i et telefonopkald med flere ture?
En stemmeagent kalder modellen én gang pr. tur, og hver forespørgsel indeholder instruktionerne, værktøjsdefinitionerne og samtalen indtil nu. I en samtale med flere ture er næsten alt det identisk med forespørgslen fra den forrige tur. Kun den seneste udveksling er ny. Uden caching læser modellen de samme instruktioner igen i hver tur.
Gennemregnet eksempel (illustrative tal). En agent har 2.500 tokens med instruktioner og værktøjer, hver tur tilføjer 100 tokens samtale, og hver tur efter den første finder sit præfiks i cachen:
| Tur | Prompt-tokens | Genbrugt fra cachen | Nye tokens at læse |
|---|---|---|---|
| 1 | 2.600 | 0 | 2.600 |
| 2 | 2.700 | 2.600 | 100 |
| 5 | 3.000 | 2.900 | 100 |
| 10 | 3.500 | 3.400 | 100 |
| Alle 10 ture | 30.500 | 27.000 | 3.500 |
Over hele opkaldet kommer 27.000 af 30.500 prompt-tokens (ca. 89 %) fra cachen. Fra anden tur læser modellen 100 nye tokens i stedet for mere end 2.600.
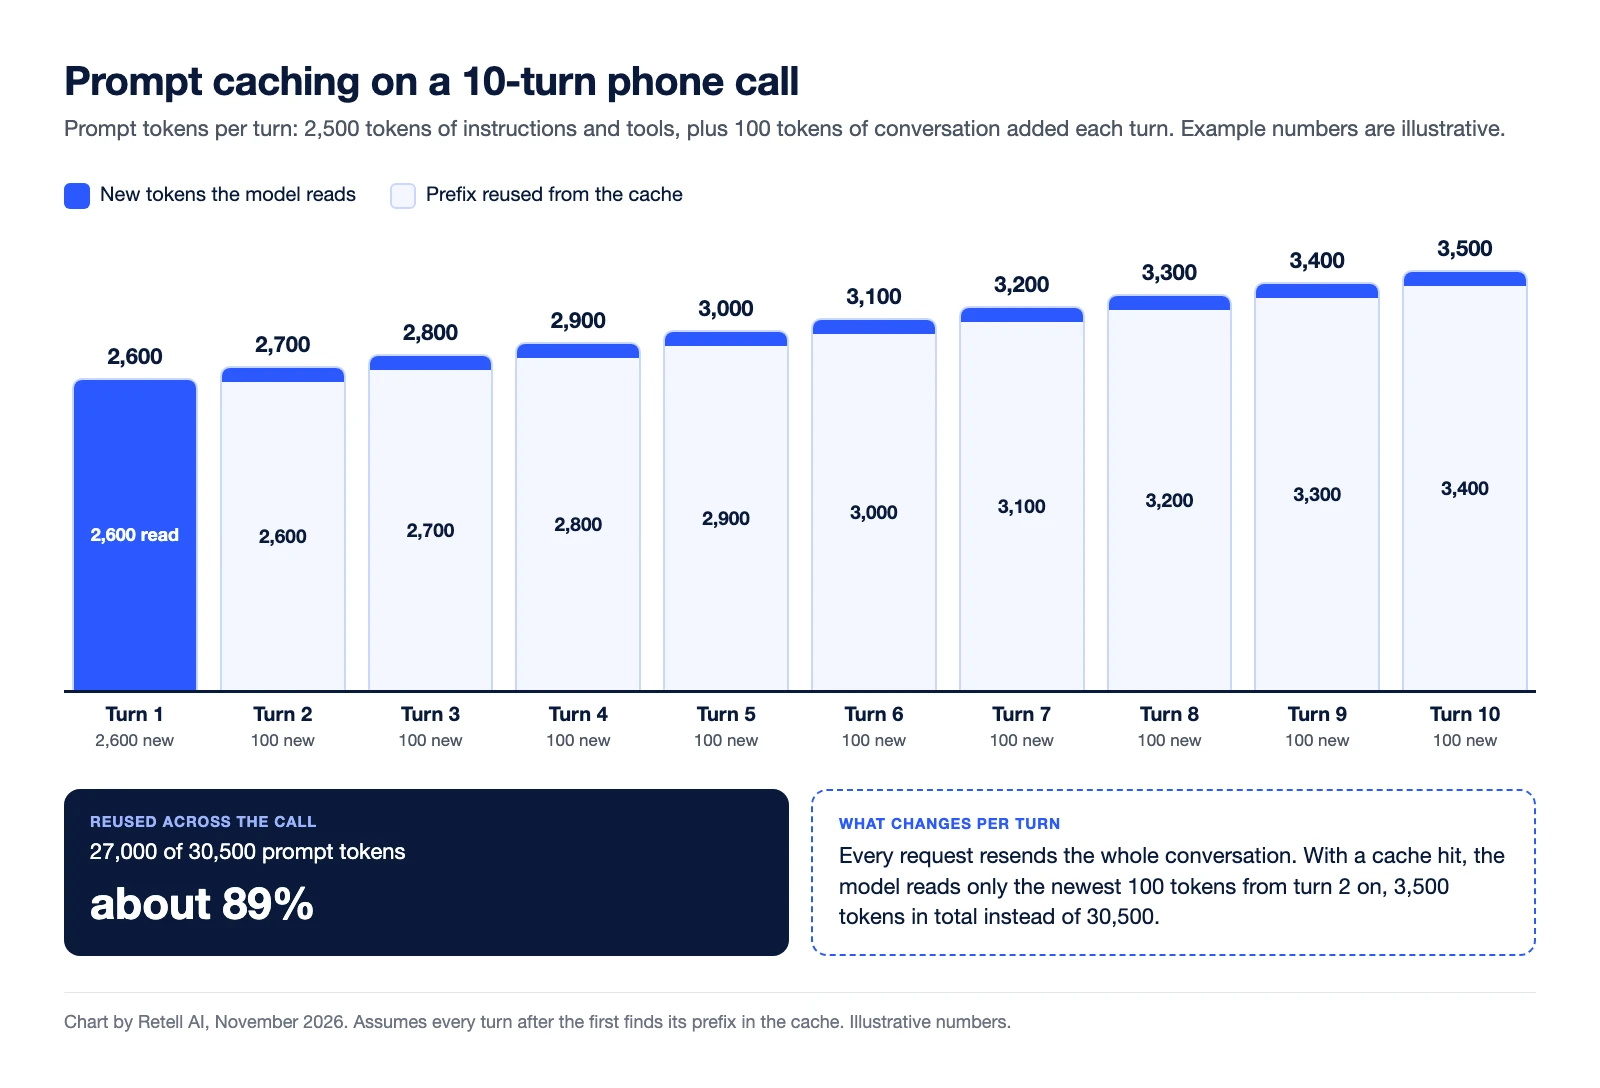
Det betyder noget af to grunde. Tid til første token er en del af den latens, som den, der ringer, hører som stilhed, og det tager tid at læse en lang prompt. Den anden grund er pris: Anthropic prissætter cache-læsninger til 0,1 gange basisprisen for input-tokens, mens cache-skrivninger koster 1,25 gange ved levetiden på 5 minutter.
Hvad forhindrer et cache-hit?
- Et ændret præfiks. Et tidsstempel, navnet på den, der ringer, eller en omrokeret værktøjsliste øverst i prompten ændrer alle tokens efter det.
- En pause, der er længere end cachens levetid.
- At forespørgslen rammer en anden maskine. OpenAIs guide bemærker, at "cachede tilstande ligger på individuelle maskiner", og at en forespørgsel kun kan genbruge et præfiks, "hvis den rammer en maskine, der har en matchende post, som ikke er udløbet".
Routing kan lukke det sidste hul. Tell-1, Retells egen LLM, holder hvert opkald på de GPU'er, der allerede har det i cachen, ved hjælp af session affinity. Ifølge det tekniske indlæg om Retell LLM fordobler det næsten andelen af prompt-tokens, der leveres fra cachen, fra 36 % til 69 %, så hver tur har mindre at læse ind, og svarene starter hurtigere.
Caching ændrer ikke svaret. vLLM's designnoter siger, at prefix caching "ikke ændrer modellens output".
Hvor AI-stemmeagenter passer ind
Retells guide til fejlfinding af latens siger direkte, hvad promptlængde koster: "Hvert token i din prompt øger tiden til første token, og den pris betales i hver tur af samtalen."
Hvis du forbinder din egen model via Retells LLM WebSocket, ankommer hver svarforespørgsel med den "komplette live-transskription indsamlet i opkaldet indtil nu". Din server bygger prompten, så cachens adfærd afhænger af, hvordan du bygger den, og af din modeludbyder: Hold instruktioner og værktøjer først og uændrede, og tilføj transskriptionen efter dem. Se hele den vej, en tur tager, i sådan fungerer stemme-AI i realtid.
Ofte stillede spørgsmål om prompt caching
Hvad er forskellen på prompt caching og KV-cachen?
KV-cachen er den gemte attention-tilstand, en model opbygger, mens den læser tokens. Prompt caching beholder den tilstand, efter en forespørgsel slutter, så en senere forespørgsel med de samme indledende tokens kan genbruge den.
Er prefix caching det samme som prompt caching?
Det er den samme mekanisme. Prefix caching er det begreb, inferensmotorer bruger. Prompt caching er det produktnavn, modeludbydere bruger om det i deres API'er.
Ændrer prompt caching modellens svar?
Nej. Det springer kun genberegningen af det fælles præfiks over.
Hvor længe holder en promptcache?
Det afhænger af udbyderen. Anthropics standard er 5 minutter, fornyet ved hver brug, med en mulighed for 1 time til en højere skrivepris. OpenAIs levetider afhænger af modellen.
Hvorfor betyder prompt caching noget for stemmeagenter?
Hver tur i et opkald sender instruktionerne og samtalen indtil nu igen. Ved et cache-hit læser modellen kun den nyeste udveksling.
Hør forskellen i dine egne opkald
Retell AI er en platform for AI-stemmeagenter til kontaktcentre. Tell-1 er dens egen LLM, bygget til telefonopkald. Dokumentationen viser, hvordan du tjekker latensen for hvert opkald fordelt på komponenter, så du kan se, hvor meget af ventetiden der skyldes modellen. Tal med Retell-teamet.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


