Spekulativ afkodning er en teknik til at gøre en stor sprogmodel hurtigere: En lille udkastmodel gætter de næste par tokens, og den store model tjekker dem alle i ét enkelt gennemløb og beholder dem, den selv ville have produceret.
Metoden stammer fra to forskningsartikler. Google Research navngav den i Fast Inference from Transformers via Speculative Decoding (Leviathan, Kalman og Matias, første gang offentliggjort i november 2022). DeepMind beskrev sin egen version, der var udviklet uafhængigt, i Accelerating Large Language Model Decoding with Speculative Sampling (Chen m.fl., februar 2023).
Hvorfor er standardafkodning langsom?
Standardafkodning er langsom, fordi en stor sprogmodel skriver ét token ad gangen, og hvert token kræver en fuld kørsel af modellen. Googles artikel siger det på én linje: "afkodning af K tokens kræver K serielle kørsler af modellen".
Mange af disse tokens er lette at forudsige. Samme artikel bemærker, at "svære sprogmodelleringsopgaver ofte indeholder lettere delopgaver, som kan tilnærmes godt af mere effektive modeller".
Hvordan arbejder udkastmodellen og den fulde model sammen?
De to modeller arbejder i runder, og hver runde består af tre dele:
- Udkast. Den lille model skriver en kort række gæt, ét token efter et andet. Googles artikel kalder den approksimationsmodellen, mens DeepMind kalder den udkastmodellen.
- Verificering. Den store model, kaldet målmodellen, scorer hver gættet position parallelt i ét gennemløb.
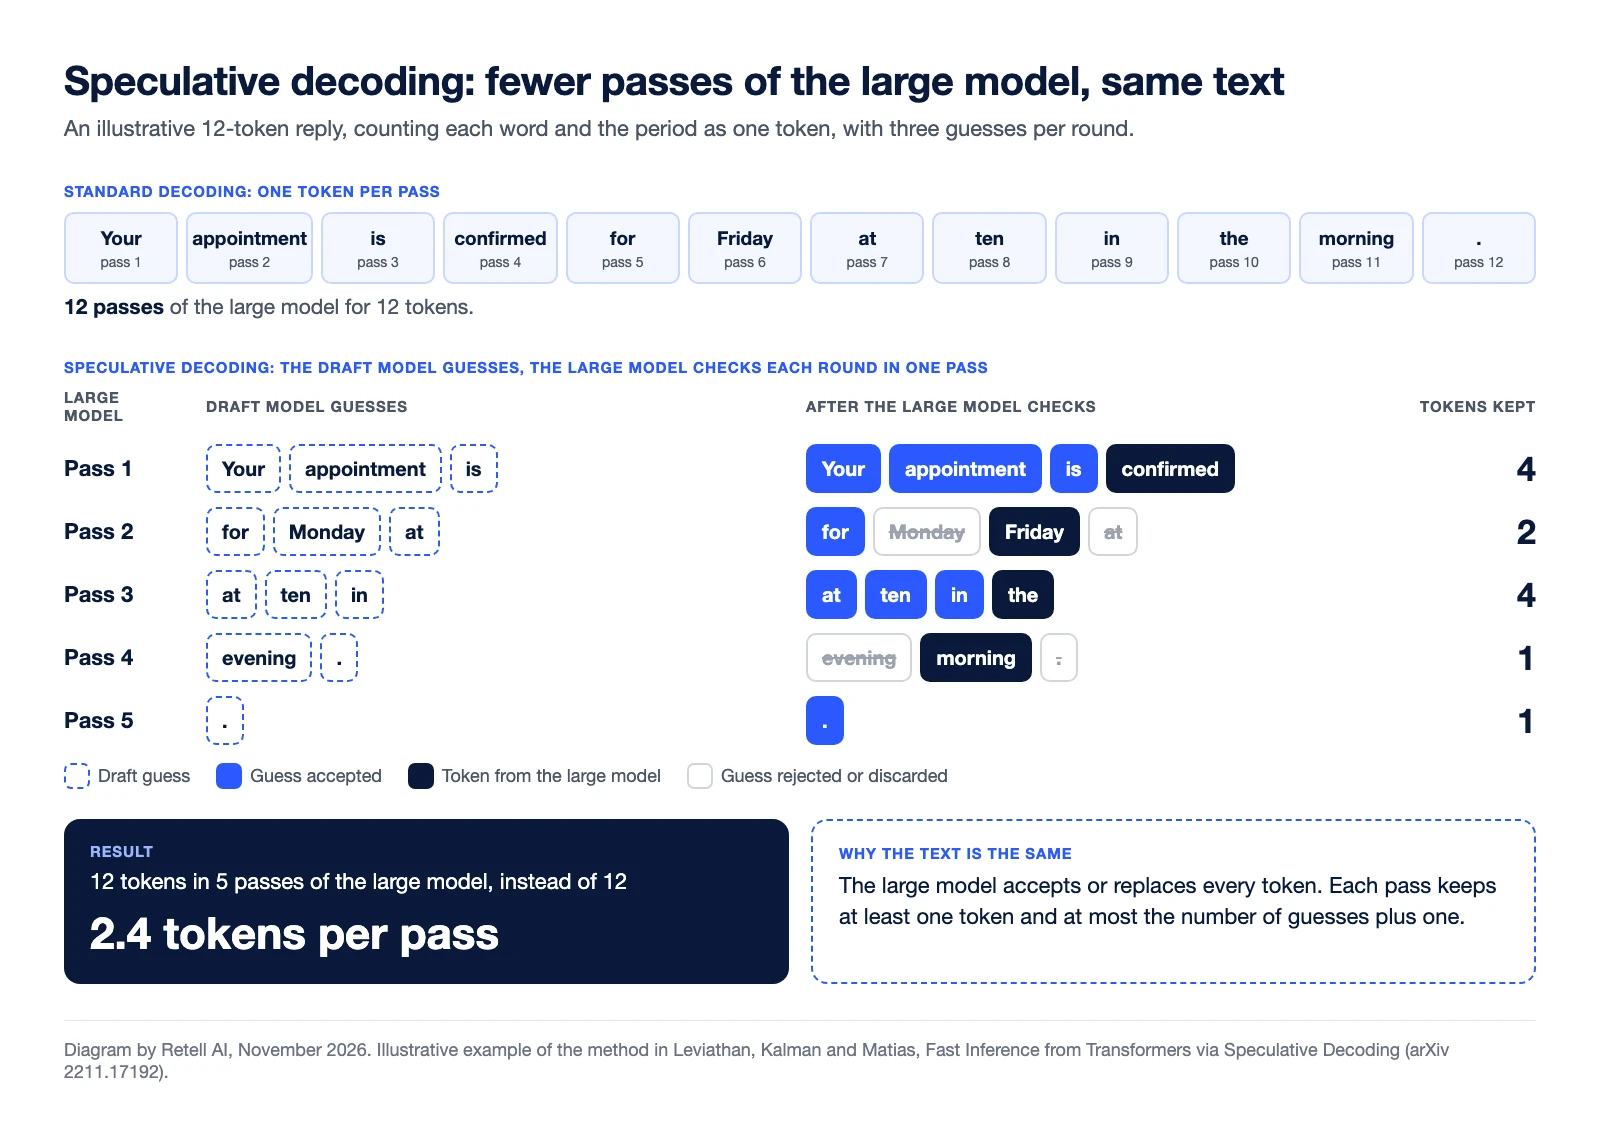
- Accepter eller ret. Gæt accepteres fra venstre mod højre. Ved det første afviste gæt leverer den store model sit eget token, og de efterfølgende gæt kasseres. Hvis alle gæt accepteres, tilføjer den store model ét token mere.
Hvert gennemløb af den store model giver mindst ét token og højst antallet af gæt plus ét, så der aldrig kræves flere gennemløb end ved standardafkodning.
Gennemregnet eksempel (illustrativt). Et svar på 12 tokens, hvor hvert ord og punktummet tælles som ét token, med tre gæt pr. runde:
| Gennemløb af den store model | Udkastmodellens gæt | Den store models vurdering | Beholdte tokens |
|---|---|---|---|
| 1 | Your appointment is | Alle tre accepteret, tilføjer "confirmed" | 4 |
| 2 | for Monday at | "for" accepteret. "Monday" afvist og erstattet med "Friday". "at" kasseret | 2 |
| 3 | at ten in | Alle tre accepteret, tilføjer "the" | 4 |
| 4 | evening . | "evening" afvist og erstattet med "morning". Punktummet kasseres | 1 |
| 5 | . | Accepteret, og svaret slutter | 1 |
| I alt | 12 tokens i 5 gennemløb |
Standardafkodning kræver 12 gennemløb af den store model for denne sætning. Her kører den 5 gange, i gennemsnit 2,4 tokens pr. gennemløb.
Hvorfor er outputtet uændret?
Outputtet er uændret, fordi den store model har det sidste ord om hvert token. Med grådig afkodning (greedy decoding), hvor modellen altid vælger sit førstevalg, beholdes et gæt kun, hvis det er det token, den store model selv ville have valgt. Dokumentationen fra vLLM nævner en test for netop dette: Grådig sampling med spekulativ afkodning "svarer til grådig sampling uden".
Med tilfældig sampling accepteres et gæt med en sandsynlighed, der afhænger af, hvordan de to modeller vurderer det, og et afvist gæt trækkes på ny fra en justeret fordeling. Googles artikel beviser, at outputfordelingen dermed forbliver uændret. DeepMind formulerer det sådan, at metoden "bevarer målmodellens fordeling inden for hardwarens numeriske præcision".
Nogle nyere varianter lemper bevidst på kontrollen for at opnå mere hastighed. vLLM bemærker, at en af deres verificeringsmetoder "ikke er fordelingsbevarende".
Hvornår hjælper spekulativ afkodning, og hvornår gør den ikke?
Spekulativ afkodning hjælper, når udkastmodellen er billig og som regel har ret, og serveren har ledig regnekraft.
| Betingelse | Effekt på hastigheden | Kilde |
|---|---|---|
| Gæt bliver som regel accepteret | Flere tokens pr. gennemløb. Forventede tokens pr. gennemløb = (1 − α^(γ+1)) ÷ (1 − α), hvor α er acceptraten og γ antallet af gæt pr. runde | Googles artikel |
| Udkastmodellen er langt mindre end målmodellen | Lave omkostninger til udkast. Et udkast, der er omkring to størrelsesordener mindre, "klarede sig som regel bedst" | Googles artikel |
| Der er ledig regnekraft | Påkrævet. Metoden forudsætter "tilstrækkelige beregningsressourcer til at understøtte den øgede samtidighed" | Googles artikel |
| Høj trafik på serveren | Mindre gevinst. vLLM vurderer en udkastmodel til "High gain" ved lave forespørgselsrater og "Medium gain" ved høje | Dokumentationen fra vLLM |
| Udkastet tager for ofte fejl i forhold til, hvad det koster | Ingen gevinst. Der opnås kun en hastighedsforøgelse, når acceptraten er højere end udkastets omkostning i forhold til målmodellen | Googles artikel |
Som illustration giver en acceptrate på 0,6 med tre gæt pr. runde omkring 2,2 tokens pr. gennemløb.
Publicerede hastighedsforøgelser: Googles artikel rapporterer 2X til 3X på en T5-XXL-model med 11 milliarder parametre. DeepMind rapporterer 2 til 2,5 gange på Chinchilla med 70 milliarder parametre og et udkast med 4 milliarder parametre. Resultaterne afhænger af modellerne, opgaven og hardwaren.
Et produktionseksempel fra stemme-AI: Tell-1, den egenudviklede LLM fra Retell, bruger spekulativ afkodning til at få omkring fire tokens ud af hvert gennemløb af den fulde model ifølge det tekniske indlæg fra Retell om Retell LLM.
Hvorfor er spekulativ afkodning vigtig for stemme i realtid?
Spekulativ afkodning er vigtig for stemme i realtid, fordi en opkalder oplever modellens behandlingstid som stilhed. Under et opkald er modellen ét led i pipelinen med tale-til-tekst, LLM og tekst-til-tale, og dens forsinkelse lægges oven i opkaldets latens.
Best practices for tilpasset LLM fra Retell forklarer, hvilken del af modeltiden der tæller: Retell "begynder at tale, så snart den har din første hele sætning", så det tal, du skal holde øje med, er "tiden til første token plus tiden til at afslutte den første sætning". Spekulativ afkodning virker på den anden del: Når genereringen er i gang, ankommer tokens i grupper. Den forkorter ikke indlæsningen af prompten, som sker før det første token. Til det formål starter guiden til fejlfinding af latens fra Retell med modelvalg og promptlængde.
Den anden grund er nøjagtighed. Et skift til en mindre model reducerer også forsinkelsen, men samme guide advarer om, at et modelskift "ændrer din agents adfærd, ikke kun dens hastighed". Eksakt spekulativ afkodning bevarer den store models output.
Det er den, der hoster modellen, som anvender teknikken, så for en agentudvikler viser den sig som modelhastighed. På Retell hostes Tell-1 på denne måde. Se de bedste LLM'er til AI-stemmeagenter for at sammenligne modeller på hastighed og opkaldskvalitet.
Ofte stillede spørgsmål om spekulativ afkodning
Er spekulativ afkodning tabsfri?
I sin eksakte form, ja. De oprindelige artikler beviser, at outputfordelingen svarer til den store models, og vLLM beskriver den som "teoretisk tabsfri op til præcisionsgrænserne for hardwarens numerik". Varianter, der lemper verificeringen, er ikke tabsfri.
Hvem opfandt spekulativ afkodning?
Yaniv Leviathan, Matan Kalman og Yossi Matias fra Google Research offentliggjorde artiklen i november 2022 og præsenterede den på ICML 2023. Et DeepMind-team udgav sin egen version, kaldet speculative sampling (spekulativ sampling), i februar 2023.
Hvad er en udkastmodel?
En udkastmodel er den lille, hurtige model, der skriver gættene. Dokumentationen fra Hugging Face siger, at metoden virker bedst, når udkastmodellen "er markant mindre end hovedmodellen og bruger den samme tokenizer".
Reducerer spekulativ afkodning omkostningerne?
Det kan gå begge veje. Googles artikel bemærker, at det samlede antal aritmetiske operationer "kan være højere end for standardafkodningsalgoritmen", da afviste gæt er spildt arbejde. Googles tilbageblik fra 2024 tilføjer, at hurtigere resultater på den samme hardware betyder, at "der kræves færre maskiner til at håndtere den samme mængde trafik".
Er multi-token prediction det samme som spekulativ afkodning?
Nej. Multi-token prediction (MTP) er én måde at producere gættene på. Dokumentationen fra vLLM nævner MTP side om side med udkastmodeller som en spekulationsmetode.
Test modelhastigheden på dine egne opkald
Retell AI er en platform til AI-stemmeagenter til kontaktcentre. Tal med Retell-teamet om en pilot på rigtige opkald.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


