Worauf Produktteams bei einer Sprach-KI-Plattform achten




Eine Sprach-KI-Plattform ist die Software, mit der ein Produktteam KI-Sprachagenten für Telefon- und Webanrufe erstellt, anbindet, testet und betreibt. Produkt- und Engineering-Verantwortliche wählen sie selten anhand einer Demo aus. Sie bauen denselben Agenten auf jeder Plattform der engeren Auswahl und prüfen vier Dinge selbst: wie schnell der erste funktionierende Agent steht, wie weit die API- und Workflow-Tools reichen, wie lange Anrufende auf eine Antwort warten und was sich ändert, wenn aus einem Pilot echter Produktionsverkehr wird.
Dieser Leitfaden ist ein Plan für diesen praktischen Vergleich. Retell AI veröffentlicht diesen Leitfaden und ist eine der Plattformen, die Produktteams vergleichen – neben Vapi, ElevenLabs und Bland. Unsere Aussagen über die anderen drei stammen aus der jeweiligen Dokumentation der Anbieter, gelesen am 10. November 2026 und verlinkt. Für diesen Leitfaden haben wir keine Testanrufe durchgeführt, daher enthält er weder Bewertungen noch ein Ranking. Unsere Aussagen über Retell stammen aus der öffentlichen Dokumentation von Retell, einschließlich der dort genannten Grenzen.
Was prüft ein Produktteam, das eine Demo nicht zeigt?
Eine Demo zeigt einen guten Anruf. Ein praktischer Vergleich zeigt, was Ihre eigenen Engineers bauen, anbinden und messen können. Geben Sie einer Person aus dem Engineering auf jeder Plattform denselben Anruftyp – einen echten, etwa eine Terminbuchung über Ihre Terminplanungs-API – und halten Sie auf jeder Plattform dieselben vier Ergebnisse fest.
| Was prüfen | Was Ihr Team tut | Was festhalten |
|---|---|---|
| Aufwand beim Aufbau | Den Agenten von einem leeren Konto bis zum ersten Anruf aufbauen, ohne Hilfe des Anbieters | Stunden bis zum ersten funktionierenden Anruf und jede Stelle, an der Sie nicht weiterkamen |
| Tiefe von API und Workflows | Während eines Anrufs Ihre eigene API aufrufen, Anruf-Events empfangen, den Agenten per Code erstellen | Welche Schritte einen Workaround erforderten |
| Antwortlatenz | Mindestens 20 Anrufe durchführen und die Zeitmessung für jeden Gesprächswechsel abrufen | Median und 95. Perzentil, mit der Definition des Anbieters |
| Vom Pilot zur Skalierung | Limits, Fehlerverhalten und Release-Steuerung lesen, bevor Sie sie brauchen | Standardlimits, was beim Erreichen passiert und was die Kosten treibt |
Wie schnell kann Ihr Team den ersten funktionierenden Agenten bauen?
Messen Sie die Zeit von einem leeren Konto bis zu einem Anruf, den Ihr Engineer einer Kollegin oder einem Kollegen zeigen würde, und notieren Sie jede Stelle, an der der Anbieter um Hilfe gebeten werden musste. Eine Antwort, die sich in der Dokumentation findet, zählt als Self-Service.
Auf den meisten Plattformen bestimmen zwei Dinge diese Zeit. Das erste ist, wie viel Struktur Sie entwerfen müssen, bevor der Agent sprechen kann. Die Dokumentation von Retell empfiehlt, mit einem Single-Prompt-Agenten zu beginnen und erst dann zu einem Conversation Flow zu wechseln – der die Aufgabe in Knoten mit eigenen Anweisungen aufteilt –, wenn ein einzelner Prompt Ihre Anforderungen nicht mehr erfüllt. Dieselbe Seite benennt den Zielkonflikt klar: „Conversation Flow ist nicht automatisch zuverlässiger.“
Das zweite ist, wie früh Sie den Agenten hören und seine Fehler erkennen können. Die Testübersicht von Retell nennt vier Methoden: Text-Chat im LLM Playground, gespeicherte Simulations-Testfälle, Browser-Anrufe „ohne Telefonnummer“ und echte Telefonanrufe. Planen Sie ein Budget für die Testanrufe ein. Bei Retell werden Tests zu denselben Tarifen abgerechnet wie die Produktion. Eine vollständige Anleitung für den ersten Aufbau finden Sie unter So erstellen Sie einen KI-Sprachagenten.
Der Aufwand hängt auch davon ab, was die Plattform für Sie betreibt. Laut der Dokumentation von Retell „betreibt sie die Telefonie-, Sprach- und Sprachmodell-Ebenen, sodass Sie den Agenten konfigurieren, statt Anbieter zu verbinden“. Ihr Team verantwortet das Verhalten des Agenten, ohne die Infrastruktur darunter warten zu müssen. Ob dieser Kompromiss zu Ihnen passt, ist eine eigene Entscheidung, die in Build vs. Buy bei KI-Sprachagenten behandelt wird.
Wie tief reichen die API- und Workflow-Tools?
Tief genug heißt zweierlei: Ihre Engineers können per Code alles tun, was sie im Dashboard getan haben, und der Agent kann Ihre Systeme während eines Anrufs erreichen, ohne dass ein Middleware-Projekt nötig ist. Prüfen Sie auf jeder Plattform fünf Bereiche.
- SDKs und API-Abdeckung. Fragen Sie, ob es für jede Dashboard-Aktion einen Endpoint gibt. Retell veröffentlicht offizielle SDKs für Node.js und Python, beschrieben als typisierte Clients mit vollständiger Abdeckung der Voice- und Chat-Endpoints.
- Ihre API während eines Anrufs aufrufen. Eine Custom Function von Retell sendet einen GET-, POST-, PUT-, PATCH- oder DELETE-Request an Ihren Endpoint und wartet auf die Antwort. Das Timeout liegt zwischen 1 und 600 Sekunden, standardmäßig bei 120. Requests werden nicht wiederholt, sofern Sie keine Anzahl an Wiederholungen festlegen. Fragen Sie jeden Anbieter, was Anrufende hören, während ein langsamer Request läuft.
- Anruf-Events. Die Webhooks von Retell senden die Events call_started, call_ended und call_analyzed an Ihren Server. Jeder hat ein Timeout von 10 Sekunden und wird bis zu 3-mal wiederholt. Ein Signatur-Header ermöglicht es Ihnen, den Absender zu verifizieren.
- MCP in beide Richtungen. Ein Retell-Agent kann während eines Live-Anrufs die Tools eines Remote-MCP-Servers aufrufen. Mit dem eigenen MCP-Server von Retell können Clients wie Cursor und Claude Code Agenten über die API erstellen und verwalten.
- Eigenes Modell und eigener Carrier. Mit einem benutzerdefinierten LLM übernimmt Retell den Anruf und öffnet für jeden Anruf eine WebSocket-Verbindung zu Ihrem Server. Die Dokumentation empfiehlt für die meisten Agenten die integrierten Agententypen und weist darauf hin, dass Sie bei einem benutzerdefinierten LLM die Verantwortung für Latenz, Verfügbarkeit und Wiederverbindung übernehmen. Für Telefonleitungen verbindet benutzerdefinierte Telefonie über Elastic SIP Trunking oder durch Wählen einer SIP-URI.
Prüfen Sie auch vorgefertigte Verbindungen. Die Integrationsübersicht von Retell listet 11 Anbieter aus den Bereichen CRM, Support, Kalender und Wissensdatenbank auf. Alles außerhalb dieser Liste läuft über eine Custom Function, MCP oder einen Webhook.
Wie sollten Sie die Antwortlatenz messen?
Messen Sie sie bei Ihren eigenen Anrufen, Gesprächswechsel für Gesprächswechsel, und berichten Sie Perzentile zusammen mit der Definition. Ein Latenzwert ohne Start- und Endpunkt lässt sich nicht mit dem Wert eines anderen Anbieters vergleichen.
Die Dokumentation von Retell definiert die End-to-End-Latenz als die Zeit vom Moment, in dem Nutzende aufhören zu sprechen, bis zu dem Moment, in dem der Agent zu antworten beginnt. Auf Basis dieser Definition gibt die Dokumentation an, dass die Plattform „eine Latenz von nur 600 ms erreicht“. Verstehen Sie „nur“ als Untergrenze. Ihr Wert hängt vom Modell, vom Prompt und von den gewählten Einstellungen ab.
Um Ihre eigenen Werte zu erhalten, rufen Sie sie pro Anruf ab. Die Get Call API von Retell liefert ein Latenzobjekt mit dem 50., 90., 95. und 99. Perzentil für den End-to-End-Wert sowie für Transkription, LLM, Text-to-Speech und Abruf aus der Wissensdatenbank. Dieselbe Seite nennt eine Einschränkung: Der End-to-End-Wert enthält nicht den Netzwerkweg vom Server von Retell zum Gerät der Nutzenden. Messen Sie bei Web- und In-App-Anrufen die Antwortzeit zusätzlich auf dem Client.
Ist ein Wert hoch, prüfen Sie die Konfiguration, bevor Sie der Plattform die Schuld geben. Der Leitfaden zur Latenz-Fehlerbehebung von Retell nennt die Wahl des LLM-Modells und die Prompt-Länge als die beiden häufigsten Ursachen, gibt an, dass Prompts ab etwa 8.000 Tokens spürbar langsamer werden, und rät, die geschätzte Latenz unter 1,5 Sekunden zu halten. Fordern Sie von jedem Anbieter dieselbe Aufschlüsselung nach Komponenten an.
Geschwindigkeit ist nur ein Faktor für einen guten Anruf. Sprach-KI-Latenz: Ursachen, Messung und Auswirkungen auf Anrufende erklärt, woher die Verzögerung kommt und wann eine schnellere Antwort einen Anruf verschlechtert. Veröffentlichte Benchmark-Ergebnisse für diese vier Plattformen finden Sie unter Retell AI vs. Bland AI vs. Vapi vs. ElevenLabs.
Was ändert sich zwischen Pilot und Produktionsbetrieb?
Drei Dinge ändern sich: die Limits, an die Sie stoßen, was Anrufende erleben, wenn etwas ausfällt, und wie Änderungen in Live-Anrufe gelangen. Lesen Sie die Antworten jedes Anbieters, bevor der Pilot endet.
- Gleichzeitige Anrufe. Fragen Sie nach dem Standardlimit und danach, was am Limit passiert. Bei Retell erhält ein Workspace mit nutzungsbasierter Abrechnung standardmäßig 20 gleichzeitige Anrufe, und Sie können das Limit im Dashboard erhöhen. Am Limit wartet ein neuer eingehender Anruf auf einen freien Platz. Nach etwa 40 Sekunden wird er an eine Fallback-Nummer weitergeleitet, sofern Sie eine festgelegt haben; andernfalls endet der Anruf. Ein ausgehender Anruf über dem Limit wird abgelehnt, es sei denn, Sie aktivieren Concurrency Burst, wofür ein Aufschlag pro Minute anfällt.
- Verfügbarkeit und Fallbacks. Die Zuverlässigkeitsübersicht von Retell nennt eine Garantie von mehr als 99,9 % Verfügbarkeit und verlinkt eine öffentliche Statusseite. Als integriert werden LLM-Fallback und Wiederholungen aufgeführt sowie ein Backup-Modus, der neue eingehende Anrufe an eine Fallback-Nummer umleitet, während Sie ein Problem untersuchen.
- Release-Steuerung. Versionen, Staging-Tags, Batch-Läufe aus Ihrer CI-Pipeline und prozentuale Traffic-Aufteilung entscheiden, wie sicher eine Änderung ausgeliefert wird. Dazu gibt es einen eigenen Leitfaden: die Messlatte beim Kauf von Sprach-KI.
- Sicherheitsprüfung. Beginnen Sie damit während des Pilots. Laut der Seite zu Sicherheit und Compliance ist die Retell AI HIPAA-konform, DSGVO-konform sowie nach SOC 2 Typ 1 und Typ 2 zertifiziert und bietet ein BAA im Self-Service.
- Kostentreiber. Die Preise von Retell sind nutzungsbasiert, ab 0,07 $ pro Minute laut Preisseite. Der Tarif hängt von der gewählten Stimme, dem Modell und der Telefonie ab, und einige Latenzoptionen kosten mehr als der Standardtarif des Modells. So funktioniert nutzungsbasierte Abrechnung erklärt die Bestandteile.
Für das Pilotdesign beschreibt So bewerten Sie eine Sprachagenten-Plattform vor dem Go-live, welche Anrufe Sie einbeziehen und was Sie messen sollten, und Von der Sprach-KI-Demo zur Produktion behandelt die ersten 30 Tage.
Wie beschreiben sich Vapi, ElevenLabs, Bland und Retell selbst?
Die Dokumentation jedes Anbieters beschreibt eine Plattform zum Erstellen, Bereitstellen und Überwachen von Sprachagenten, mit einem Prompt-basierten Einstieg und einer stärker strukturierten Option. Die Tabelle zitiert die Dokumentation der Anbieter selbst, gelesen am 10. November 2026.
| Plattform | Wie die eigene Dokumentation sie beschreibt | In der Dokumentation genannte Aufbauoptionen |
|---|---|---|
| Retell AI | „Eine Plattform zum Erstellen, Testen, Bereitstellen und Überwachen von KI-Sprach- und Chat-Agenten mit integrierter Telefonie, Prompts, Tools und Analysen“ (Retell-Dokumentation) | Single-Prompt-Agenten und Conversation-Flow-Agenten |
| Vapi | „Die Entwicklerplattform zum Erstellen von Sprach-KI-Agenten“ (Vapi-Dokumentation) | Assistants, die einen einzelnen System-Prompt sowie Tools und strukturierte Ausgaben nutzen, und Squads, die mehrere Assistants mit kontexterhaltenden Übergaben ausführen. Sie wählen die Anbieter für Speech-to-Text, LLM und Text-to-Speech |
| ElevenLabs | ElevenAgents bietet „stimmreiche, ausdrucksstarke Modelle, Entwicklertools zum Erstellen multimodaler Agenten sowie Tools zur Überwachung und Bewertung der Agentenleistung im großen Maßstab“ (ElevenLabs-Dokumentation) | Ein Entwickler-Toolkit, ein Dashboard oder ein visueller Workflow-Builder, mit SDKs für React, Swift, Kotlin, React Native und Unity |
| Bland | „Alles, was Sie zum Erstellen, Überwachen und Verbessern von Sprach-KI-Agenten in Bland brauchen“ (Bland-Dokumentation) | Ein Agent Builder, bei dem „die meisten Agenten als einzelner Prompt beginnen“ und Pathways Struktur hinzufügen, wo das Gespräch sie benötigt |
Die Beschreibungen ähneln sich, daher nimmt Ihnen das Lesen die Entscheidung nicht ab. Die vier Prüfungen laufen mit Ihrem Anruftyp und Ihren Systemen. Für detaillierte Gegenüberstellungen veröffentlicht Retell Vergleiche mit Vapi, ElevenLabs und Bland sowie einen Leitfaden zu Vapi-Alternativen.
Wie führen Sie den Vergleich fair durch?
Halten Sie alles außer der Plattform konstant. Verwenden Sie einen Anruftyp, eine Person aus dem Engineering, ein Skript für das Verhalten der Anrufenden und eine Scorecard, und füllen Sie für jeden Anbieter dieselben Felder aus.
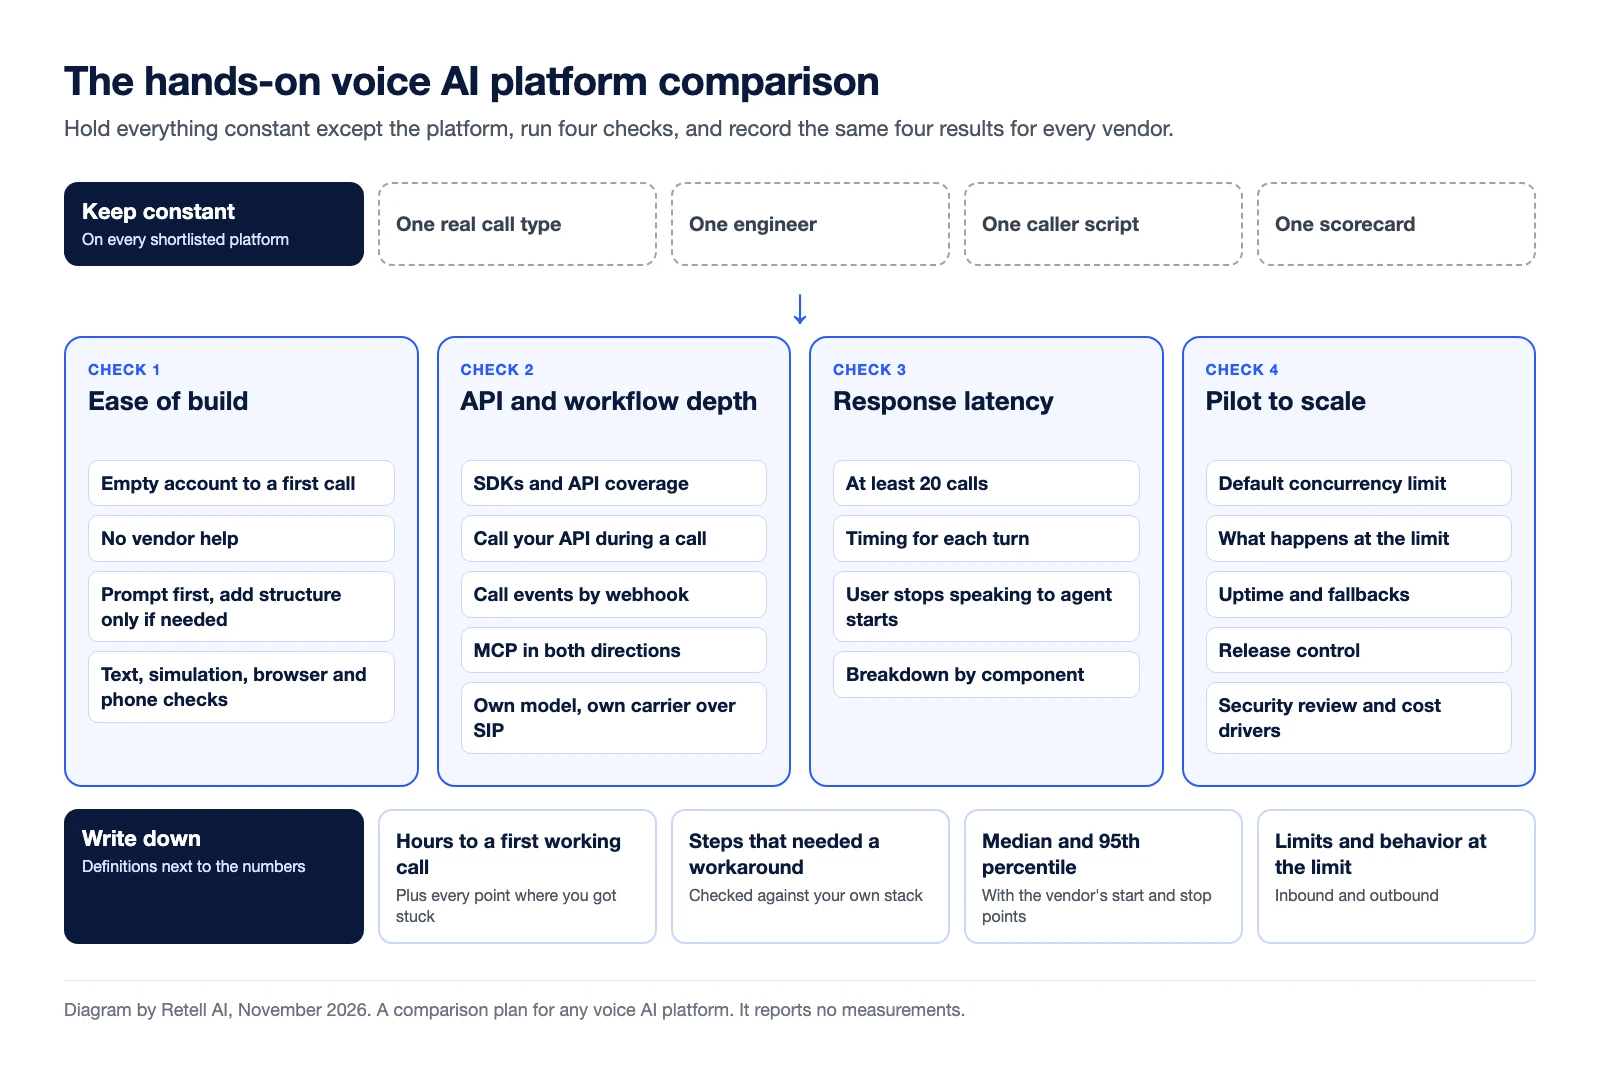
Schreiben Sie das Anruferskript, bevor jemand mit dem Aufbau beginnt. Bauen Sie eine Unterbrechung, eine Korrektur, eine Frage, die der Agent ablehnen sollte, und eine Anfrage ein, die Ihre API benötigt. Vergleichen Sie dann die vier Ergebnisse nebeneinander, mit den Definitionen jedes Anbieters neben seinen Zahlen.
Nach der Entscheidung muss jemand für den Agenten verantwortlich sein. Viele Teams übertragen diese Aufgabe einem CX Engineer, auch CX Automation Engineer oder Internal Deployed Engineer genannt: die interne verantwortliche Person, die schlecht bearbeitete Anrufe findet, Korrekturen baut, sie prüft und bereitstellt. Wenn Sie diese Person bereits haben, beziehen Sie sie in den Vergleich ein. Was der Executive Sponsor von Plattform und Anbieter braucht, behandelt Was CX-Verantwortliche von KI-Sprachagenten brauchen.
Häufig gestellte Fragen
Worauf sollte ein Produktteam bei einer Sprach-KI-Plattform achten?
Auf vier Dinge, alle praktisch geprüft: wie schnell Ihr eigener Engineer einen ersten funktionierenden Agenten bauen kann, wie weit API, Webhooks und Workflow-Tools reichen, wie lange Anrufende bei Ihren eigenen Anrufen auf eine Antwort warten und wie Limits und Fehlerverhalten bei Produktionsvolumen aussehen. Führen Sie auf jeder Plattform der engeren Auswahl dieselben Prüfungen durch.
Wie vergleicht man Sprach-KI-Plattformen in der Praxis?
Wählen Sie einen echten Anruftyp, lassen Sie eine Person aus dem Engineering auf jeder Plattform denselben Aufbau umsetzen und führen Sie auf jeder dieselben geskripteten Anrufe durch. Halten Sie die Stunden bis zum ersten funktionierenden Anruf fest, die Schritte, die einen Workaround erforderten, Median und 95. Perzentil der Antwortzeit sowie die Standardlimits. Behalten Sie die Definitionen jedes Anbieters neben seinen Zahlen.
Was ist eine gute Antwortlatenz für einen KI-Sprachagenten?
Das hängt vom Modell, vom Prompt und von den Einstellungen ab, messen Sie sie also bei Ihren eigenen Anrufen. Die Dokumentation von Retell nennt eine Latenz von nur 600 ms, gemessen vom Moment, in dem Nutzende aufhören zu sprechen, bis der Agent zu antworten beginnt, und rät, die geschätzte Latenz unter 1,5 Sekunden zu halten. Vergleichen Sie Perzentile zwischen Anbietern nur, wenn Start- und Endpunkte übereinstimmen.
Braucht man Engineers, um einen KI-Sprachagenten zu erstellen?
Nicht für einen ersten Agenten. Der Quick Start von Retell führt im Dashboard von einer Vorlage bis zu einem Telefonanruf. Engineers kommen ins Spiel, wenn der Agent während eines Anrufs Ihre API aufrufen, Anruf-Events an Ihre Systeme senden oder sich über SIP mit Ihrem eigenen Telefonanbieter verbinden muss. Genau diese Teile sollte ein Produktteam während des Vergleichs bauen.
Wie viele gleichzeitige Anrufe kann eine Sprach-KI-Plattform verarbeiten?
Das hängt vom Tarif und vom Anbieter ab. Bei Retell erhält ein Workspace mit nutzungsbasierter Abrechnung standardmäßig 20 gleichzeitige Anrufe, und das Limit lässt sich im Dashboard erhöhen. Fragen Sie jeden Anbieter, was mit einem eingehenden und einem ausgehenden Anruf passiert, sobald das Limit erreicht ist.
Führen Sie die vier Prüfungen mit Ihren eigenen Anrufen durch
Die Retell AI ist eine Plattform für KI-Sprachagenten für Contact Center, mit Single-Prompt- und Conversation-Flow-Agenten, typisierten SDKs, Custom Functions, Webhooks, MCP, benutzerdefinierter Telefonie und Latenzdaten pro Anruf. Mehr als 4.000 Kunden führen über Retell mehr als 100 Millionen Anrufe pro Monat durch, und Retell hat im November 2026 eine annualisierte Run Rate von 100 Mio. $ erreicht. Die Preise sind nutzungsbasiert, ab 0,07 $ pro Minute laut Preisseite. Bauen Sie denselben Agenten, den Sie anderswo gebaut haben, testen Sie ihn mit Ihren eigenen Anrufen und vergleichen Sie die Zahlen, bevor Sie etwas unterschreiben.
Sehen Sie, wie viel Ihr Unternehmen durch den Wechsel zu KI-gestützten Sprachagenten sparen könnte.
ROI-Ergebnis
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Revolutionieren Sie Ihren Anrufbetrieb mit Retell


