De lat voor het kopen van voice-AI is verschoven: van natuurlijke spraak naar snel en veilig itereren




Evaluatiecriteria voor voice-AI zijn de tests waarmee een koper bepaalt of een platform voor AI-stemagents standhoudt op de eigen telefoonlijnen. Natuurlijk klinkende spraak was vroeger de beslissende test. Nu is het de instapdrempel. Zodra elke leverancier op de shortlist goed klinkt in een gesprek, is de beslissende vraag hoe snel je team de agent kan aanpassen, en hoe veilig.
In aankoopgesprekken duikt een patroon op. De eerste evaluatieronde vergelijkt stemmen, latency en onderbrekingen. De tweede ronde vraagt wat er gebeurt op dag 40, als een beleid verandert, een uitgaande campagne een nieuw script nodig heeft of er een nieuwer model uitkomt. Een leverancier die die vragen niet kan beantwoorden met een live demo van het wijzigingsproces, verkoopt de lancering en laat de operatie aan jou over.
Retell AI publiceert deze gids en verkoopt een platform voor AI-stemagents. De vragen werken voor elke leverancier, ook voor ons, en we geven aan waar onze eigen gedocumenteerde antwoorden grenzen hebben.
Waarom is natuurlijke spraak niet langer genoeg om een leverancier te kiezen?
Omdat stemkwaliteit de eerste week van het leven van een agent bepaalt, en wijzigingen de rest. Je moet nog steeds controleren of de agent goed klinkt in jouw gesprekken: hoe je een platform voor stemagents evalueert vóór de livegang behandelt latency, onderbrekingen, transcriptie en doorverbindingen in een pilot. Maar een stemagent is nooit af. Bellers formuleren dingen die je scripts niet hadden voorzien, prijzen en beleid veranderen, en er komen nieuwe soorten gesprekken bij.
Elk van die wijzigingen is een productierelease op een telefoonlijn, waar een slechte zin een live beller bereikt voordat iemand het transcript leest. Daarom bestaat de lat uit twee delen, snelheid en veiligheid, en daarom moet je beide scoren.
Softwareteams meten oplevering al op deze manier. DORA, een onderzoeksprogramma van Google Cloud, splitst de prestaties van softwareoplevering op in doorvoer en instabiliteit: hoe snel wijzigingen productie bereiken en hoe vaak ze een rollback of hotfix nodig hebben. DORA meldt dat "snelheid en stabiliteit geen afwegingen zijn" en dat de metrics bij de meeste teams gecorreleerd zijn. Een leverancier zou je niet moeten laten kiezen tussen de agent snel aanpassen en hem veilig aanpassen.
Op welke wijzigingen moet je een leverancier scoren?
Scoor de wijzigingen die je echt gaat doorvoeren, niet een algemene score voor "gebruiksgemak". Elk type wijziging brengt een ander risico met zich mee, dus vraag naar elk type afzonderlijk.
| Wijziging | Voorbeeld | Zo ziet snel eruit | Zo ziet veilig eruit |
|---|---|---|---|
| Prompttekst | Het terugbetalingsbeleid herformuleren | De eigenaar van je agent past het aan zonder engineer | Een genummerde versie, een zichtbare diff en een testrun voordat bellers het horen |
| Kennisinhoud | Nieuwe prijslijst of openingstijden | De bron één keer bijwerken | Je weet wanneer de update live antwoorden bereikt |
| Gespreksflow | Een vertakking toevoegen voor een nieuwe belreden | De flow aanpassen in de builder | Gedeelde onderdelen veranderen andere agents niet onverwacht |
| Model | Overstappen op een nieuwere of goedkopere LLM | Geen prompt herschrijven | Dezelfde testsuite draait op beide modellen vóór de overstap |
| Uitgaande campagne | Nieuw script halverwege de campagne | De agentversie wisselen die de campagne gebruikt | Een concept kan niet per ongeluk live belpogingen bereiken |
| Stem of begroeting | Nieuwe stem of openingszin | Aanpassen in de instellingen | Iemand hoort het in een gesprek vóór de release |
De rest van deze gids zet die tabel om in vragen. Voor het praktische releaseproces zodra je een platform hebt gekozen, zie hoe je wijzigingen aan stemagents test en uitrolt.
Wat moet je vragen over iteratiesnelheid?
Vraag wie een wijziging kan doorvoeren en hoe lang een echte fix duurt, en laat de leverancier het vervolgens zien.
- Wie in ons team kan de agent aanpassen, en is daar een engineer voor nodig? Het antwoord moet een rol aan jouw kant noemen, niet het serviceteam van de leverancier. Het toegangsbeheer van Retell scheidt rollen die agents kunnen bouwen, testen en bewerken van een Member-rol met alleen-lezenrechten.
- Hoe lang duurt het van een mislukt gesprek tot een fix in live gesprekken? Accepteer geen schatting. Kies een mislukt pilotgesprek, bij voorkeur een dat een bekende faalwijze van stemagents laat zien, en laat je eigen eigenaar het oplossen, controleren en uitrollen terwijl jij toekijkt.
- Kunnen we meer dan één fix tegelijk uitproberen? Met de agentversies van Retell maak je een concept op basis van elke eerdere versie en houd je meerdere concepten tegelijk aan om verschillende benaderingen te proberen.
- Kan een mislukt gesprek een testcase worden zonder dat je die met de hand schrijft? Bij Retell kan Conductor een gesprek uit Call History of AI QA omzetten in een simulatietestcase, inclusief een opzet voor de persona en de succescriteria. De documentatie waarschuwt dat je elke case toch moet controleren en elke functie die een live endpoint bereikt moet mocken.
- Kan de regressiesuite vanuit onze eigen pipeline draaien? De batchtest-API van Retell start een batch en geeft bij polling het aantal geslaagde, mislukte en foutieve tests terug, zodat een CI-job de resultaten kan controleren voordat je uitrolt.
- Betekent een modelwijziging dat je alles moet herschrijven? Voor single- en multi-prompt-agents zegt de documentatie van Retell dat je later van model kunt wisselen zonder je prompt te herschrijven.
- Wat kost itereren? Bij Retell wordt testen gefactureerd tegen productietarieven, per bericht voor teksttests en per minuut voor web- en telefoontests. Neem het op in je budget, want een suite die je je niet kunt veroorloven opnieuw te draaien, wordt niet opnieuw gedraaid.
Wat moet je vragen over iteratieveiligheid?
Vraag hoe een wijziging vóór de release wordt afgeschermd, hoe die na de release wordt blootgesteld en hoe snel die ongedaan kan worden gemaakt.
- Is elke wijziging een vaste versie waar je naar terug kunt? Bij Retell wordt een agentversie in concept na publicatie alleen-lezen, "zodat je een vaste configuratie hebt waar je later naar terug kunt." Het concept wordt uitgelegd bij promptversiebeheer.
- Kunnen we precies zien wat er is veranderd? De versievergelijking van Retell toont twee versies naast elkaar, met diffs op woordniveau voor lange prompttekst en wijzigingen aan gekoppelde kennisbanken en functies.
- Kan een wijziging eerst een paar bellers bereiken voordat iedereen ze krijgt? Het SRE-werkboek van Google definieert canarying als "een gedeeltelijke en in tijd beperkte uitrol van een wijziging in een service en de evaluatie daarvan." Bij Retell verdeelt A/B-testen het inkomende of uitgaande verkeer van een nummer procentueel over agents. Elke agent begint ook met de omgevingstags prod en staging, zodat je staging naar een nieuwe versie kunt laten verwijzen en die eerst op een testnummer kunt bellen.
- Hoe draaien we terug, en volgt elk nummer? Bij Retell zet je de prod-tag terug naar de vorige versie en volgen de nummers op die tag mee. Nummers die rechtstreeks aan een versie zijn toegewezen, blijven op die versie, dus vraag hoe je controleert welke nummers de tag gebruiken.
- Wat vertelt ons dat een wijziging het erger heeft gemaakt? Het analysedashboard van Retell splitst metrics uit per agentversie, alertregels kunnen worden beperkt tot omgevingstags en vergeleken met de vorige cyclus, en AI QA beoordeelt een steekproef van gesprekken op problemen zoals hallucinaties.
Stel daarna de vraag die de meeste evaluaties overslaan: welke wijzigingen omzeilen het releasepad? Elk platform heeft er een paar. Een leverancier die de eigen uitzonderingen benoemt, is makkelijker veilig te gebruiken dan een die beweert dat ze er niet zijn. Dit zijn die van Retell, volgens de documentatie:
- Gedeelde subflows. Een library-subflow wordt gedeeld tussen agents, en een wijziging bereikt elke agent die hem gebruikt, inclusief gepubliceerde versies. De documentatie adviseert om hem vóór publicatie om te zetten naar een lokale subflow als je dat wilt voorkomen.
- Automatisch vernieuwde kennis. Met auto-refresh aan haalt een kennisbank elke 24 uur de URL-bronnen opnieuw op en synchroniseert gewijzigde gekoppelde bestanden opnieuw, dus een wijziging aan een bronpagina kan bij de volgende vernieuwing in antwoorden terechtkomen in plaats van via een nieuwe agentversie.
- Campagnes ingesteld op het nieuwste concept. Een campagnestap kan een vaste versie gebruiken, de nieuwste gepubliceerde versie, een tag of de laatst aangemaakte versie. De Dialer-documentatie waarschuwt voor Latest Created, omdat een concept waar je nog aan werkt dan bij de volgende belpoging live gesprekken bereikt.
Hebben uitgaande campagnes en modelwijzigingen andere vragen nodig?
Ja, omdat beide live gesprekken veranderen op manieren die een promptwijziging niet doet.
Campagnes. Een lopende uitgaande campagne bestaat uit veel toekomstige gesprekken die in de wachtrij staan voor één agent. Vraag welke versie elke belpoging gebruikt en wat je kunt wijzigen zodra de campagne loopt. De Dialer van Retell bepaalt de agentversie bij elke belpoging, niet bij de lancering, dus een vaste versie houdt de agent stabiel tijdens de hele campagne en met Latest Published komen gepubliceerde wijzigingen erin terecht. De sequentie en contactlijst worden bij de lancering vastgezet; om ze te wijzigen moet je de campagne dupliceren. Een pauze stopt nieuwe belpogingen binnen ongeveer een minuut, terwijl gesprekken die al zijn opgezet gewoon worden afgerond.
Modellen. Een modelwijziging kan tegelijk de formulering, tool calls en timing veranderen. Vraag of dezelfde testsuite op het oude en het nieuwe model kan draaien, en of je een snel back-upmodel kunt gebruiken. Voor stemagents op door Retell beheerde modellen bieden de LLM-instellingen van Retell een snel fallbackmodel dat naast het primaire model draait, en de documentatie adviseert om vóór het uitrollen te controleren of beide modellen de instructies volgen en tools correct aanroepen. Ook staat erin dat je instructies en tool calls opnieuw moet testen na het wijzigen van de temperature.
Hoe scoor je leveranciers op snel en veilig itereren?
Voer tijdens de pilot op elk platform op de shortlist dezelfde vier oefeningen uit, waarbij de persoon die de agent gaat beheren het werk doet, en neem van elke oefening de tijd op.
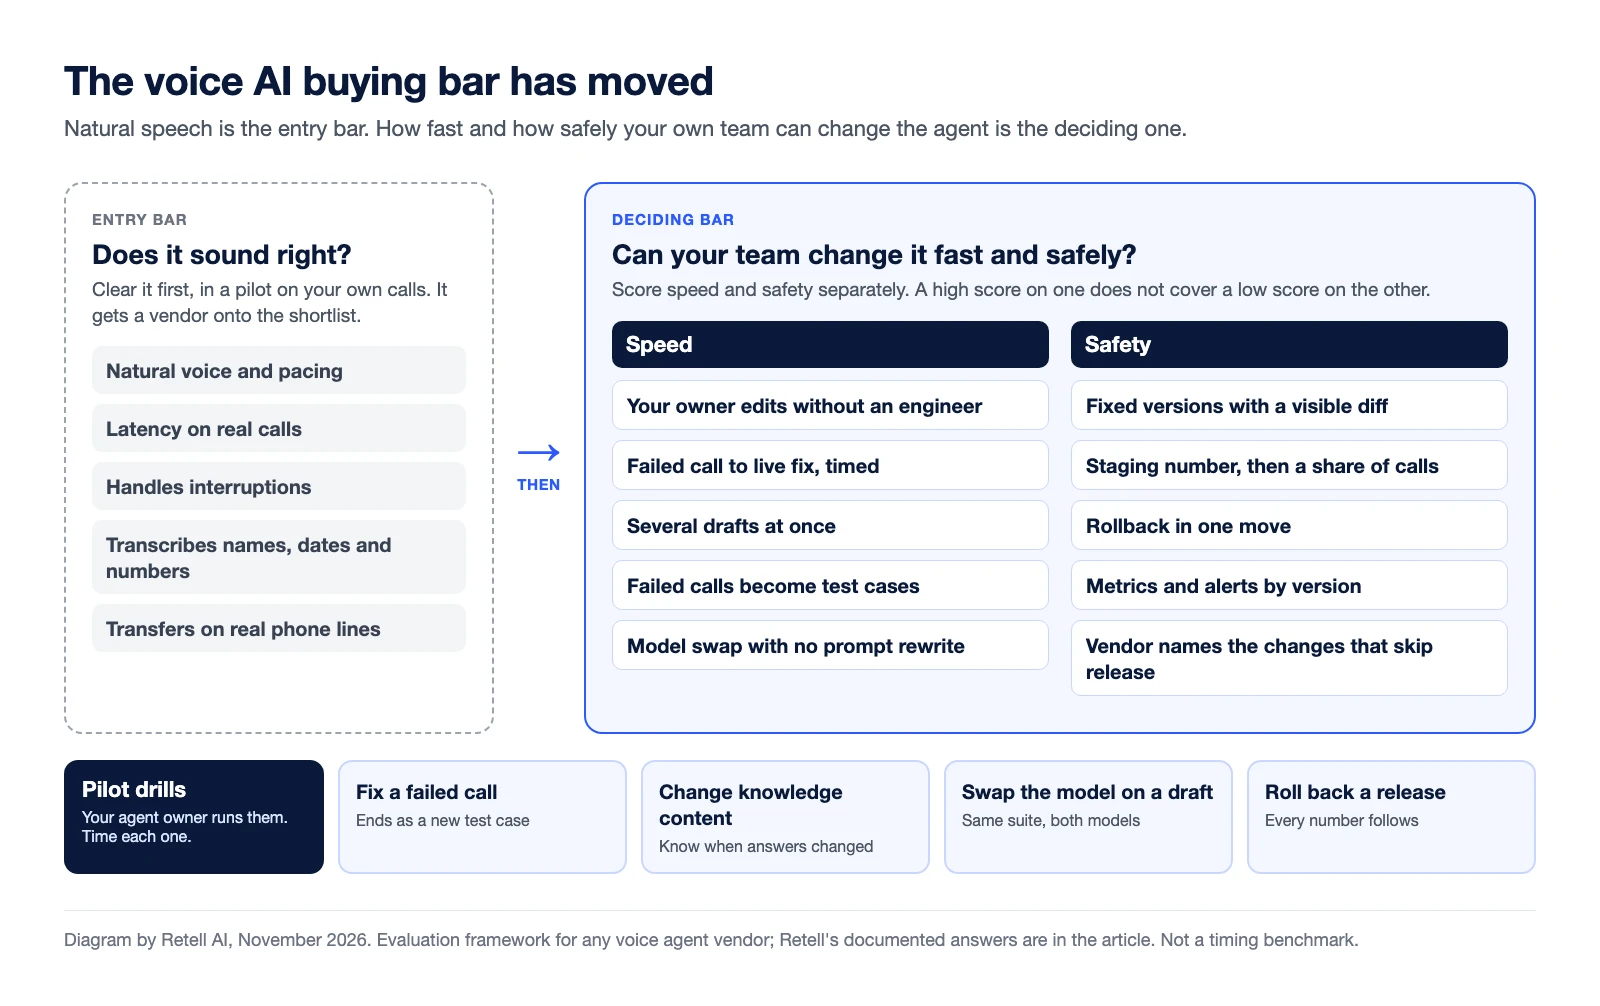
| Oefening | Wat je vastlegt | Een geslaagd resultaat |
|---|---|---|
| Een mislukt gesprek oplossen | Tijd van het vinden van het gesprek tot de fix draait op een stagingnummer | Je eigenaar doet het zonder hulp van de leverancier, en het mislukte gesprek is nu een testcase |
| Kennisinhoud wijzigen | Wanneer de wijziging live antwoorden bereikte, en hoe je dat hebt bevestigd | Je kunt zeggen welke gesprekken de oude inhoud hoorden en welke de nieuwe |
| Het model in een concept wisselen | Slagingspercentage van dezelfde testsuite op beide modellen | De suite draait opnieuw zonder herschrijven, en het resultaat bepaalt de overstap |
| Een slechte release terugdraaien | Tijd van het besluit tot elk productienummer op de vorige versie staat | Eén handeling, en je kunt laten zien welke nummers meegingen |
Scoor snelheid en veiligheid apart, elk van één tot vijf, en laat een hoge score op het ene een lage score op het andere niet verbergen. Een platform waar fixes binnen een uur live gaan maar niet kunnen worden teruggedraaid, zakt. Net als een platform waar elke wijziging veilig is maar een ticket bij de leverancier vereist. Het eigen advies van DORA om beide tegelijk te verbeteren is om elke wijziging klein te houden: "Kleinere wijzigingen zijn ook makkelijker te herstellen als er iets misgaat."
Twee andere pagina's behandelen aanverwante beslissingen. Of je bouwt, koopt of een managed service gebruikt, bepaalt wie deze oefeningen überhaupt uitvoert; zie bouwen of kopen bij AI-stemagents. De financiële onderbouwing van het programma staat in de ROI van AI-stemagents. Deze scorecard gaat ervan uit dat beide vastliggen en vraagt alleen of je team de agent kan blijven verbeteren. Welke gesprekken je als eerste automatiseert, is een aparte beslissing, behandeld in hoe je use cases voor voice-AI kiest.
Veelgestelde vragen
Wat zijn de belangrijkste criteria bij het evalueren van een voice-AI-platform?
Begin met de vraag of het je workflow afrondt in je eigen gesprekken, aansluit op je telefonie- en datasystemen en natuurlijk klinkt. Zodra leveranciers op de shortlist daaraan voldoen, is iteratie het criterium dat ze onderscheidt: hoe snel je team prompts, kennis, flows, campagnes en modellen kan aanpassen, en hoe veilig die wijzigingen live bellers bereiken.
Hoe test je hoe snel een leverancier je een stemagent laat aanpassen?
Kies een mislukt gesprek uit de pilot en vraag de persoon die de agent gaat beheren om het op te lossen, te controleren, uit te rollen naar een testnummer en terug te draaien, terwijl jij de tijd opneemt. Herhaal dit met een kenniswijziging en een modelwissel in een concept. Een opgenomen demo door medewerkers van de leverancier zelf telt niet.
Wat maakt een wijziging aan een stemagent veilig?
Een veilige wijziging is een vaste versie met een zichtbare diff, slaagt vóór de release voor een opgeslagen testsuite, bereikt eerst een klein deel van de gesprekken en kan in één handeling worden teruggedraaid. Je moet ook weten welke wijzigingen dat pad overslaan, zoals gedeelde componenten of automatisch vernieuwde kennis.
Wie moet de iteratie-oefeningen tijdens een pilot uitvoeren?
De persoon die de agent na de lancering gaat beheren, niet het team van de leverancier. Sommige teams geven die taak aan een CX-automatiseringsengineer, de interne eigenaar die slecht afgehandelde gesprekken opspoort, fixes bouwt, controleert en uitrolt.
Kun je het taalmodel achter een stemagent wisselen zonder die opnieuw te bouwen?
Bij veel platforms kan dat, maar je moet niet blind overstappen. Draai dezelfde testsuite op beide modellen, vergelijk de resultaten en rol het nieuwe model eerst uit naar een deel van de gesprekken. Voor de single- en multi-prompt-agents van Retell zegt de documentatie dat je later van model kunt wisselen zonder je prompt te herschrijven, en dat je moet controleren of een fallbackmodel je instructies volgt en tool calls opnieuw moet testen na het wijzigen van de temperature.
Zet iteratie op je evaluatiescorecard
De aankooplat voor voice-AI is verschoven van "klinkt het menselijk" naar "kunnen we het snel aanpassen zonder gesprekken te breken". Retell is een platform voor AI-stemagents voor contactcenters, met conceptversies, versievergelijking, omgevingstags, simulatie- en batchtests, A/B-verkeersverdeling en AI QA, zodat de persoon die de agent beheert een wijziging kan testen, uitrollen en terugdraaien zonder op een leverancier te wachten. De prijzen werken op basis van betalen naar gebruik, vanaf $0,07 per minuut, op de prijspagina. Neem je lastigste wijziging mee naar de pilot en neem de tijd op.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Een demodemonummer van Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs

Revolutioneer je belactiviteiten met Retell


