Sammanflätat resonerande (interleaved reasoning) är ett sätt att köra en resonemangsmodell där modellen växlar mellan privat resonerande och synliga handlingar, till exempel verktygsanrop eller delar av svaret, i stället för att slutföra allt sitt resonerande innan den svarar.
Det kallas också sammanflätat tänkande (interleaved thinking). Leverantörernas dokumentation använder oftast termen för resonerande mellan verktygsanrop. Forskningsartiklar använder den för en modell som växlar mellan tänkande och delar av sitt svar. Båda beskriver samma förändring: resonerandet är inte längre ett enda block i början av turen.
Vad är en resonemangsmodell?
En resonemangsmodell är en stor språkmodell som genererar mellanliggande resonemang före sitt svar. OpenAI:s guide om resonerande sammanfattar det på en rad: ”Resonemangsmodeller använder interna resonemangstokens innan de producerar ett svar.” Googles Gemini-dokumentation säger att en tänkande modell ”resonerar internt innan den svarar”, och DeepSeeks dokumentation säger att dess tänkarläge producerar chain-of-thought-resonemang ”för att förbättra precisionen i det slutliga svaret”.
Vad är resonemangstokens?
Resonemangstokens, även kallade tänketokens, är de tokens som en modell genererar medan den arbetar sig igenom ett problem. De är inte en del av svaret. Tre egenskaper spelar roll:
- De debiteras. OpenAI säger att resonemangstokens ”debiteras som utdatatokens”. Anthropics dokumentation om tänkande säger samma sak om Claude, ”även när tänketexten inte returneras till dig”. Google prissätter ett svar som ”summan av utdatatokens och tänketokens”.
- De är ofta dolda. OpenAI:s resonemangstokens ”är inte synliga via API:et”. Anthropic säger att det du ser ”aldrig är den råa tankekedjan”. Båda kan returnera en sammanfattning om du ber om en.
- De tar tid och plats. OpenAI säger att en modell kan generera ”allt från några hundra till tiotusentals resonemangstokens” för en enda begäran, och de tar upp plats i kontextfönstret.
Utvecklare styr mängden med en inställning: reasoning effort hos OpenAI, effort hos Anthropic och thinking level hos Google.
Hur skiljer sig sammanflätat resonerande från tänk-först-resonerande?
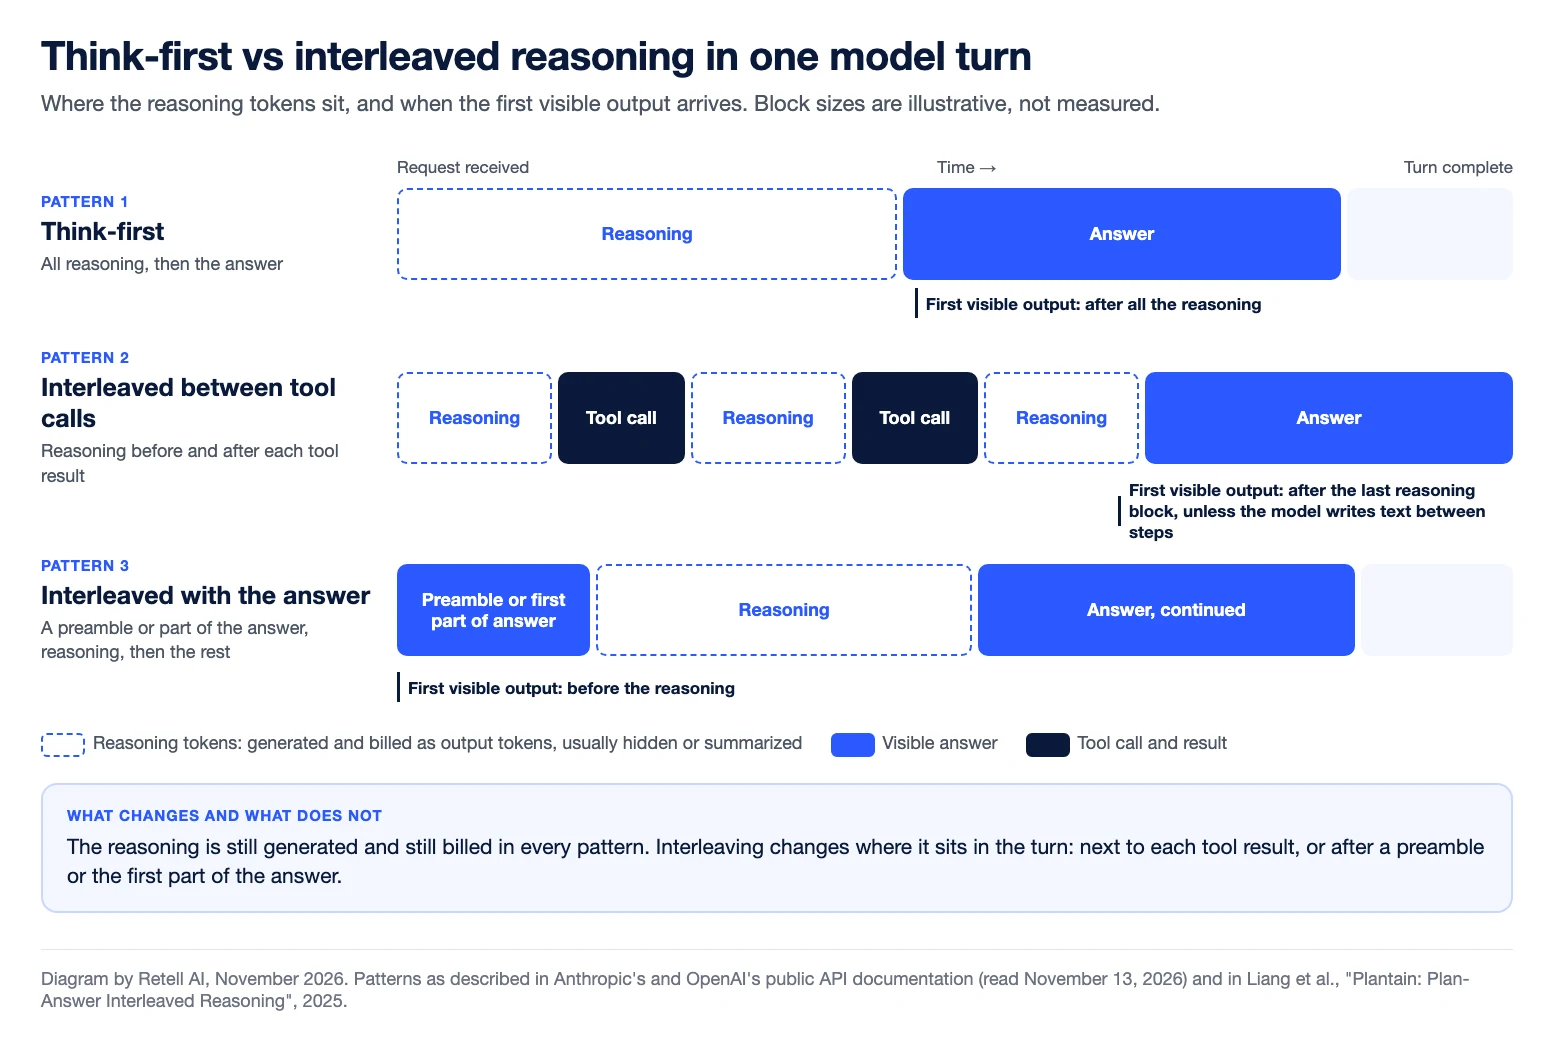
Vid tänk-först-resonerande sker allt resonerande före den första synliga token. Anthropic kallar detta förhandstänkande (up-front thinking): tänkeblocken ”kommer före textblocken”. Sammanflätat resonerande delar upp resonerandet i mindre block och placerar dem där de behövs.
| Mönster | Arbetsordning under en tur | Det första användaren ser | Offentligt beskrivet av |
|---|---|---|---|
| Inget resonerande | Svar | Början av svaret | Alla modeller med resonerande avstängt |
| Tänk först | Allt resonerande, sedan svaret | Ingenting förrän resonerandet är klart | Anthropic (up-front thinking), DeepSeek |
| Sammanflätat mellan verktygsanrop | Resonera, anropa ett verktyg, läs resultatet, resonera igen, svara sedan | Ingenting förrän det sista resonemangsblocket är klart, om inte modellen skriver text mellan stegen | Anthropic, OpenAI, vLLM, DeepSeek (utan termen) |
| Sammanflätat med svaret | En inledning eller del av svaret, resonerande, mer av svaret | En inledning eller en tidig del av svaret | OpenAI, forskningsartiklar |
| Sammanflätat med tal | Svarets första mening, tyst resonerande medan den spelas upp, sedan resten av svaret | Svarets första mening | Tell-1, Retells egen LLM |
Vad dokumenterar leverantörerna i dag?
Läst den 13 november 2026:
- Anthropic. ”Sammanflätat tänkande låter Claude tänka mellan verktygsanrop och resonera kring varje verktygsresultat innan den agerar på det.” Det är automatiskt på modeller som stöder adaptivt tänkande. Modeller med manuellt utökat tänkande kräver en beta-header.
- OpenAI. Modeller som gpt-5.5 ”stöder sammanflätat tänkande, där modellen kan generera synliga utdatatokens före och mellan tänkandet, och kan tänka mellan verktygsanrop”.
- Google. Gemini-sidan om tänkande använder inte termen. Den säger att tankesteg ”visas kronologiskt tillsammans med funktionsanrop, användarinmatningar eller modellutdata”, och att tankesignaturer ”krävs för att bibehålla kontinuiteten i resonerandet över interaktioner med flera turer”.
- vLLM. Inferensservern med öppen källkod stöder sammanflätat tänkande för två modellserier och varnar för att det ”ökar tokenanvändningen och svarslatensen”.
Inom forskningen tränade Xie et al. (2025) modeller ”att sammanfläta tänkande och svarande” och rapporterar att tiden till första token minskade med över 80 % i genomsnitt. Liang et al. (2025) definierar sammanflätat resonerande som en modell som ”växlar mellan att tänka och att visa mellanliggande svar” och rapporterar att deras planera-först-variant, Plantain, minskade tiden till första svar med över 60 %. Båda studerade textuppgifter.
Varför kostar tänk-först-resonerande tystnad i ett telefonsamtal?
I ett telefonsamtal kan talsyntesen inte starta förrän modellen producerar de första orden i sitt svar. Varje resonemangstoken som genereras före de orden är tid då den som ringer inte hör någonting. I ett chattfönster är samma väntan en förloppsindikator. I ett samtal är det tyst luft och ökad latens.
Retells dokumentation om felsökning av latens säger att större, resonemangsinriktade modeller ”är långsammare till första token” och ”byter latens mot förmåga”. OpenAI anger röst som ett vanligt användningsfall för att köra med reasoning effort inställt på none, och föreslår att latenskänsliga applikationer ”ber modellen generera en kort inledning innan den fortsätter med djupare resonerande”. Guiden om bästa LLM för AI-röstagenter går igenom valet av modell.
Vad är sammanflätat resonerande i en röstagent?
I en röstagent innebär sammanflätat resonerande att modellen skriver den första meningen i sitt svar direkt, resonerar tyst medan den meningen talas och sedan fortsätter svaret med stöd i det resonerandet. Den som ringer hör ett sammanhängande svar, och resonerandet uttalas aldrig.
Tell-1 fungerar på det här sättet. Retells tekniska inlägg, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, beskriver formatet som ”en talad inledning, sedan resonerande, sedan resten av svaret”. Inlägget rapporterar i genomsnitt 200 resonemangstokens mitt i svaret, och att 99,98 % av turerna pausar i mindre än 400 ms efter den första meningen.
Jämfört med tänk-först-resonerande behöver den som ringer inte vänta i tystnad på att resonerandet ska bli klart. Inlägget redovisar också avvägningen: ”att tala tidigare innebär att man binder sig till inledningen innan något resonerande har skett”. Tell-1 rankas som nummer 1 totalt på Retell vCX Benchmark (per november 2026).
Vanliga frågor om sammanflätat resonerande
Är sammanflätat resonerande samma sak som sammanflätat tänkande?
Ja, i de flesta sammanhang. Anthropic och OpenAI säger interleaved thinking; forskningsartiklar säger oftast interleaved reasoning.
Debiteras resonemangstokens?
Ja. OpenAI, Anthropic och Google räknar alla in dem i debiterad utdata. OpenAI och Anthropic debiterar dem även när resonemangstexten inte returneras.
Kan du läsa en modells resonemangstokens?
Oftast inte. OpenAI och Anthropic kan returnera en sammanfattning om du ber om en. Ingen av dem returnerar det råa resonerandet.
Får sammanflätat resonerande en modell att svara snabbare?
Inte i sig. Mellan verktygsanrop tillför det tokens, och vLLM:s dokumentation varnar för att det ökar svarslatensen. Den första synliga utdatan kommer tidigare bara när synlig utdata kommer före resonerandet, eller mellan kortare block av det.
Vad är sammanflätat resonerande inom röst-AI?
Det är en modell som börjar tala direkt, resonerar tyst medan dess första mening spelas upp och sedan avslutar svaret med hjälp av det resonerandet. Tell-1, Retells egen LLM, är byggd på det här sättet.
Kör resonemangsmodeller i livesamtal
Retell AI är en plattform för AI-röstagenter för kontaktcenter. Du väljer modellen bakom varje agent. Tell-1 är en av dem. Prata med Retell-teamet.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


