Sessionsaffinitet, även kallat sticky sessions eller sessionsbeständighet, är en lastbalanseringsteknik som skickar varje förfrågan från samma klient eller session till samma backend-server, så att tillstånd som lagras i serverns minne förblir åtkomligt.
Utan den hanteras varje förfrågan för sig. AWS skriver att en Application Load Balancer som standard ”dirigerar varje förfrågan oberoende till ett registrerat mål”, och att funktionen för sticky sessions låter den ”binda en användares session till ett specifikt mål”. Det spelar roll när en server lagrar något lokalt som nästa förfrågan behöver: en inloggningssession, en kundvagn eller en cache.
Hur implementerar lastbalanserare sessionsaffinitet?
En lastbalanserare behöver ett sätt att känna igen sessionen och en regel som kopplar den till en server. Tre metoder täcker de flesta produkter.
Cookie. Lastbalanseraren sätter en cookie i det första svaret och läser den i senare förfrågningar. Den varaktighetsbaserade stickiness-funktionen i AWS använder en cookie som heter AWSALB, med en livslängd som du väljer mellan 1 sekund och 7 dagar. HAProxy använder en cookie för att ”komma ihåg vilken server klienten dirigerades till tidigare”. Klienten måste ha stöd för cookies.
IP-hash. Klientens IP-adress avgör servern. NGINX ip_hash använder ”de tre första oktetterna i klientens IPv4-adress, eller hela IPv6-adressen” som hashnyckel. En Kubernetes Service erbjuder samma idé som sessionAffinity: ClientIP, med en standardtimeout på 3 timmar. Ingen av dem kräver en cookie, men klienter bakom en delad adress hamnar på samma server, och med NGINX gäller det även alla som delar de tre oktetterna.
Konsekvent hashning. Lastbalanseraren hashar en egenskap hos förfrågan, till exempel en header eller ett sessions-ID, till en ring av servrar. Envoy skriver att med en väl partitionerad ring kommer tillägg eller borttagning av en värd i en uppsättning av N ”endast att påverka 1/N förfrågningar”. NGINX-direktivet hash har ett consistent-alternativ som enligt dokumentationen ”hjälper till att uppnå en högre cacheträffgrad för cachande servrar”.
| Metod | Vad som identifierar sessionen | Dokumenterat exempel | Huvudsaklig begränsning |
|---|---|---|---|
| Cookie | En cookie som sätts av lastbalanseraren eller applikationen | AWS Application Load Balancer, HAProxy | Klienten måste ha stöd för cookies |
| IP-hash | Klientens IP-adress | NGINX ip_hash, Kubernetes ClientIP | Klienter bakom en delad adress hamnar alla på en server |
| Konsekvent hashning | Valfri egenskap hos förfrågan | Envoy ring hash och Maglev, NGINX hash ... consistent | Varje förfrågan måste ha en stabil nyckel |
| Prefixmedveten routning | De inledande tokens i en LLM-prompt | OpenAI prompt caching, Ray Serve | Belastningen räknas fortfarande, så en upptagen server kan förlora förfrågan |
Vilka är avvägningarna med sticky sessions?
Sessionsaffinitet offrar en del balans och motståndskraft i utbyte mot att tillståndet hålls nära.
- Belastningen kan bli skev. Google Cloud skriver att affinitet ”fungerar bra när det finns en någorlunda stor fördelning av unika anslutningar”. Med få eller ojämna sessioner får vissa servrar bära mer, vilket motverkar skalbarhet.
- En server som fallerar avslutar affiniteten. Om ett mål fallerar på AWS ”väljer lastbalanseraren ett nytt friskt mål” och behåller sessionen där ”även om det fallerade målet kommer tillbaka”. Allt som bara fanns i den gamla serverns minne måste byggas upp igen.
- Det är best effort. Google Cloud tillhandahåller sessionsaffinitet ”enligt best effort-principen” och anger ändringar i hälsokontroller, tillagda eller borttagna backends och fulla backends som händelser som kan bryta den.
HAProxys dokumentation ger standardrådet: ”Ofta är det optimalt att helt undvika sessionsbeständighet genom att bygga dina tjänster tillståndslösa”, till exempel genom att lagra tillstånd i en delad databas. Affinitet är till för det tillstånd du inte kan flytta billigt. En cache är det vanligaste fallet.
Varför spelar sessionsaffinitet roll för LLM-servering?
Det spelar roll eftersom cachen som gör en upprepad prompt billig finns på en enda maskin. En modellserver håller det beräknade tillståndet för en prompt, KV-cachen, i minnet. vLLM återanvänder den när en ny fråga ”delar samma prefix med en av de befintliga frågorna, vilket låter den nya frågan hoppa över beräkningen av den delade delen”.
Det fungerar bara om nästa förfrågan når samma maskin. OpenAI:s guide om prompt caching säger det rakt ut: ”Cachade tillstånd finns på enskilda maskiner”, och ”en förfrågan kan återanvända ett cachat prefix endast om den når en maskin som har en matchande post som inte har gått ut”. OpenAI dirigerar utifrån maskinbelastning, en hash av promptens inledande tokens och, på äldre modeller, en cachenyckel som du anger. För egenhostade modeller levererar Ray Serve en router som ”dirigerar förfrågningar med liknande prefix till samma repliker, vilket maximerar träffgraden i KV-cachen”, och som faller tillbaka på vanlig lastbalansering när köerna är ojämna.
Telefonsamtal passar det här mönstret väl. Vid varje tur i en konversation med flera turer skickar en röstagent sina instruktioner plus transkriptionen hittills till den stora språkmodellen, eftersom modellen inte behåller samtalet mellan förfrågningarna. Varje förfrågan upprepar större delen av den föregående. Samtalet är alltså sessionen och samtals-ID:t en naturlig nyckel. En tur som hamnar på en annan server bearbetar hela prompten igen, vilket ökar latensen.
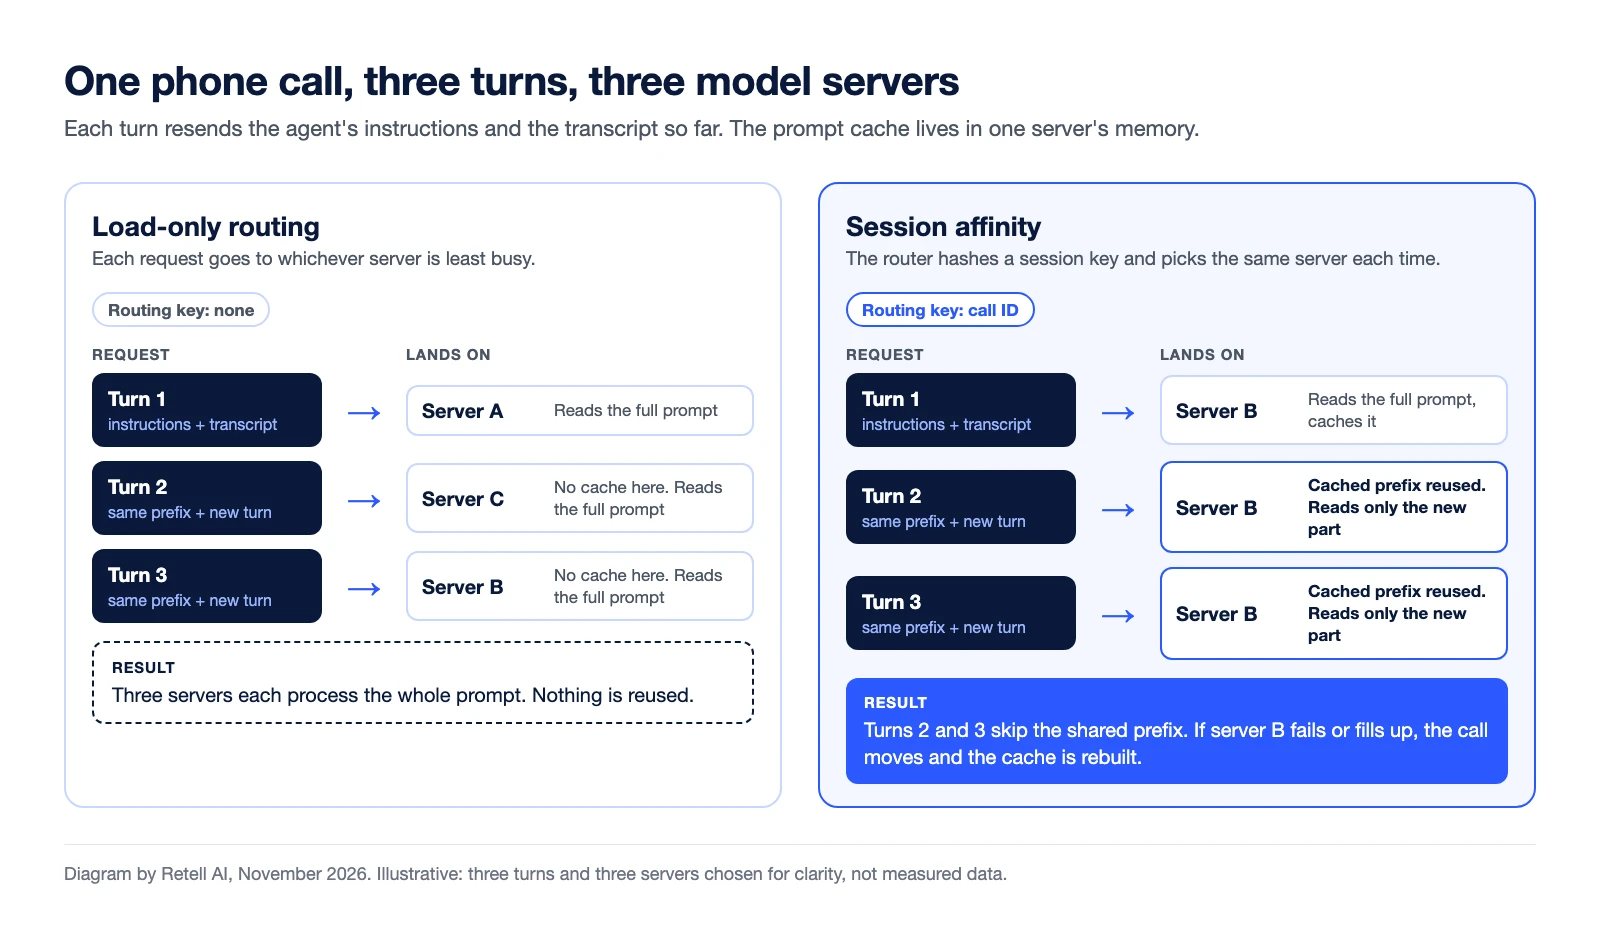
Tell-1, den LLM som Retell själva har utvecklat, körs på det här sättet. Det tekniska inlägget om Retell LLM kallar det samtalsmedveten routning: varje tur skickar om hela konversationen, så varje samtal hålls kvar på de GPU:er som redan har det i cache. Enligt inlägget höjde det andelen prompttokens som serverades från cache från 36 % till 69 %.
Där sessionsaffinitet dyker upp i Retell
Det blir aktuellt när du kör en egen modellserver. Med en anpassad LLM ”öppnar Retell en WebSocket till din server för varje samtal”, med samtals-ID:t som sista segment i URL:ens sökväg. AWS påpekar att ”WebSocket-anslutningar är sticky av naturen”, så ett samtal stannar på en av dina servrar medan dess socket är öppen.
Bästa praxis från Retell rekommenderar att du håller ”explicit tillstånd per samtal på din server, med samtals-ID:t från WebSocket-URL:en som nyckel”. Retell återupprättar också en anslutning som bryts mitt i ett samtal, och om du kör flera servrar bakom en lastbalanserare kan den nya socketen hamna på en annan server. För att hålla tillståndet åtkomligt kan du dirigera på samtals-ID:t i sökvägen, eller lagra tillståndet i ett delat lager. IP-hash sprider inte belastningen här: installationsguiden anger en enda utgående IP-adress för den här anslutningen, så varje samtal hashas till samma server.
Vanliga frågor om sessionsaffinitet
Är sessionsaffinitet samma sak som sticky sessions?
Ja. AWS beskriver sin funktion för sticky sessions som ”även känd som sessionsaffinitet”. Sessionsbeständighet är ett tredje namn för samma sak.
Vad händer med en sticky session när servern fallerar?
Lastbalanseraren väljer en annan frisk server och sessionen fastnar där. Tillstånd som bara fanns i den fallerade serverns minne går förlorat om det inte också lagrades någonstans delat.
Behöver WebSocket-anslutningar sticky sessions?
Inte medan anslutningen är öppen, eftersom varje meddelande går över samma anslutning till samma server. Affinitet blir viktig igen när klienten återansluter.
Varför spelar sessionsaffinitet roll för prompt caching?
En promptcache ligger i minnet på den maskin som byggde den. En uppföljande förfrågan får det cachade prefixet bara om den dirigeras till den maskinen.
Använd din egen modell i livesamtal
Retell AI är en plattform för AI-röstagenter för kontaktcenter. Retell hanterar telefoni, transkribering, turtagning och tal, och integrationen för anpassad LLM kopplar din modellserver via en WebSocket per samtal.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


