Prompt caching är en teknik som låter en stor språkmodell hoppa över arbete den redan har gjort. När en ny förfrågan börjar med samma tokens som en tidigare återanvänder modellen den sparade beräkningen för den gemensamma början och bearbetar bara det som är nytt. Resultatet blir en snabbare första token och, hos de flesta API:er, ett lägre pris för de återanvända tokens.
Den återanvända delen kallas prefix. OpenAI:s guide definierar det som ”de oförändrade tokens i början av en prompt”. Där ligger oftast instruktioner, verktygsdefinitioner och tidigare turer i konversationen.
Hur fungerar prompt caching?
Anthropics dokumentation beskriver förloppet. Systemet kontrollerar om ett promptprefix redan finns i cachen från en nyligen gjord förfrågan. Om det gör det används den cachade versionen. Annars bearbetas hela prompten och prefixet cachas.
Tre regler följer av den designen:
- Matchningen måste vara exakt. Anthropic anger att cacheträffar kräver ”100 procent identiska promptsegment”. Ett enda ändrat tecken tidigt i prompten innebär att allt efter det bearbetas på nytt.
- Ordningen spelar roll. Stabilt innehåll kommer först och föränderligt innehåll sist.
- Poster löper ut. Anthropics standardlivslängd för cachen är 5 minuter, och den förnyas varje gång det cachade innehållet används. OpenAI:s livslängder beror på modellen.
Hur hänger prompt caching, prefix caching och KV-cachen ihop?
Det är tre lager av samma idé. KV-cachen är själva datan. Prefix caching är återanvändningen av den datan mellan förfrågningar. Prompt caching är namnet som API-leverantörer ger funktionen.
| Term | Vad det är | Omfattning | Var du ser termen |
|---|---|---|---|
| KV-cache | De nyckel- och värdetillstånd som en modell beräknar för varje token den har läst. De sparas så att de inte behöver beräknas om för varje ny token. | Inom en förfrågan | Modellens interna delar, inferensmotorer |
| Prefix caching | KV-cachen behålls efter att en förfrågan har avslutats och återanvänds för en senare förfrågan som börjar med samma tokens. | Mellan förfrågningar på samma server | Inferensmotorer som vLLM |
| Prompt caching | Prefix caching som erbjuds som en API-funktion, med regler för livslängd, minsta längd och pris | Mellan API-anrop | Modelleverantörers dokumentation och prissidor |
En förklaring från Hugging Face beskriver KV-cachen enkelt: ”I stället för att beräkna om allt från början återanvänder modellen det den redan har räknat ut”. Enligt vLLM-dokumentationen ”cachar” dess automatiska prefix caching ”KV-cachen för befintliga förfrågningar, så att en ny förfrågan direkt kan återanvända KV-cachen om den delar samma prefix”. OpenAI bekräftar kopplingen från API-sidan: ”Promptcachen lagrar nyckel-värde-tensorer (KV), inte själva tokens.”
Varför spelar prompt caching roll i ett telefonsamtal med flera turer?
En röstagent anropar modellen en gång per tur. Varje förfrågan innehåller instruktionerna, verktygsdefinitionerna och konversationen hittills. I en konversation med flera turer är nästan allt detta identiskt med förfrågan från föregående tur. Bara det senaste utbytet är nytt. Utan cachning läser modellen samma instruktioner igen vid varje tur.
Räkneexempel (illustrativa siffror). En agent har 2 500 tokens med instruktioner och verktyg. Varje tur lägger till 100 tokens konversation, och varje tur efter den första hittar sitt prefix i cachen:
| Tur | Prompttokens | Återanvända från cachen | Nya tokens att läsa |
|---|---|---|---|
| 1 | 2 600 | 0 | 2 600 |
| 2 | 2 700 | 2 600 | 100 |
| 5 | 3 000 | 2 900 | 100 |
| 10 | 3 500 | 3 400 | 100 |
| Alla 10 turer | 30 500 | 27 000 | 3 500 |
Under samtalet kommer 27 000 av 30 500 prompttokens (cirka 89 %) från cachen. Från den andra turen och framåt läser modellen 100 nya tokens i stället för över 2 600.
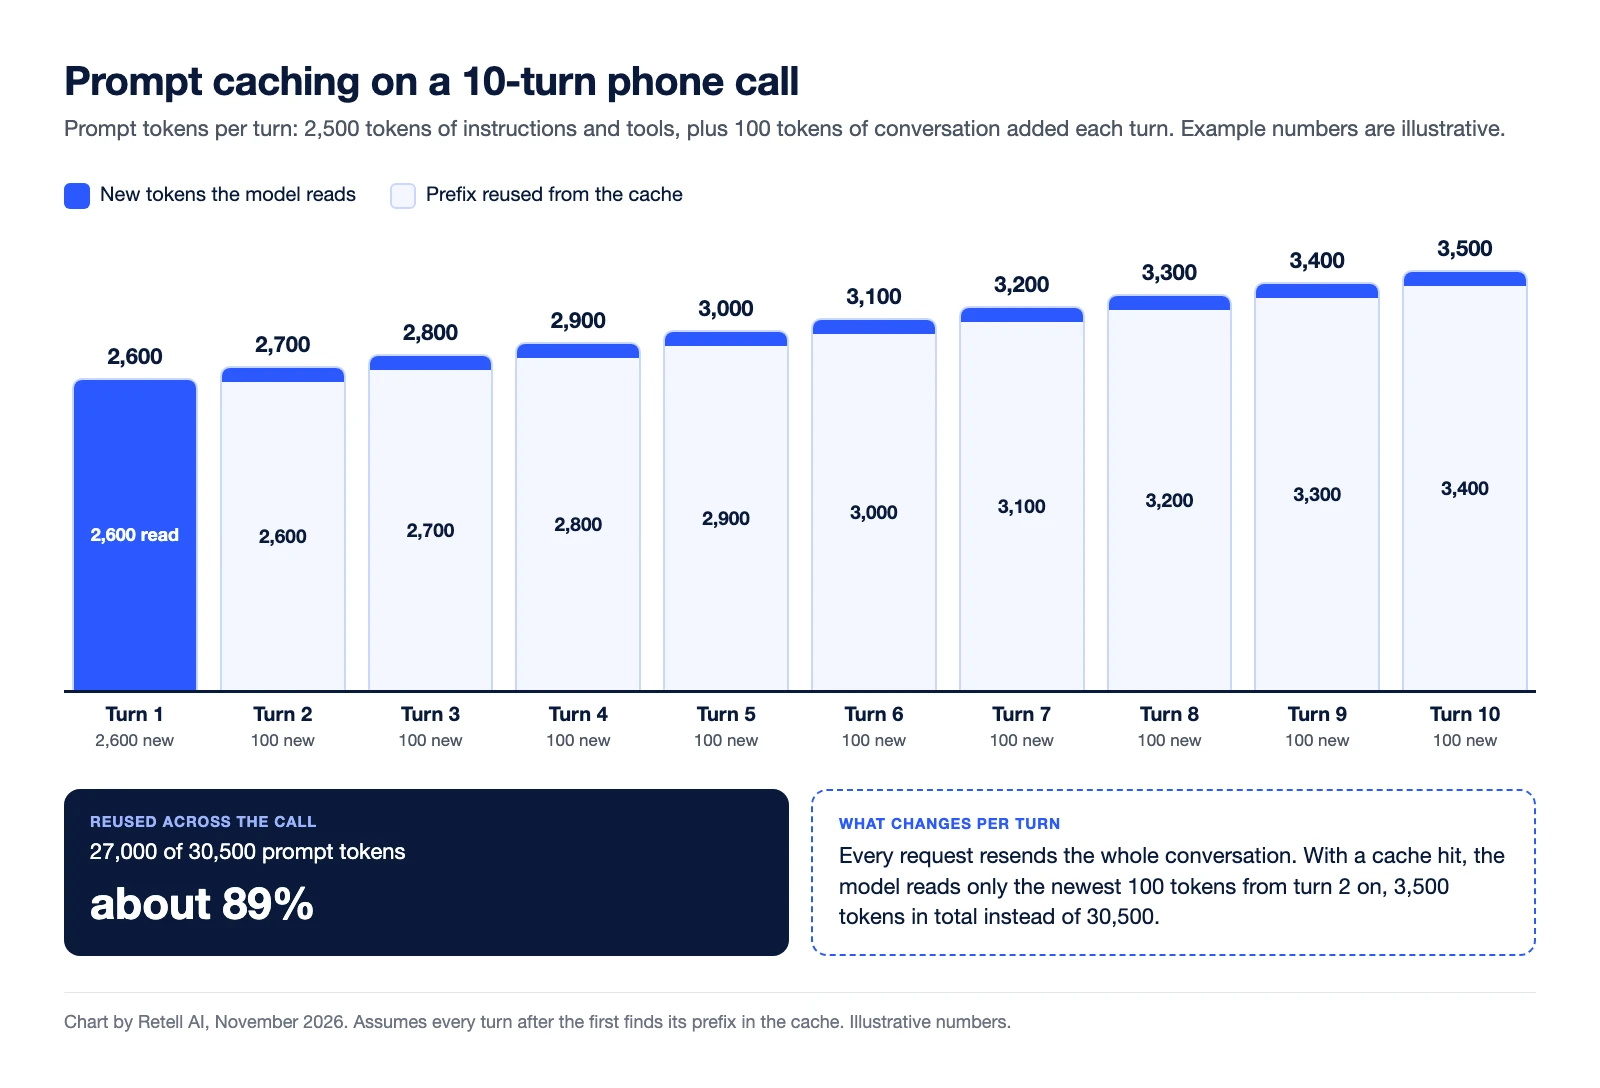
Det spelar roll av två skäl. Det första är tiden till första token. Den är en del av den latens som den som ringer upplever som tystnad, och att läsa en lång prompt tar tid. Det andra är kostnaden. Anthropic prissätter cacheläsningar till 0,1 gånger baspriset för input-tokens. Cacheskrivningar kostar 1,25 gånger baspriset vid livslängden på 5 minuter.
Vad hindrar en cacheträff?
- Ett ändrat prefix. En tidsstämpel, namnet på den som ringer eller en omordnad verktygslista nära början av prompten ändrar varje token efter den.
- Ett uppehåll som är längre än cachens livslängd.
- Förfrågan hamnar på en annan maskin. OpenAI:s guide påpekar att ”cachade tillstånd finns på enskilda maskiner”. En förfrågan kan återanvända ett prefix ”endast om den når en maskin som har en matchande post som inte har löpt ut”.
Routning kan täppa till den sista luckan. Tell-1, den egna LLM:en från Retell, använder sessionsaffinitet för att hålla varje samtal på de GPU:er som redan har det i cachen. Det framgår av det tekniska inlägget om Retell LLM att detta nästan fördubblar andelen prompttokens som hämtas från cachen, från 36 % till 69 %. Varje tur har då mindre att läsa in och svaren kommer snabbare.
Cachning ändrar inte svaret. Enligt designanteckningarna för vLLM ”ändrar” prefix caching ”inte modellens utdata”.
Där AI-röstagenter kommer in
Felsökningsguiden för latens från Retell anger kostnaden för promptlängd direkt: ”Varje token i din prompt ökar tiden till första token, och den kostnaden betalas vid varje tur i konversationen.”
Du kan ansluta din egen modell via LLM WebSocket från Retell. Då innehåller varje svarsförfrågan den ”fullständiga livetranskriptionen som samlats in i samtalet hittills”. Din server bygger prompten, så cachebeteendet beror på hur du bygger den och på din modelleverantör. Lägg instruktioner och verktyg först och håll dem oförändrade. Lägg sedan till transkriptionen efter dem. Läs mer om hela vägen en tur tar i hur röst-AI i realtid fungerar.
Vanliga frågor om prompt caching
Vad är skillnaden mellan prompt caching och KV-cachen?
KV-cachen är det lagrade attention-tillstånd som en modell bygger upp medan den läser tokens. Prompt caching behåller det tillståndet efter att en förfrågan har avslutats. En senare förfrågan med samma inledande tokens kan då återanvända det.
Är prefix caching samma sak som prompt caching?
Det är samma mekanism. Prefix caching är termen som inferensmotorer använder. Prompt caching är produktnamnet som modelleverantörer använder för den i sina API:er.
Ändrar prompt caching modellens svar?
Nej. Tekniken hoppar bara över att beräkna om det gemensamma prefixet.
Hur länge varar en promptcache?
Det beror på leverantören. Anthropics standard är 5 minuter och förnyas vid varje användning. Det finns också ett alternativ på 1 timme till ett högre skrivpris. OpenAI:s livslängder beror på modellen.
Varför spelar prompt caching roll för röstagenter?
Vid varje tur i ett samtal skickas instruktionerna och konversationen hittills om. Vid en cacheträff läser modellen bara det senaste utbytet.
Hör skillnaden i dina egna samtal
Retell AI är en plattform för AI-röstagenter för kontaktcenter. Tell-1 är plattformens egen LLM, byggd för telefonsamtal. I dokumentationen ser du hur du kontrollerar latensen för varje samtal per komponent. Då ser du hur mycket av väntetiden som beror på modellen. Prata med Retell-teamet.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


