Tid till första token (TTFT) är tiden mellan att du skickar en förfrågan till en stor språkmodell (LLM) och att du tar emot den första token i svaret. Den mäter hur snabbt en modell börjar svara, inte hur lång tid hela svaret tar.
NVIDIA:s benchmarkguide definierar det som ”tiden från att frågan skickas till att den första token tas emot”. I ett telefonsamtal är TTFT en del av den latens som uppringaren hör. Två andra mått bygger på den: tid till första mening och total röstlatens (end-to-end).
Vad ingår i TTFT?
TTFT omfattar allt som sker innan modellen strömmar sin första token. IBM listar fyra delar: kötid, prefill-tid (bearbetning av prompten), generering av första token samt nätverks- och API-overhead.
IBM kallar prefill ”ofta den största bidragande faktorn till TTFT, särskilt vid längre prompter”. Modellen läser hela prompten innan den skriver något, så en längre prompt innebär längre väntan. Belastningen spelar också roll. Anyscales dokumentation påpekar att en server under hög belastning kan köa inkommande förfrågningar, och den väntetiden läggs till TTFT.
Hur mäter du TTFT?
- TTFT = tidpunkten då första token tas emot minus tidpunkten då förfrågan skickas
Tre val påverkar resultatet. Ange dem tillsammans med varje TTFT-värde:
- Var klockan sitter. Mätt hos klienten inkluderar TTFT nätverkstid. Mätt inuti modellservern gör den inte det.
- Vilken percentil. Medianen (P50) visar den typiska förfrågan. P90 och P99 visar de långsamma.
- Hur hög belastning. En enda förfrågan på en ledig server är bästa fallet. I produktion, påpekar NVIDIA, kan en förfrågans prefill överlappa en annans generering.
Hur skiljer sig TTFT, tid till första mening och total latens åt i ett telefonsamtal?
TTFT stannar vid första token. Tid till första mening stannar när en hel mening har kommit fram. Total röstlatens täcker hela pausen som uppringaren hör.
En uppringare hör aldrig en token. Bästa praxis för anpassad LLM från Retell säger: ”Retell börjar tala så snart den har din första fullständiga mening.” Det värde som spelar roll där är ”tid till första token plus tiden det tar att slutföra den första meningen”.
Latensdokumentationen från Retell mäter total latens ”från att användaren slutar prata till att agenten börjar prata”.
| Mått | Klockan startar | Klockan stannar | Utelämnar |
|---|---|---|---|
| Tid till första token (TTFT) | Förfrågan skickas till LLM:en | Första token tas emot | Resten av första meningen, taligenkänning, talsyntes |
| Tid till första mening | Förfrågan skickas till LLM:en | Första fullständiga mening tas emot | Taligenkänning, talsyntes, telefoni |
| Total röstlatens (end-to-end) | Uppringaren slutar prata | Agenten börjar prata | Inget i kedjan. Kontrollera om värdet räknar med nätverkssträckan till uppringaren |
En namnfälla: inom LLM-benchmarking löper end-to-end-latens till sista token. NVIDIA definierar den som ”hur lång tid det tar från att en fråga skickas till att hela svaret tas emot”.
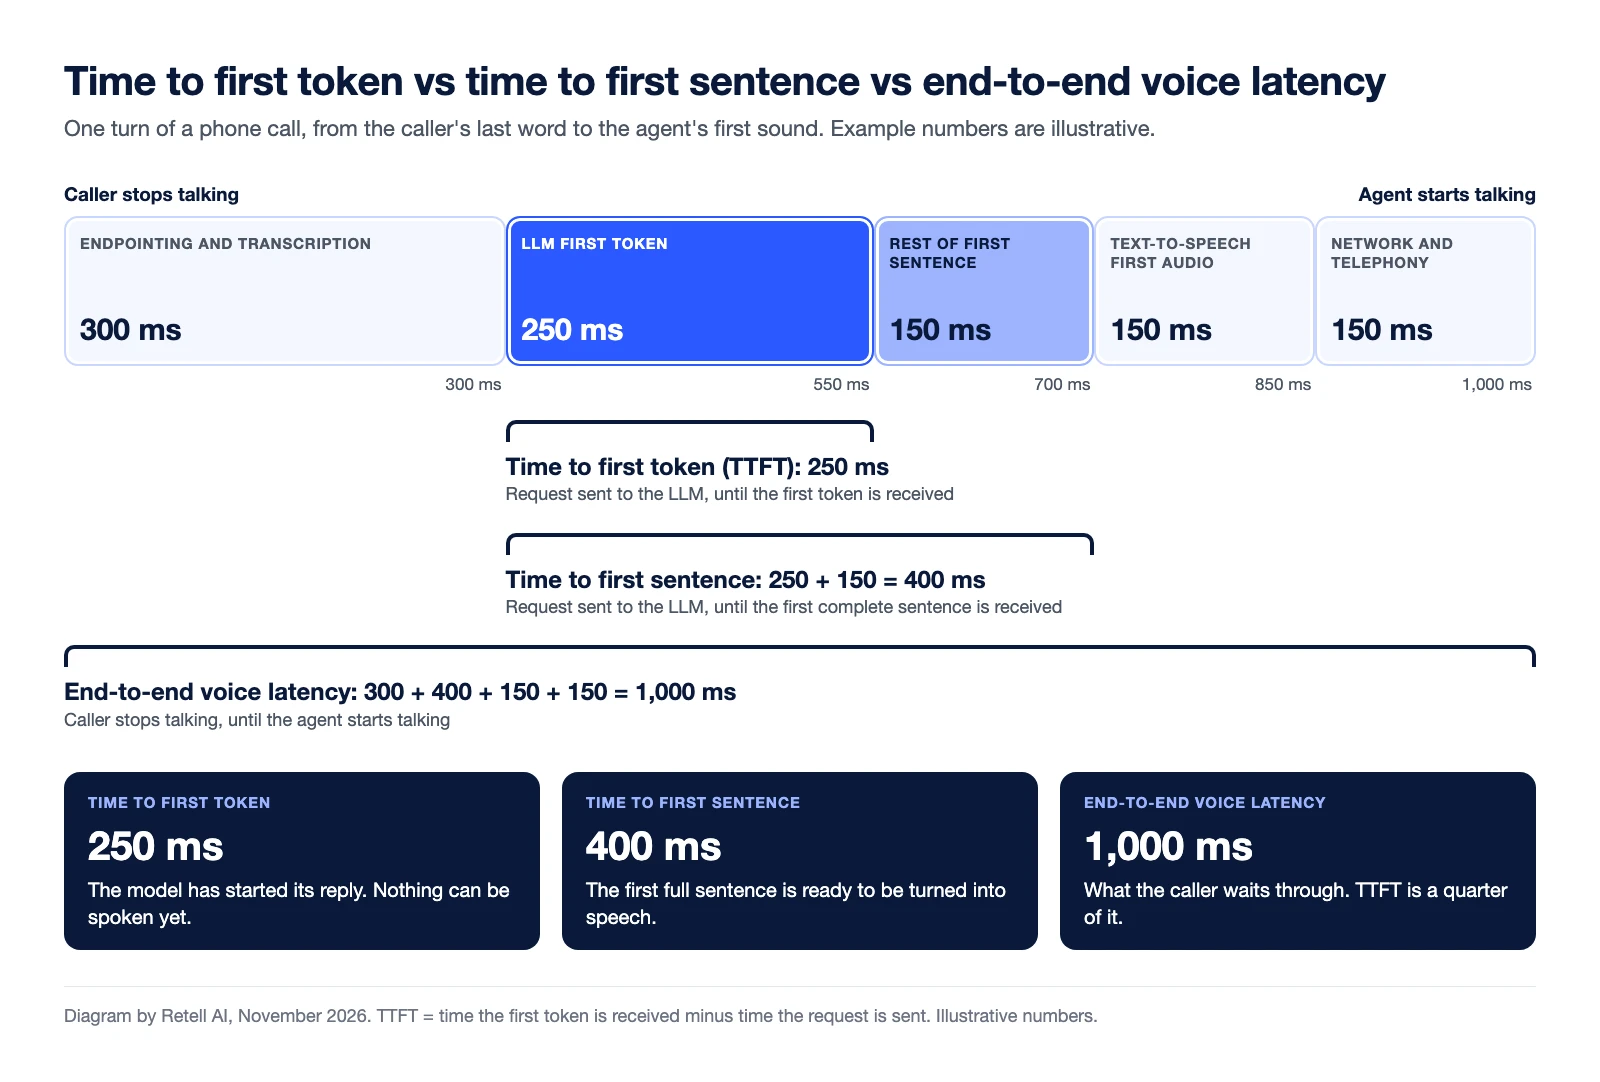
Räkneexempel (illustrativa siffror). En tur i ett samtal:
- Endpointing och transkribering: 300 ms
- Första token från LLM: 250 ms
- Resten av första meningen: 150 ms (15 tokens till à 10 ms)
- Första ljud från text-till-tal: 150 ms
- Nätverk och telefoni: 150 ms
TTFT är 250 ms. Tid till första mening är 250 + 150 = 400 ms. Total röstlatens är 300 + 400 + 150 + 150 = 1 000 ms, så TTFT utgör en fjärdedel av uppringarens väntan. Vår guide till latensbenchmarks för röst-AI använder samma budget.
Varför kan TTFT vara missvisande när du jämför modeller?
Ett TTFT-värde går bara att jämföra med ett annat TTFT-värde som mätts på samma sätt. Ställ en modells TTFT mot en annans tid till första mening, så ser den första alltid snabbare ut. Detsamma gäller tid för enbart modellen jämfört med tid mätt i ett livesamtal, och en median jämfört med P99.
En modell kan också skicka sin första token snabbt och sedan strömma långsamt, vilket ändå lämnar uppringaren i tystnad.
Hur sänker du TTFT för en röstagent?
Felsökningsguiden för latens från Retell nämner modellval och promptlängd som de två vanligaste orsakerna till hög latens.
- Välj en snabbare modell. Tell-1 är ett alternativ byggt för samtal. Enligt guiden är större, resonemangsinriktade modeller ”långsammare till första token”.
- Korta ner prompten. ”Varje token i din prompt ökar tiden till första token”, vid varje tur. Prompter över ungefär 8k tokens blir märkbart långsammare.
- Strömma svaret. Med en anpassad LLM ”hamnar hela genereringen i uppringarens tystnad” om du skickar hela svaret i en enda händelse.
Get Call API i Retell returnerar total latens, LLM-latens och text-till-tal-latens för varje samtal vid P50, P90, P95 och P99. LLM-värdet löper ”till den första talbara delen som tas emot”, så det mäter talbar text, inte den första råa token.
Vissa modeller är byggda kring det här måttet. Tell-1, den egna LLM:en från Retell, börjar sitt svar och fortsätter resonera medan den första frasen spelas upp. Den har lägst medianlatens på Retell vCX Benchmark, 76 ms, mätt som rullande 24-timmarsmedian för tid till första mening (avläst 13 november 2026). Det tekniska inlägget om Retell LLM förklarar hur den fungerar, och modelltiden är bara en del av den totala röstlatensen.
Vanliga frågor om tid till första token
Vad är en bra tid till första token?
Det finns ingen enskild standard. Det beror på modellen, promptlängden och serverbelastningen. För en röstagent bör du bedöma den inom det totala värdet. Dokumentationen från Retell föreslår att agentens uppskattade latens hålls under 1,5 sekunder.
Är TTFT detsamma som latens?
Nej. TTFT är LLM:ens fördröjning fram till dess första token. Latens i ett samtal är hela pausen mellan att uppringaren slutar prata och att agenten börjar tala.
Inkluderar TTFT nätverkstid?
Det beror på var den mäts. NVIDIA skriver att TTFT ”i regel inkluderar kötid för förfrågan, prefill-tid och nätverkslatens”. Ett värde för enbart modellen, mätt inuti servern, utelämnar nätverket.
Vad är skillnaden mellan TTFT och tid till första mening?
TTFT stannar vid första token. Tid till första mening stannar när den första fullständiga meningen har kommit fram, vilket är när en röstagent kan börja tala.
Mät latensen i dina egna samtal
Retell AI är en plattform för AI-röstagenter för kontaktcenter. Call History visar latensen för varje samtal, uppdelad per komponent i Get Call API. Kontakta Retell-teamet.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


