Spekulativ avkodning är en teknik för att snabba upp en stor språkmodell: en liten utkastmodell gissar de närmaste tokens, och den stora modellen kontrollerar dem alla i en enda körning och behåller de som den själv skulle ha genererat.
Metoden kommer från två forskningsartiklar. Google Research gav den namnet i Fast Inference from Transformers via Speculative Decoding (Leviathan, Kalman och Matias, först publicerad i november 2022). DeepMind beskrev sin egen version, som utvecklades separat, i Accelerating Large Language Model Decoding with Speculative Sampling (Chen med kollegor, februari 2023).
Varför är vanlig avkodning långsam?
Vanlig avkodning är långsam eftersom en stor språkmodell skriver en token i taget, och varje token kräver en fullständig körning av modellen. Googles artikel sammanfattar det på en rad: ”att avkoda K tokens kräver K seriella körningar av modellen”.
Många av dessa tokens är lätta att förutsäga. Samma artikel konstaterar att ”svåra språkmodelleringsuppgifter ofta innehåller enklare deluppgifter som kan approximeras väl av effektivare modeller”.
Hur samarbetar utkastmodellen och den fullständiga modellen?
De två modellerna arbetar i omgångar, och varje omgång har tre delar:
- Utkast. Den lilla modellen skriver en kort serie gissningar, en token efter en annan. Googles artikel kallar den approximationsmodellen; DeepMind kallar den utkastmodellen.
- Verifiering. Den stora modellen, kallad målmodellen, poängsätter varje gissad position parallellt, i en enda körning.
- Godkänn eller korrigera. Gissningarna godkänns från vänster till höger. Vid den första avvisade gissningen lägger den stora modellen in sin egen token och de senare gissningarna kastas. Om alla gissningar godkänns lägger den stora modellen till ytterligare en token.
Varje körning av den stora modellen ger minst en token och högst antalet gissningar plus en, så den behöver aldrig fler körningar än vanlig avkodning.
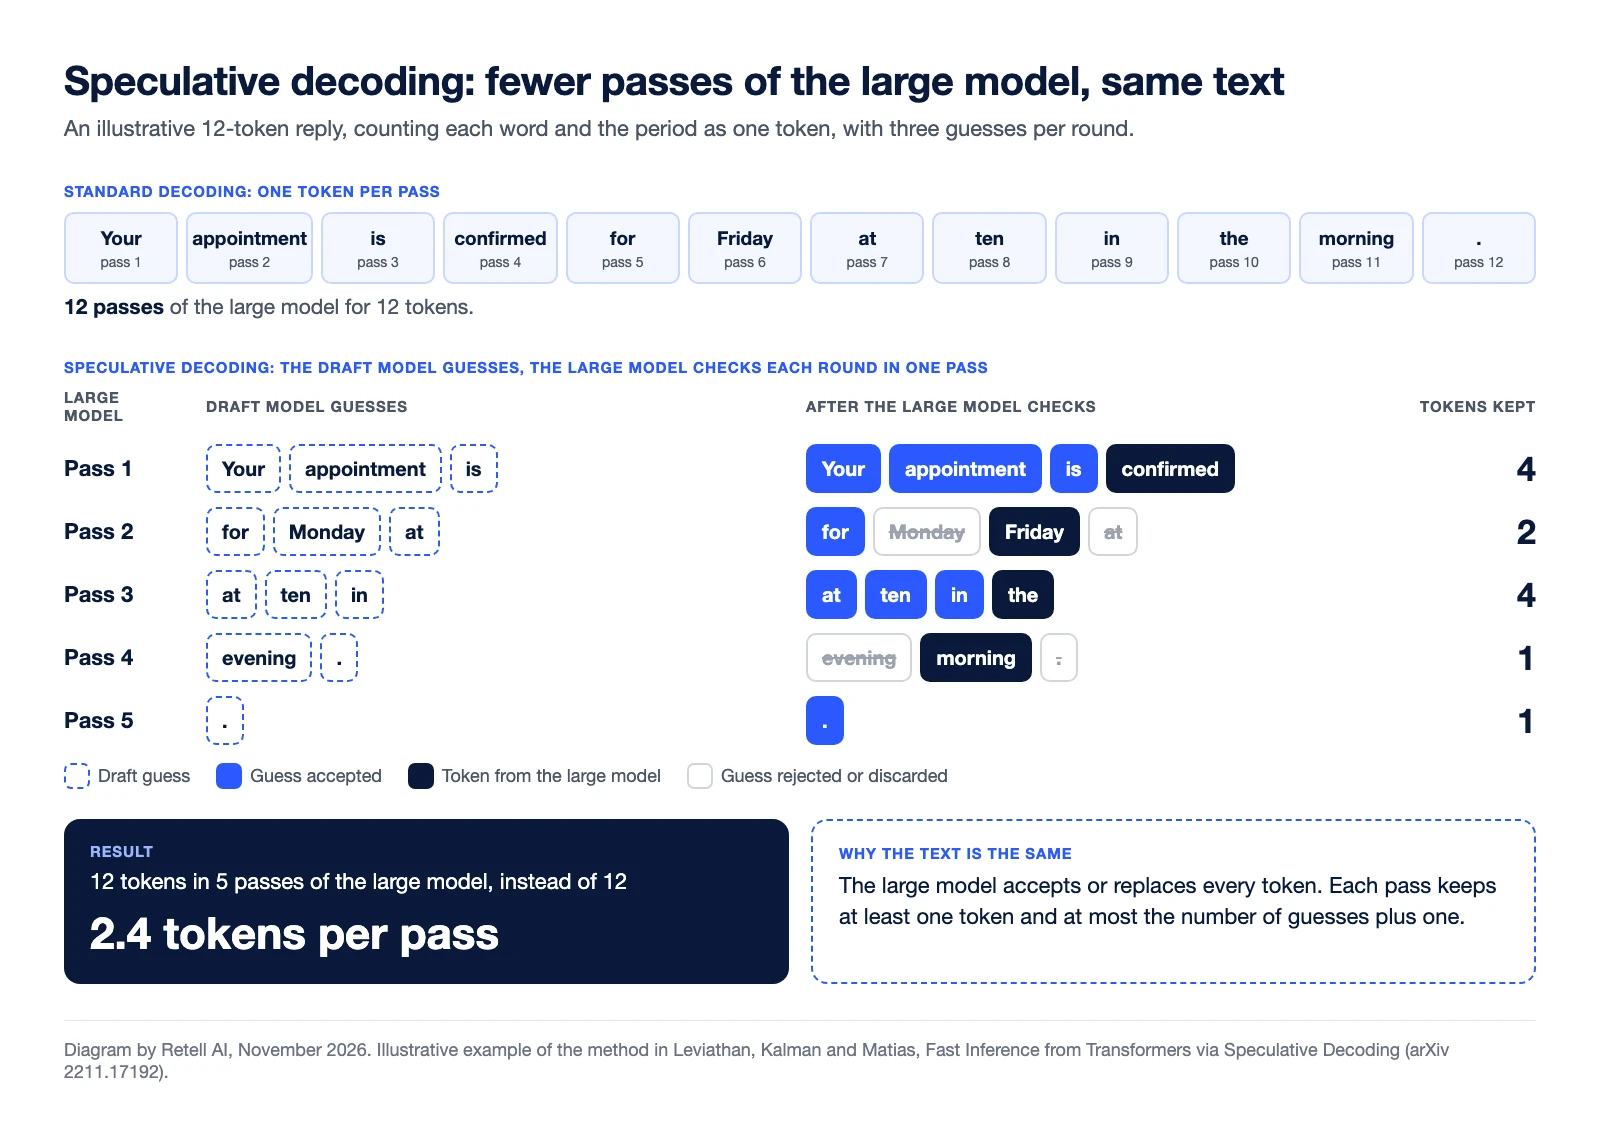
Genomräknat exempel (illustrativt). Ett engelskt svar på 12 tokens, där varje ord och punkten räknas som en token, med tre gissningar per omgång:
| Den stora modellens körning | Utkastmodellens gissningar | Den stora modellens bedömning | Behållna tokens |
|---|---|---|---|
| 1 | Your appointment is | Alla tre godkänns, lägger till ”confirmed” | 4 |
| 2 | for Monday at | ”for” godkänns. ”Monday” avvisas och ersätts med ”Friday”. ”at” kastas | 2 |
| 3 | at ten in | Alla tre godkänns, lägger till ”the” | 4 |
| 4 | evening . | ”evening” avvisas och ersätts med ”morning”. Punkten kastas | 1 |
| 5 | . | Godkänns, och svaret avslutas | 1 |
| Totalt | 12 tokens på 5 körningar |
Vanlig avkodning behöver 12 körningar av den stora modellen för den här meningen. Här körs den 5 gånger, i genomsnitt 2,4 tokens per körning.
Varför är utdata oförändrad?
Utdata är oförändrad eftersom den stora modellen har sista ordet om varje token. Med girig avkodning, där modellen alltid väljer sitt främsta alternativ, behålls en gissning bara om det är den token som den stora modellen skulle ha valt. Dokumentationen för vLLM listar ett test för just detta: girig sampling med spekulativ avkodning ”matchar girig sampling utan den”.
Med slumpmässig sampling godkänns en gissning med en sannolikhet som bestäms av hur de två modellerna bedömer den, och en avvisad gissning dras på nytt från en justerad fördelning. Googles artikel bevisar att detta lämnar utdatafördelningen oförändrad. DeepMind formulerar det som att metoden ”bevarar målmodellens fördelning inom hårdvarans numeriska precision”.
Vissa nyare varianter lättar medvetet på kontrollen för att vinna hastighet. vLLM påpekar att en av dess verifieringsmetoder ”inte är fördelningsbevarande”.
När hjälper spekulativ avkodning, och när gör den inte det?
Spekulativ avkodning hjälper när utkastmodellen är billig och oftast har rätt, och servern har ledig beräkningskapacitet.
| Förutsättning | Effekt på hastigheten | Källa |
|---|---|---|
| Gissningarna godkänns oftast | Fler tokens per körning. Förväntat antal tokens per körning = (1 − α^(γ+1)) ÷ (1 − α), där α är godkännandegraden och γ antalet gissningar per omgång | Googles artikel |
| Utkastmodellen är betydligt mindre än målmodellen | Låg kostnad för utkast. En utkastmodell som är ungefär två storleksordningar mindre ”presterade oftast bäst” | Googles artikel |
| Ledig beräkningskapacitet finns | Krävs. Metoden förutsätter ”tillräckliga beräkningsresurser för att hantera den ökade parallelliteten” | Googles artikel |
| Hög trafik på servern | Mindre vinst. vLLM bedömer en utkastmodell som ”hög vinst” vid låg förfrågningsfrekvens och ”medelhög vinst” vid hög | Dokumentationen för vLLM |
| Utkastmodellen har fel för ofta i förhållande till vad den kostar | Ingen vinst. En uppsnabbning uppstår bara när godkännandegraden är högre än utkastmodellens kostnad i förhållande till målmodellen | Googles artikel |
Som illustration ger en godkännandegrad på 0,6 med tre gissningar per omgång ungefär 2,2 tokens per körning.
Publicerade uppsnabbningar: Googles artikel rapporterar 2x till 3x på en T5-XXL-modell med 11 miljarder parametrar. DeepMind rapporterar 2 till 2,5 gånger på Chinchilla med 70 miljarder parametrar och en utkastmodell med 4 miljarder parametrar. Resultaten beror på modellerna, uppgiften och hårdvaran.
Ett produktionsexempel från röst-AI: Tell-1, den egna LLM:en från Retell, använder spekulativ avkodning för att få ut ungefär fyra tokens per körning av den fullständiga modellen, enligt det tekniska inlägget från Retell om Retell LLM.
Varför spelar spekulativ avkodning roll för röst i realtid?
Spekulativ avkodning spelar roll för röst i realtid eftersom den som ringer upplever modellens bearbetningstid som tystnad. I ett samtal är modellen ett steg i kedjan av tal-till-text, LLM och text-till-tal, och dess fördröjning läggs till samtalets latens.
Bästa praxis för anpassad LLM från Retell förklarar vilken del av modellens tid som räknas: Retell ”börjar tala så snart den har din första fullständiga mening”, så siffran att bevaka är ”tiden till första token plus tiden för att slutföra den första meningen”. Spekulativ avkodning påverkar den andra delen: när genereringen väl har startat kommer tokens i grupper. Den förkortar inte inläsningen av prompten som sker före första token. För det börjar felsökningsguiden för latens från Retell med modellval och promptlängd.
Den andra anledningen är precision. Att byta till en mindre modell minskar också fördröjningen, men samma guide varnar för att ett modellbyte ”ändrar din agents beteende, inte bara dess hastighet”. Exakt spekulativ avkodning behåller den stora modellens utdata.
Den som driftsätter modellen tillämpar tekniken, så den som bygger en agent upplever den som modellens hastighet. På Retell körs Tell-1 på det här sättet. För att jämföra modeller utifrån hastighet och samtalskvalitet, se de bästa LLM:erna för AI-röstagenter.
Vanliga frågor om spekulativ avkodning
Är spekulativ avkodning förlustfri?
I sin exakta form, ja. De ursprungliga artiklarna bevisar att utdatafördelningen överensstämmer med den stora modellens, och vLLM beskriver den som ”teoretiskt förlustfri upp till precisionsgränserna för hårdvarans numerik”. Varianter som lättar på verifieringen är inte förlustfria.
Vem skapade spekulativ avkodning?
Yaniv Leviathan, Matan Kalman och Yossi Matias på Google Research publicerade artikeln i november 2022 och presenterade den på ICML 2023. Ett team från DeepMind publicerade sin egen version, kallad spekulativ sampling, i februari 2023.
Vad är en utkastmodell?
En utkastmodell är den lilla, snabba modell som skriver gissningarna. Dokumentationen från Hugging Face anger att metoden fungerar bäst när den ”är betydligt mindre än huvudmodellen och använder samma tokenizer”.
Minskar spekulativ avkodning kostnaden?
Det kan gå åt båda hållen. Googles artikel påpekar att det totala antalet aritmetiska operationer ”kan vara högre än för den vanliga avkodningsalgoritmen”, eftersom avvisade gissningar är bortkastat arbete. Googles tillbakablick från 2024 tillägger att snabbare resultat på samma hårdvara innebär att ”färre maskiner behövs för att hantera samma mängd trafik”.
Är multi-token prediction samma sak som spekulativ avkodning?
Nej. Multi-token prediction (MTP) är ett sätt att ta fram gissningarna. Dokumentationen för vLLM listar MTP bredvid utkastmodeller som en spekulationsmetod.
Testa modellens hastighet på dina egna samtal
Retell AI är en plattform för AI-röstagenter för kontaktcenter. Prata med teamet på Retell om ett pilotprojekt med riktiga samtal.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


