LLM som domare är en utvärderingsmetod där en stor språkmodell poängsätter eller rangordnar utdata från ett annat AI-system mot skrivna kriterier, i stället för en mänsklig granskare. Team använder metoden för att bedöma öppna uppgifter som saknar ett enda rätt svar, till exempel ett telefonsamtal.
Namnet kommer från en artikel från 2023, Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Författarna rapporterade att starka domare som GPT-4 matchade mänskliga preferenser med "över 80 % överensstämmelse, samma nivå av överensstämmelse som mellan människor". De listade även metodens begränsningar: positionsbias, ordrikedomsbias och självförstärkningsbias.
Hur poängsätter en LLM-domare ett samtal?
En LLM-domare läser samtalet och en uppsättning instruktioner och returnerar sedan ett utlåtande i en av tre former.
| Metod | Vad domaren gör | Vad som returneras | Var metoden passar |
|---|---|---|---|
| Bedömning med mall | Läser en transkription mot skrivna kriterier | Godkänt eller underkänt, eller en poäng, med motivering | QA i produktion och regressionstester |
| Parvis rangordning | Jämför två eller fler svar på samma replik | En vinnare eller en rangordning | Val mellan prompter eller modeller |
| Domarpanel | Flera domarmodeller bedömer samma objekt och utlåtandena slås samman | En sammanslagen poäng | Poäng som en enskild modells bias skulle kunna snedvrida |
Bedömning med mall. I G-Eval-artikeln fick domaren resonera sig igenom kriterierna och sedan fylla i ett poängformulär. Vid sammanfattning korrelerade poängen bättre med mänskliga bedömningar än tidigare metoder.
Parvis rangordning. Att fråga vilket av två svar som är bäst passar egenskaper som ton, där en skillnad är lättare att se än att poängsätta.
Domarpaneler. I Replacing Judges with Juries "överträffar" en panel av mindre modeller från olika modellfamiljer "en enskild stor domare, uppvisar mindre bias inom modellen" och var "över sju gånger billigare".
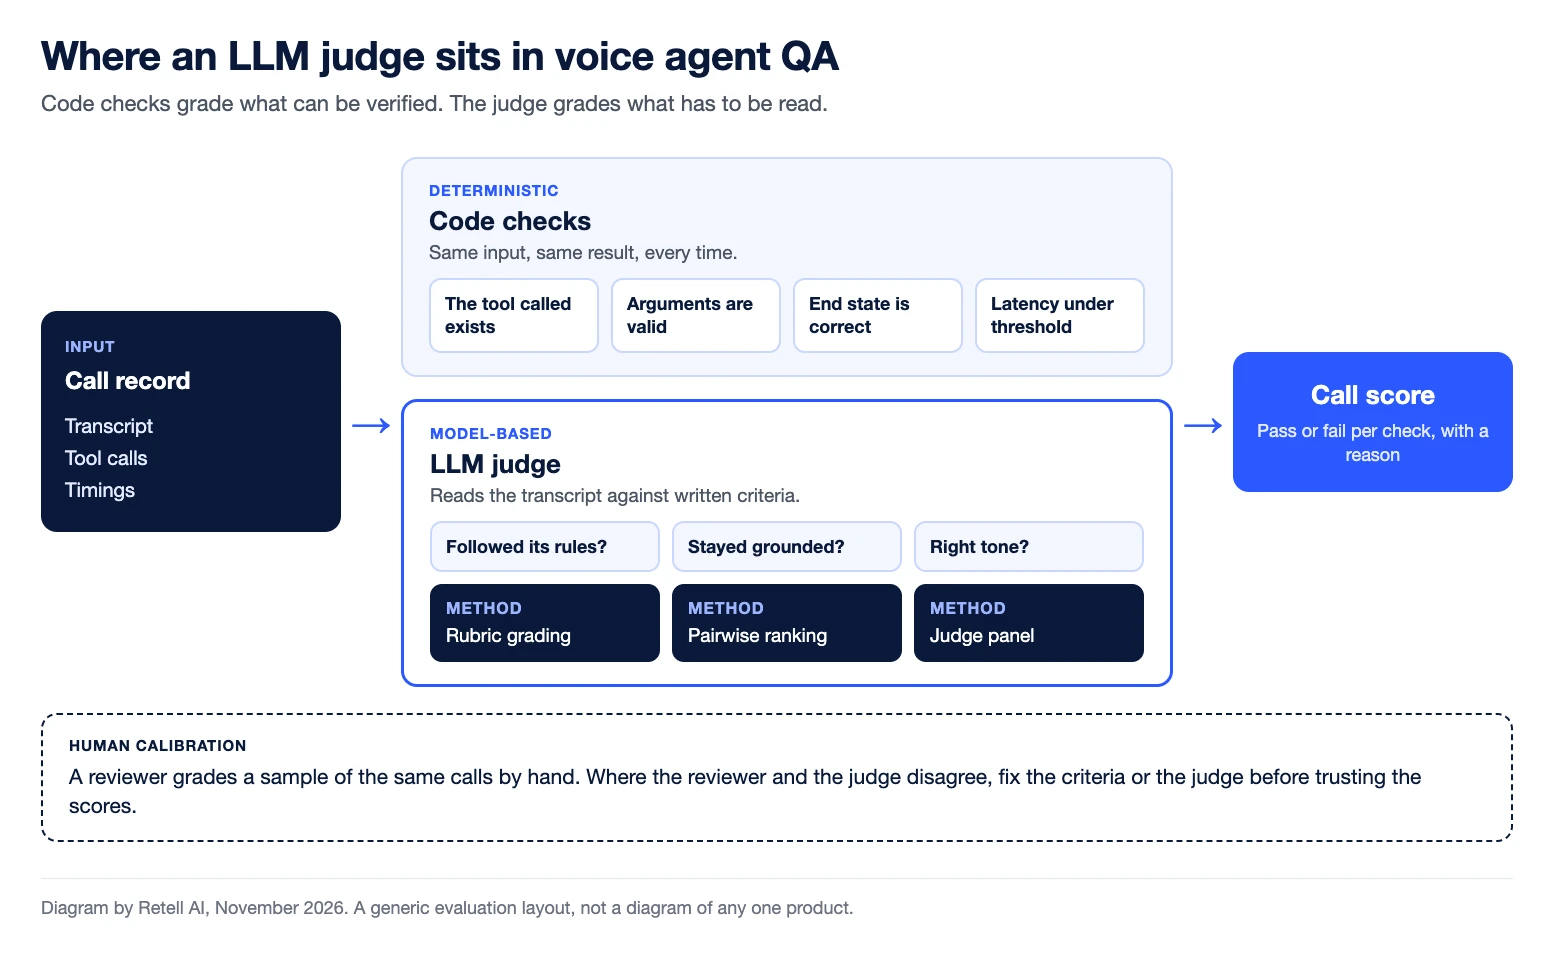
Hur används LLM som domare i QA och benchmarks för röstagenter?
QA för röstagenter använder en LLM-domare för de delar av ett samtal som bara kan avgöras genom att läsa transkriptionen: om agenten följde sina regler, höll sig till sina källor och löste ärendet.
Dokumentationen från Retell visar båda de vanliga uppläggen. I AI QA är ett AI-utvärderat villkor "en kvalitativ kontroll som AI:n kör mot varje samtals transkription och kontext", formulerat som "den prompt som AI:n använder för att bedöma om villkoret är uppfyllt". I simuleringstester spelar en AI den som ringer, och "varje körning bedöms som godkänd eller underkänd med en skriftlig förklaring".
Benchmarks rapporterar samma typ av utlåtande i stor skala. Retell vCX Benchmark publicerar varje testsvits poäng som en andel godkända, "andelen testade scenarier som hanterades korrekt", inom instruktionsföljning, grundning, verktygsanrop och vardagligt tal (läst 13 november 2026).
Om du vill omvandla utlåtanden till en veckovis genomgång, se QA-poängkortet för röstagenter.
Vilka kända felmönster har en LLM-domare?
En LLM-domare brister på fyra dokumenterade sätt. Vart och ett har en känd motåtgärd.
- Positionsbias. I Large Language Models are not Fair Evaluators ledde ett byte av ordningen mellan två svar till att en modell vann "66 av 80 testade frågor". Kör varje jämförelse i båda ordningarna.
- Självpreferens. En studie från 2024 fann att en utvärderare "ger sina egna utdata högre poäng än andras, medan mänskliga annoterare bedömer dem som likvärdiga i kvalitet". Använd en domare från en annan modellfamilj, eller en panel.
- Svag överensstämmelse med människor. Judging the Judges testade tretton domarmodeller och fann att "endast de bästa (och största) modellerna uppnår rimlig samstämmighet med människor", med "en tendens till mildhet". Bedöm ett urval manuellt och jämför.
- Drift. Modellen bakom ett API kan förändras: en studie mätte hur GPT-4 föll från 84 % till 51 % träffsäkerhet på samma uppgift inom tre månader. Även kriterierna förändras. Who Validates the Validators? kallar detta kriteriedrift: "användare behöver kriterier för att bedöma utdata, men att bedöma utdata hjälper användare att definiera kriterier". Lås domarversionen och kör om en fast, manuellt märkt uppsättning efter varje ändring.
Domare är inte heller deterministiska. Simuleringsdokumentationen från Retell rekommenderar: "Bedöm ett scenario utifrån dess andel godkända över flera körningar, inte utifrån en enskild körning."
När är kodkontroller bättre än en LLM-domare?
Kodkontroller är bättre än en LLM-domare när svaret kan verifieras i stället för läsas. Anthropics guide till utvärderingar av agenter rekommenderar att "välja deterministiska bedömare där det är möjligt och LLM-bedömare där det är nödvändigt". Guiden beskriver kodbaserade bedömare som snabba, billiga, objektiva och reproducerbara, och modellbaserade bedömare som icke-deterministiska.
I ett samtal kan kod kontrollera att verktyget som agenten anropade finns, att dess argument är giltiga och att svarstiden låg under ett tröskelvärde. tau-bench bedömer hela samtal på det här sättet genom att jämföra "databasens tillstånd i slutet av ett samtal med det annoterade måltillståndet".
AI QA från Retell håller isär de två: prestandamått är kvantitativa tröskelvärden, och AI-utvärderade villkor står för de kvalitativa kontrollerna. Så testar och släpper du ändringar i röstagenter beskriver var var och en körs.
Hur används domarpaneler för att träna en röstmodell?
Tell-1, den egna LLM:en från Retell, använde LLM-domare i två av sina tre träningssteg, enligt det tekniska inlägget om Retell LLM. Steget för preferensjustering lärde sig av "preferenspar rangordnade av en panel av LLM-domare".
I steget för förstärkningsinlärning "skriver modellen åtta svar och vart och ett poängsätts", enligt inlägget. Kod körs först: anrop till verktyg utanför agentens verktygslåda, felaktigt formaterade utdata och andra kritiska fel "fångas i kod innan någon domare ser dem". För korrekthet "bedömer flera domarmodeller korrekta verktygsanrop, hallucinationer och instruktionsföljning, och deras utlåtanden slås samman till en enda belöningssignal". För naturlighet rangordnar en enda domare alla åtta svar sida vid sida mot en bedömningsmall, eftersom "naturlighet är lättare att jämföra än att poängsätta".
Det är just det mönster som den här sidan beskriver: kodkontroller för det som kan verifieras, en domarpanel för korrekthet och rangordning för ton.
Vanliga frågor om LLM som domare
Vad gör en LLM-domare?
Den läser utdata, till exempel en samtalstranskription, tillsammans med bedömningsinstruktioner och returnerar ett utlåtande: godkänt eller underkänt, en poäng eller en preferens mellan två alternativ.
Hur tillförlitlig är LLM som domare?
Det beror på domarmodellen och uppgiften. En studie fann över 80 % överensstämmelse med mänskliga preferenser; en annan fann att endast de största domarna var rimligt samstämmiga med människor. Kontrollera först en domare mot manuellt bedömda samtal.
Vad är en domarpanel?
En domarpanel består av flera domarmodeller som bedömer samma utdata och vars utlåtanden slås samman. Det minskar effekten av en enskild modells bias.
Vad är skillnaden mellan bedömning med mall och parvis rangordning?
Bedömning med mall poängsätter en utdata mot skrivna kriterier. Parvis rangordning visar domaren två utdata och frågar vilken som är bäst.
Kan en LLM-domare poängsätta ett röstsamtal?
Ja, utifrån transkriptionen och verktygsanropen. Egenskaper som finns i ljudet kräver även ljudet: dokumentationen från Retell anger att Agent Naturalness "utvärderas med både ljudet och transkriptionen".
Poängsätt dina egna samtal innan du skalar upp
Retell AI är en plattform för AI-röstagenter för kontaktcenter. AI QA utvärderar ett urval av dina samtal mot de villkor och tröskelvärden du anger, med belägg från transkriptionen för varje resultat.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


