GPT-Live-1: So funktioniert OpenAIs Vollduplex-Sprachmodell bei Telefonanrufen




GPT-Live-1 ist OpenAIs Vollduplex-Sprachmodell. Es hört und spricht gleichzeitig, verarbeitet Unterbrechungen selbst und übergibt Reasoning und Tool-Nutzung an ein separates Backend-Modell. OpenAI hat es am 10. September 2026 in die API gebracht, nachdem es im Sprachmodus von ChatGPT debütiert hatte, und es ist seit dem 2. November 2026 auf Telefonagenten von Retell AI verfügbar. Dieser Leitfaden erklärt, wie es funktioniert, was es in der API kostet, wo es bei Telefonanrufen passt und wie Sie es auf einem Retell-Agenten einrichten.
Die Retell AI veröffentlicht diesen Leitfaden und bietet GPT-Live-1 als eines der Modelle auf ihrer Plattform für Sprachagenten an.
GPT-Live-1 auf einen Blick
| GPT-Live-1 | |
|---|---|
| Entwickler | OpenAI |
| Modell-ID | gpt-live-1 |
| Typ | Vollduplex-Sprachmodell, das Reasoning und Tool-Nutzung an ein Backend-Modell oder einen Agenten delegiert |
| Ein- und Ausgabe | Audio und Text als Eingabe, Audio und Text als Ausgabe |
| API-Endpoint | Live-Sessions (v1/live/sessions), über WebRTC, WebSockets oder Telefonie und SIP |
| API-Preis | 0,05 $ pro Minute Sprachsitzung, sekundengenau abgerechnet. Backend-Modell und Tool-Nutzung werden separat abgerechnet. |
| Parallelität | 50 Sitzungen im Build-Tarif, 300 im Launch-Tarif, 500 im Grow-Tarif. Im Free-Tarif nicht verfügbar. |
| Kontextfenster | 128.000 Token |
| Neuere Version | GPT-Live-1.1 wurde am 15. Oktober 2026 für ChatGPT, Codex und dots ausgerollt und für die API als „demnächst verfügbar“ angekündigt. Stand 5. November noch nicht in der API. |
Quellen: OpenAIs Modellseite zu GPT-Live-1, Live-Leitfaden, Leitfaden zu Live-Konversationen, API-Changelog und Launch-Beitrag; GPT-Live-1.1 aus einem Beitrag im Entwicklerforum von OpenAI. Abgerufen am 5. November 2026.
So funktioniert Vollduplex
Die meisten Sprachagenten wechseln sich auf eine von zwei Arten mit dem Anrufer ab. Ein kaskadierender Agent transkribiert den Anrufer, sendet den Text an ein Sprachmodell und wandelt die Antwort dann in Sprache um. Ein Speech-to-Speech-Modell wie OpenAIs gpt-realtime-2.1 erledigt alle drei Schritte in einem einzigen Modell.
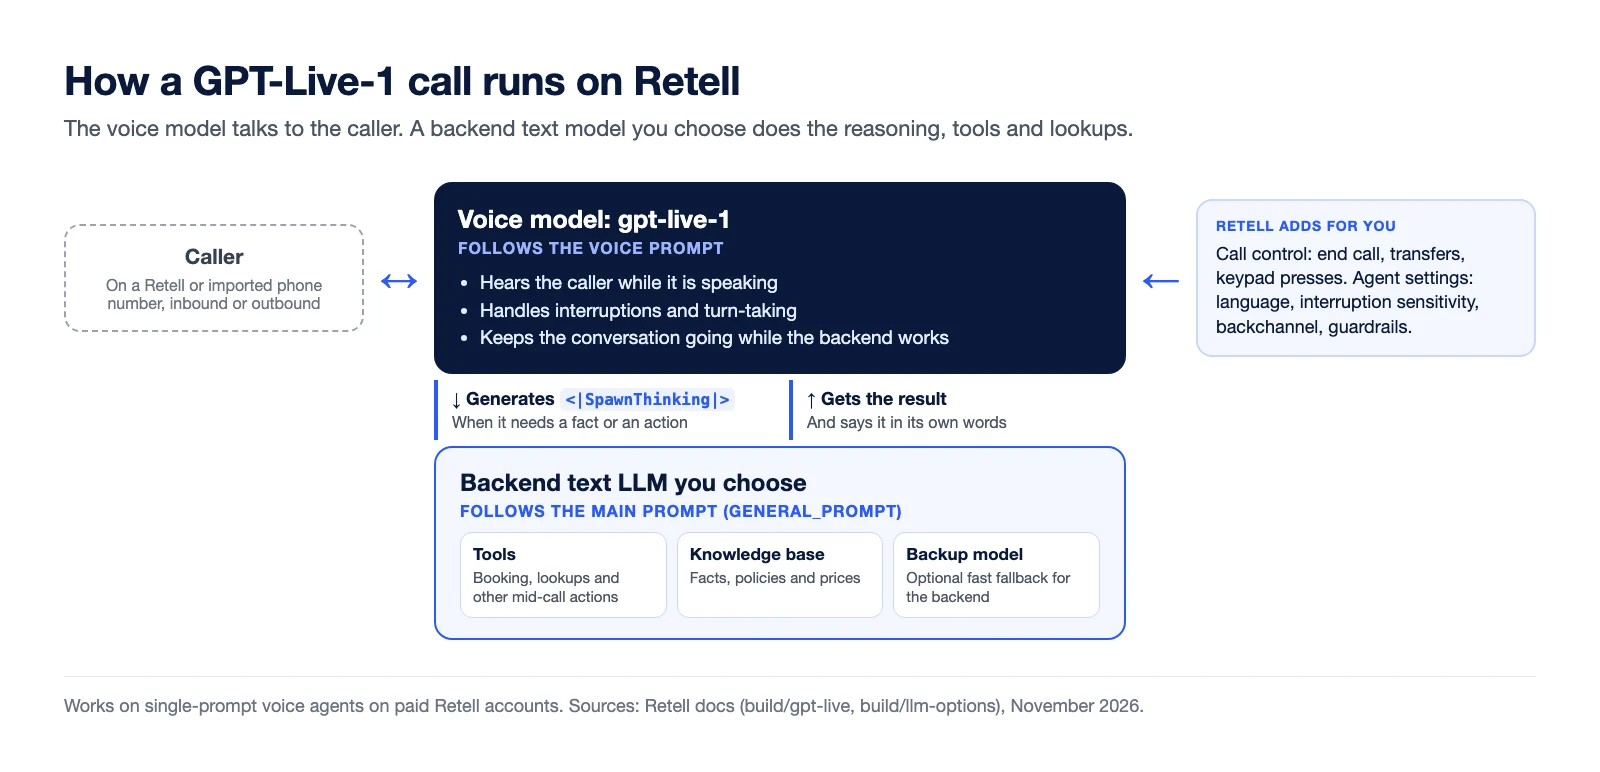
GPT-Live-1 teilt die Aufgabe anders auf. Das Sprachmodell führt das Gespräch: Es hört den Anrufer, während es selbst spricht, verarbeitet Unterbrechungen (Barge-in) und Pausen und entscheidet, was es als Nächstes sagt. Braucht es einen Fakt oder eine Aktion, fordert es Backend-Arbeit an, indem es ein spezielles Token erzeugt: <|SpawnThinking|>. Das Backend kann ein Modell, ein Agent oder ein Dienst sein; bei Retell ist es ein Textmodell Ihrer Wahl, das die Tools und die Wissensdatenbank des Agenten ausführt. Das Backend liefert das Ergebnis zurück, und das Sprachmodell gibt es in eigenen Worten wieder. Die Backend-Arbeit kann weiterlaufen, wenn der Anrufer unterbricht.
OpenAIs eigene Zahlen sprechen für diese Aufteilung. Laut den Diagrammen im API-Launch-Beitrag besteht GPT-Live-1 mit GPT-6 Astra bei mittlerem Reasoning-Aufwand als Backend 86,2 % der Tau3-Sprachaufgaben (Support für Airlines, Einzelhandel und Telekommunikation) im ersten Versuch, gegenüber 45,7 % für GPT-Realtime-2.1. Im Full Duplex Bench meldet OpenAI für GPT-Live-1 eine Latenz beim Sprecherwechsel von 0,798 Sekunden, gegenüber 1,41 Sekunden für GPT-Realtime-2.1. Dies sind Ergebnisse von OpenAI, keine Messungen von Retell.
Kaskadierend, Speech-to-Speech oder Vollduplex?
Retell unterstützt alle drei Arten, einen Sprachagenten zu betreiben. Sie eignen sich für unterschiedliche Anrufe.
| Kaskadierend | Speech-to-Speech | Vollduplex (GPT-Live-1) | |
|---|---|---|---|
| Ablauf eines Gesprächsschritts | Transkription, dann ein Text-LLM, dann Text-to-Speech | Ein Modell hört Audio und antwortet in Audio | Ein Sprachmodell spricht, während ein Backend-Text-LLM Reasoning und Tools übernimmt |
| Beispiele bei Retell | GPT 5.6 Terra, Claude 5 Sonnet, Gemini 3.5 Flash | gpt-realtime-2.1, grok-voice-3.0 | gpt-live-1 mit einem Backend-Text-LLM |
| Prompts | Einer | Einer | Zwei: ein Voice-Prompt und der Backend-Prompt |
| Fast-Fallback-Backup-Modell | Unterstützt | Nicht unterstützt | Gilt für das Backend-Modell |
| Ideal für | Conversation Flows und strikte mehrstufige Logik | Schnelle, natürliche Anrufe, die überwiegend einem Prompt folgen | Natürliche Anrufe, bei denen auch Aktionen während des Anrufs ausgeführt werden |
Zur Speech-to-Speech-Option von xAI lesen Sie, wie Sie einen Telefonagenten mit Grok Voice betreiben. Einen breiteren Überblick über die Modelle bietet unser Vergleich der Speech-to-Speech-KI-APIs für Telefonanrufe.
Wo GPT-Live-1 bei Telefonanrufen passt
Am stärksten ist GPT-Live-1 bei Single-Prompt-Agenten, die während des Anrufs Aktionen ausführen – etwa einen Termin buchen oder eine Bestellung nachschlagen –, bei denen die Antwortlücke eines kaskadierenden Agenten auffällt. Während das Backend bucht oder etwas nachschlägt, hält das Sprachmodell das Gespräch am Laufen, statt mit einem Füllsatz zu pausieren.
Bei Retell gelten klare Einschränkungen:
- Nur Single-Prompt-Sprachagenten. Für Conversation Flows, Multi-Prompt-Agenten, Transfer-Agenten oder Chat-Agenten ist es nicht verfügbar. Nutzen Sie dafür ein kaskadierendes oder ein Speech-to-Speech-Modell.
- Einige Tools werden nicht unterstützt. Agent Swap, betreute Weiterleitung (Bridged Transfer) und Cancel Transfer werden beim Speichern abgelehnt. Eine einfache Anrufweiterleitung, End Call und Press Digit funktionieren.
- Nur kostenpflichtige Konten. Wie Speech-to-Speech-Modelle ist GPT-Live-1 nicht Teil der kostenlosen Testversion.
- Kein Wechsel pro Anruf. Ein Agenten-Override für einen einzelnen Anruf kann einen Agenten nicht auf GPT-Live-1 umstellen.
So richten Sie GPT-Live-1 auf einem Retell-Telefonagenten ein
GPT-Live-1 wird über die Retell API auf einem Retell LLM konfiguriert.
- Erstellen Sie ein Retell LLM, bei dem model_config auf den Typ duplex gesetzt ist, mit gpt-live-1 als primärem Modell und dem gewünschten Textmodell als Backend.
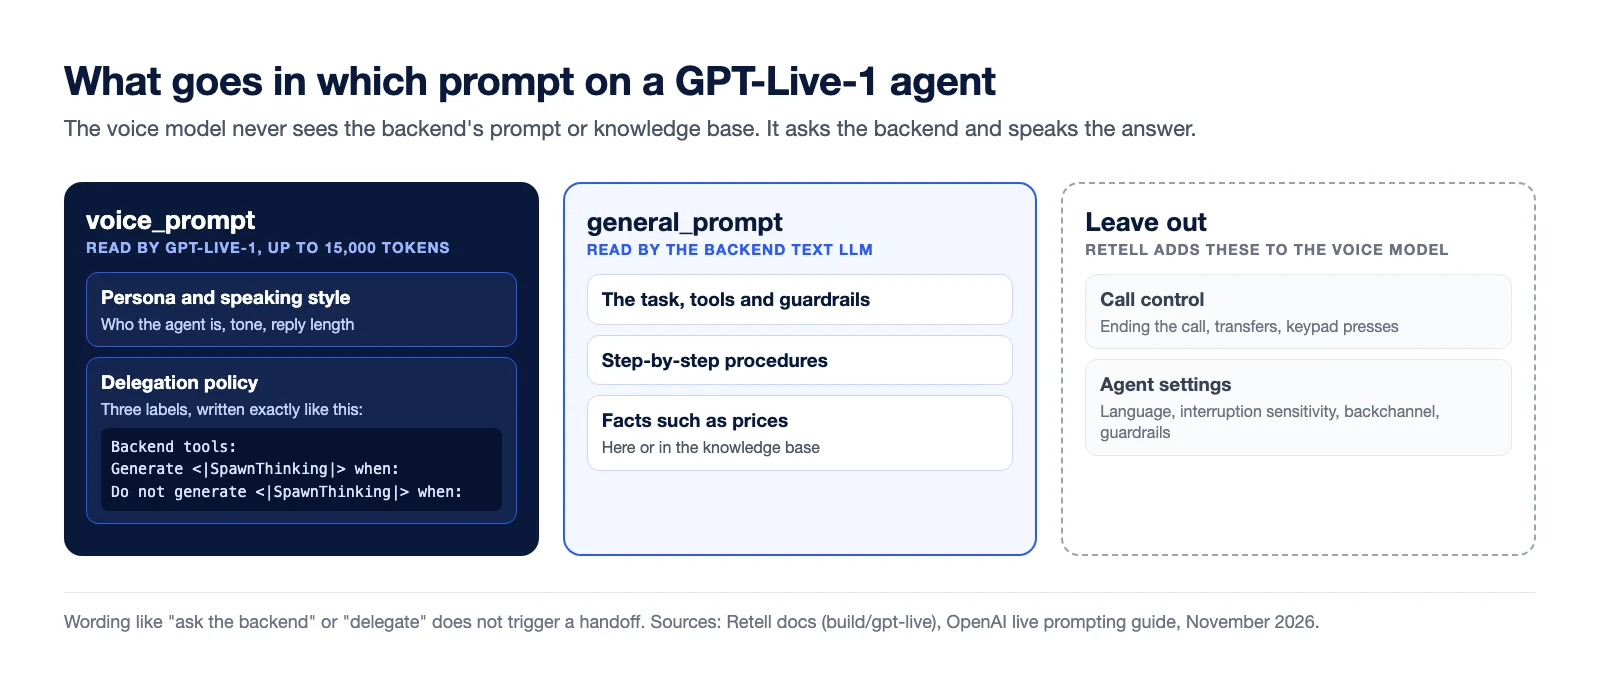
- Schreiben Sie zwei Prompts. general_prompt ist der Prompt des Backends: Aufgabe, Tools und Guardrails. voice_prompt legt fest, wie das Sprachmodell spricht und wann es Aufgaben an das Backend übergibt. Er kann bis zu 15.000 Token lang sein.
- Verknüpfen Sie das LLM mit einem Sprachagenten als dessen Response Engine – genau wie bei jedem anderen Retell LLM.
- Verbinden Sie eine Telefonnummer und nehmen Sie eingehende Anrufe entgegen oder tätigen Sie ausgehende.
Hier ist ein aus der Retell-Dokumentation adaptierter Request für den Agenten einer Zahnarztpraxis:
curl --request POST "https://api.retellai.com/create-retell-llm" \
  --header "Authorization: Bearer $RETELL_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "general_prompt": "You are the backend for a dental clinic phone agent. Collect the caller name and date of birth, then use the booking tool to find and confirm an appointment. Keep names, numbers, and dates exact.",
    "voice_prompt": "You are a warm, efficient front-desk agent for Bright Smile Dental. Keep replies short and natural, and ask one question at a time.\n\nDelegation policy:\nBackend tools:\n- Appointments: find open times and book, change, or cancel appointments.\n\nGenerate <|SpawnThinking|> when:\n- The caller wants to book, change, or cancel an appointment.\n\nDo not generate <|SpawnThinking|> when:\n- You need a brief clarification to understand the request.",
    "model_config": {
      "type": "duplex",
      "primary": { "model": "gpt-live-1" },
      "backend": { "model": "gpt-4.1" }
    }
  }'
Alle Felddetails finden Sie im GPT-Live-Einrichtungsleitfaden.
Den Voice-Prompt schreiben
Beim Voice-Prompt passieren bei den meisten GPT-Live-1-Agenten die Fehler. Das Modell übergibt Aufgaben nur dann an das Backend, wenn es <|SpawnThinking|> erzeugt – die Übergaberegeln müssen also genau diese Formulierung verwenden. Formulierungen wie „frag das Backend“ oder „delegiere“ lösen keine Übergabe aus. OpenAIs Prompting-Leitfaden warnt außerdem, dass ein gesprochenes Versprechen wie „Ich prüfe das gerade“ nicht bedeutet, dass die Backend-Arbeit begonnen hat.
Schreiben Sie den Voice-Prompt in zwei Teilen:
- Persona und Sprechstil. Wer der Agent ist und wie er spricht, etwa Tonfall und Antwortlänge.
- Eine Delegationsrichtlinie unter drei Labels, die exakt so beibehalten werden: „Backend tools:“ listet auf, was das Backend kann, eine Fähigkeit pro Zeile. „Generate <|SpawnThinking|> when:“ listet auf, wann übergeben werden soll. „Do not generate <|SpawnThinking|> when:“ listet auf, was direkt beantwortet werden soll.
Tool-Definitionen, Schritt-für-Schritt-Abläufe und Fakten wie Preise gehören in den Backend-Prompt und die Wissensdatenbank. Das Sprachmodell sieht sie nicht; es fragt das Backend und gibt die Antwort in eigenen Worten wieder. Retell ergänzt das Sprachmodell zudem automatisch um Anweisungen zur Anrufsteuerung (Anruf beenden, Weiterleitungen, Tastatureingaben) und um die Einstellungen des Agenten – lassen Sie diese also weg.
Was aus Ihren Agenteneinstellungen übernommen wird
Die meisten Retell-Agenteneinstellungen gelten weiterhin. Das Sprachmodell berücksichtigt Sprache, Unterbrechungsempfindlichkeit, Reaktionsfreudigkeit, Backchannel, Sprechgeschwindigkeit, Aussprache, Boosted Keywords und Guardrails des Agenten. Mailbox-, IVR-, Do-not-Call- und Rückruferkennung laufen über das Backend, und die Einstellung für die Begrüßungsnachricht legt weiterhin fest, wer zuerst spricht.
Zwei Dinge verhalten sich anders. Die Einstellung „Während der Ausführung sprechen“ jedes Tools wird ignoriert, da das Sprachmodell weiterspricht, während das Backend arbeitet, und der Agent spricht immer, nachdem ein Tool fertig ist. Dynamische Variablen im Voice-Prompt werden einmalig beim Start des Anrufs befüllt.
Was GPT-Live-1 kostet
In OpenAIs API kostet eine GPT-Live-1-Sprachsitzung 0,05 $ pro Minute, sekundengenau abgerechnet und nicht auf die nächste Minute aufgerundet. Das Backend-Modell und seine Tools werden separat zu den üblichen Tarifen abgerechnet.
Bei Retell wird das Sprachmodell pro Minute Anrufzeit abgerechnet und das Backend-Text-LLM separat für seine eigene Nutzung. Aktuelle Tarife finden Sie auf der Preisseite. Ein Detail ist bei langen Anrufen wichtig: Retell reduziert die Modellkosten bei längeren Stillephasen, Vollduplex-Sprachmodelle werden während dieser Phasen jedoch weiterhin abgerechnet.
Häufig gestellte Fragen
Was ist GPT-Live-1?
GPT-Live-1 ist OpenAIs Vollduplex-Sprachmodell für Echtzeitgespräche. Es hört und spricht gleichzeitig, verarbeitet Unterbrechungen und delegiert Reasoning und Tool-Nutzung an ein Backend-Modell oder einen Agenten Ihrer Wahl.
Ist GPT-Live-1 in der API verfügbar?
Ja. GPT-Live-1 ist seit dem 10. September 2026 allgemein in OpenAIs API verfügbar, über den Endpoint für Live-Sessions. GPT-Live-1.1, eine neuere Version mit mehr Stimmen und besserer Leistung in anderen Sprachen als Englisch, wurde am 15. Oktober 2026 für ChatGPT, Codex und dots ausgerollt und für die API als „demnächst verfügbar“ angekündigt.
Wie viel kostet GPT-Live-1?
OpenAI berechnet 0,05 $ pro Minute für eine GPT-Live-1-Sprachsitzung, sekundengenau abgerechnet. Backend-Modell und Tool-Nutzung werden separat zu den üblichen Tarifen abgerechnet.
Kann GPT-Live-1 Telefonanrufe bewältigen?
Ja. OpenAI unterstützt Telefonie- und SIP-Verbindungen für Live-Sessions. Bei Retell ist ein GPT-Live-1-Agent ein Sprachagent wie jeder andere: Sie verbinden ihn mit einer Telefonnummer für eingehende und ausgehende Anrufe, und sowohl eine einfache Anrufweiterleitung als auch Press Digit funktionieren.
Worin unterscheidet sich GPT-Live-1 von gpt-realtime?
gpt-realtime-Modelle sind Speech-to-Speech-Modelle: Ein Modell hört zu, führt das Reasoning durch, ruft Tools auf und spricht – über OpenAIs Realtime API. GPT-Live-1 läuft auf einem separaten Endpoint für Live-Sessions, behält die Stimme in einem eigenen Modell und sendet Reasoning und Tools an ein Backend. OpenAI meldet für GPT-Live-1 in Kombination mit einem starken Backend eine höhere Aufgabenerfüllung und einen schnelleren Sprecherwechsel.
Funktioniert GPT-Live-1 mit Conversation Flows bei Retell?
Nein. Bei Retell funktioniert GPT-Live-1 nur mit Single-Prompt-Sprachagenten. Conversation Flows und Multi-Prompt-Agenten benötigen ein kaskadierendes oder ein Speech-to-Speech-Modell.
Testen Sie GPT-Live-1 mit Ihren eigenen Anrufen
Wenn Ihr Agent während des Anrufs Aktionen ausführt und Sie die Pausen stören, lohnt sich ein Pilotprojekt mit GPT-Live-1. Folgen Sie dem Einrichtungsleitfaden, verbinden Sie eine Nummer in Retell und vergleichen Sie es bei echten Anrufen mit Ihrem aktuellen Modell, bevor Sie wechseln.
Sehen Sie, wie viel Ihr Unternehmen durch den Wechsel zu KI-gestützten Sprachagenten sparen könnte.
ROI-Ergebnis
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Eine Demo-Telefonnummer von Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs
Revolutionieren Sie Ihren Anrufbetrieb mit Retell


