Von der Sprach-KI-Demo in die Produktion: Was Käufer in den ersten 30 Tagen brauchen




Einen KI-Sprachagenten in 30 Tagen von der Demo in die Produktion zu bringen heißt: zunächst einen Anruftyp eingrenzen, ihn in Woche zwei aufbauen und anbinden, in Woche drei mit simulierten und echten Anrufen testen und in Woche vier per Soft Launch für einen Teil des Live-Traffics freischalten – mit genau einer benannten verantwortlichen Person für jedes Arbeitspaket. Die Demo beweist, dass die Plattform ein Gespräch führen kann. Die 30 Tage beweisen, dass Ihr Team sie betreiben kann, und eine Pilot-to-Production-Scorecard am Ende zeigt Ihnen, wann der Agent für mehr Traffic bereit ist.
Warum bringt Sie eine gute Demo nicht in die Produktion?
Eine Demo beantwortet die Frage „Kann er sprechen?“. Die Produktion stellt vier andere Fragen: welche Anrufe er übernimmt, in welche Systeme er schreibt, wer ihn repariert, wenn ein Anruf schiefgeht, und wie eine Änderung getestet wird, bevor Anrufer sie hören. Die meisten Teams, die nach einer Demo stocken, hängen nicht an der Software fest. Sie verstehen das Dashboard. Was ihnen fehlt, sind ein Plan, eine benannte verantwortliche Person und jemand, den sie fragen können, wenn beim Aufbau eine Frage auftaucht, die die Dokumentation für ihren spezifischen Workflow nicht beantwortet.
Wenn Sie noch eine Plattform auswählen, beginnen Sie mit wie Sie eine Sprachagenten-Plattform vor dem Go-live bewerten. Wenn Sie einen Favoriten haben, sich aber noch nicht festgelegt haben, prüfen Sie ihn zuerst an Ihren eigenen Grenzfällen, wie im nächsten Abschnitt beschrieben. Danach geht dieser Leitfaden davon aus, dass Sie sich entschieden haben und nun live gehen müssen.
Wie führen Sie einen Sprach-KI-Proof-of-Concept mit Ihren eigenen Grenzfällen durch?
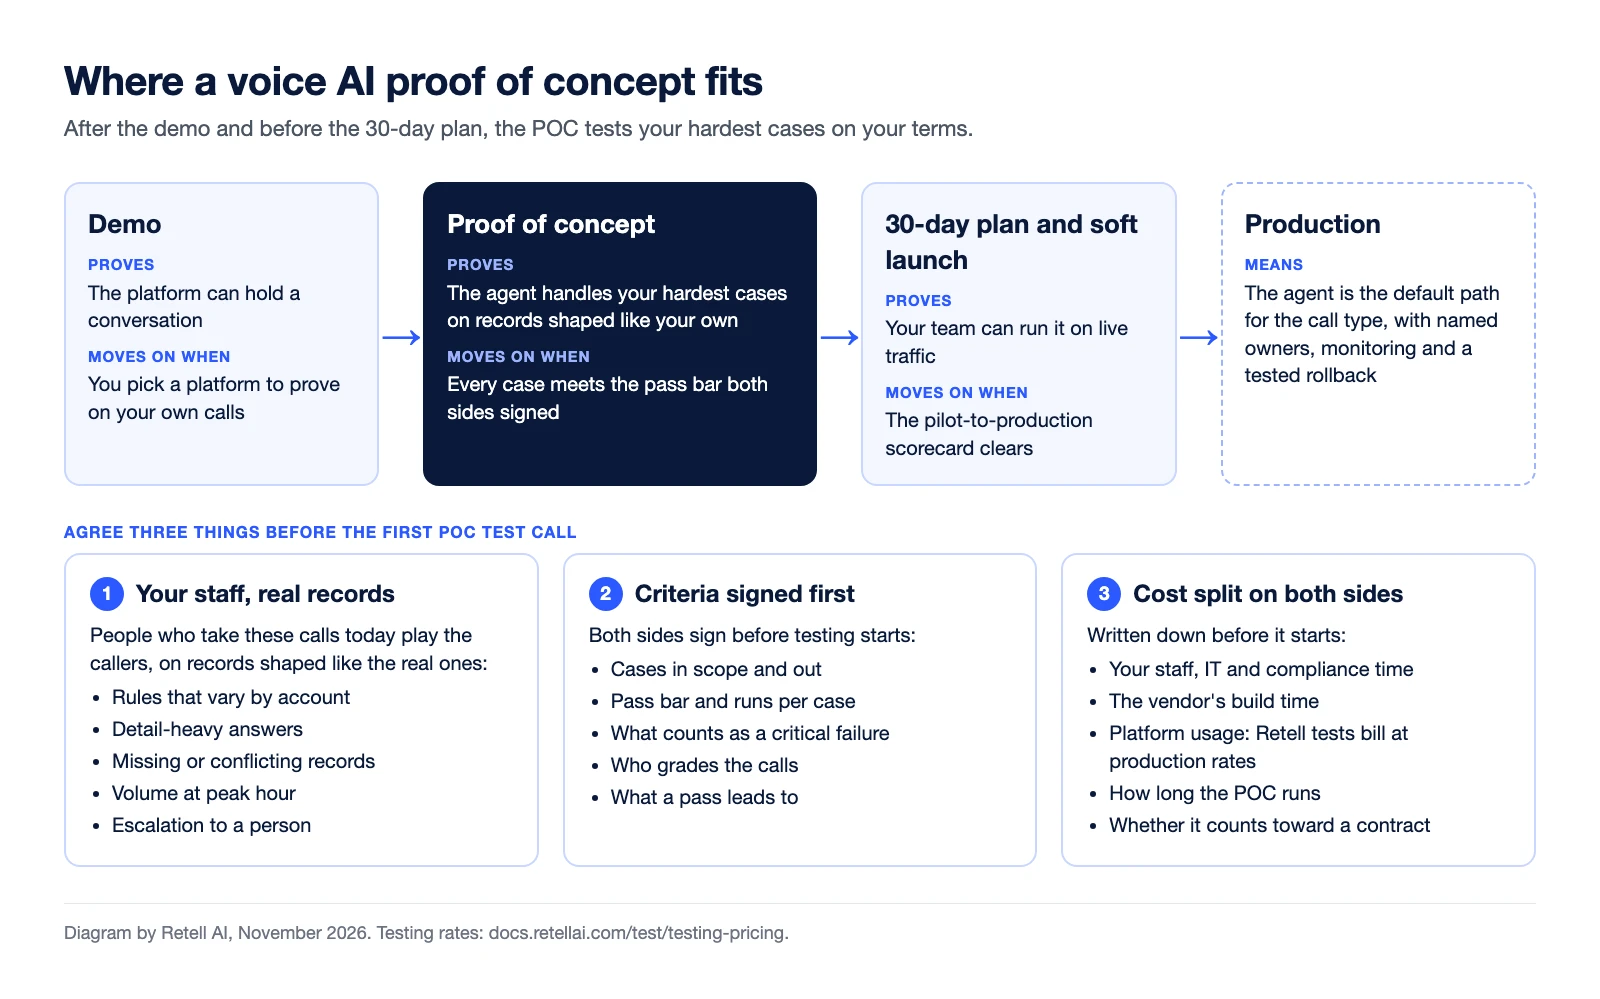
Führen Sie einen Sprach-KI-Proof-of-Concept (POC) mit den Anrufen, die die Demo ausgelassen hat, durch: Ihre eigenen Mitarbeitenden spielen Ihre schwierigsten Anrufer, auf Datensätzen, die wie Ihre echten aufgebaut sind, gegen Erfolgskriterien, die beide Seiten vorher unterzeichnet haben, und mit vorab vereinbarten Testkosten. Eine Demo spielt den Idealfall durch. Ein POC zeigt, ob der Agent bei den Regeln standhält, die Ihre Anrufe schwierig machen.
Testen Sie mit Ihren eigenen Mitarbeitenden auf echten Datensätzen
Fragen Sie die Personen, die diese Anrufe heute entgegennehmen, welche Fälle neue Mitarbeitende ins Straucheln bringen, und lassen Sie sie den Agenten als diese Anrufer anrufen. Führen Sie jeden Fall mit einem Datensatz durch, der wie der echte aufgebaut ist, denn ein sauberer Testdatensatz verbirgt, was ein unordentlicher offenlegt.
| Grenzfall | Was Ihre Mitarbeitenden testen | So sieht ein Bestehen aus |
|---|---|---|
| Regeln, die je nach Konto variieren | Dieselbe Anfrage von Anrufern, deren Datensätze unterschiedliche Regeln oder Ausnahmen enthalten | Der Agent wendet die Regel aus diesem Datensatz an, nicht die häufigste |
| Detailreiche Antworten | Fragen, die mehrere Felder gleichzeitig erfordern, etwa Daten, Beträge und Limits | Jedes Detail stimmt mit dem Datensatz überein, und der Agent sagt, was er nicht bestätigen kann |
| Fehlende oder widersprüchliche Datensätze | Kein Datensatz, ein Duplikat oder Angaben, die nicht zu den Aussagen des Anrufers passen | Der Agent prüft, fragt nach oder übergibt – und rät nie |
| Volumen | Last zur Spitzenzeit bei dem Traffic-Anteil, den der Pilot tragen wird, durchgeführt als Lasttest auf dem echten Anrufpfad | Anrufe werden verbunden und das Ergebnis hält bei dieser Last |
| Eskalation | Fälle, die eine Person erreichen müssen, innerhalb und außerhalb der Geschäftszeiten, auf einer echten Telefonleitung | Der Agent erkennt sie früh und leitet an die Person weiter, die Ihre Eskalationsmatrix benennt |
Klären Sie den Umgang mit Daten, bevor echte Datensätze in einen Test gelangen. Die Compliance-Dokumentation von Retell verlangt ein unterzeichnetes BAA, bevor geschützte Gesundheitsinformationen über Retell laufen. Wenn Ihre Regeln echte Datensätze noch nicht zulassen, bilden Sie deren Struktur nach: In einem Simulationstest von Retell legt jeder Fall eigene Werte für dynamische Variablen und gemockte Funktionsergebnisse fest. Klären Sie mit Ihrer Rechtsberatung oder Ihrem Compliance-Team, was Ihre Regeln erlauben.
Vereinbaren Sie die Erfolgskriterien vor dem Start des Piloten
Beide Seiten unterzeichnen die Kriterien vor dem ersten Testanruf, denn nachträglich formulierte Kriterien passen sich dem an, was der Agent zufällig getan hat. Benennen Sie die Fälle im Scope, die Bestehensgrenze und die Anzahl der Durchläufe pro Fall, was als kritischer Fehler gilt, wer bewertet und wozu ein Bestehen führt, damit das Bestehen in einer Entscheidung mündet statt in weiteren Tests. Für die Metriken nutzen Sie den Leitfaden zur Plattformbewertung; die Scorecard weiter unten in diesem Leitfaden betrifft eine andere Entscheidung.
Kalkulieren Sie die Testkosten auf beiden Seiten
Ihre Seite investiert Arbeitsstunden der Mitarbeitenden für das Tätigen und Bewerten von Anrufen sowie Zeit von IT und Compliance. Der Anbieter investiert Aufbauzeit, um einen Agenten an Ihre Regeln anzupassen. Hinzu kommt die Plattformnutzung: Laut den Testpreisen von Retell werden Tests zu Produktionstarifen abgerechnet, ohne kostenlose Sandbox, Sprache ab 0,07 $ pro Minute und Text pro Nachricht – führen Sie die meisten Fälle also als Text durch. Halten Sie schriftlich fest, wer welche Kosten trägt, wie lange der POC läuft und ob er auf einen Vertrag angerechnet wird. Eine feste Fallliste und ein festes Zeitfenster halten die Kosten für beide Seiten niedrig.
Wie sollten die ersten 30 Tage aussehen, Woche für Woche?
Vier Wochen, jede mit einem Ziel und einem klaren „Erledigt, wenn“. Beginnen Sie die nächste Woche erst, wenn die aktuelle abgeschlossen ist.
| Tage | Ziel | Erledigt, wenn |
|---|---|---|
| 1 bis 7 | Einen Anruftyp eingrenzen | Ein einseitiges Scope-Dokument ist von der fachlich verantwortlichen Person unterzeichnet |
| 8 bis 14 | Aufbauen und anbinden | Der Agent durchläuft den Hauptpfad vollständig auf einer Entwurfsversion |
| 15 bis 21 | Mit simulierten und echten Anrufen testen | Die Testsuite besteht mit dem von Ihnen festgelegten Schwellenwert, und Weiterleitungen funktionieren auf einer echten Telefonleitung |
| 22 bis 30 | Soft Launch und Monitoring | Ein Teil des Live-Traffics läuft eine Woche lang mit aktiven Alerts und täglicher Überprüfung |
Einen Anruftyp eingrenzen (Tag 1 bis 7)
Wählen Sie einen Anruftyp mit stetigem Volumen und einem Ergebnis, das Sie in einem führenden System prüfen können: ein gebuchter Termin, ein weitergeleiteter Lead, ein erstelltes Ticket. Ziehen Sie echte Aufzeichnungen oder Transkripte dieses Anruftyps heran, nicht das Skript, von dem Ihr Team glaubt, dass Anrufer ihm folgen.
Das Scope-Dokument sollte fünf Punkte beantworten:
- Den einen Anruftyp im Scope und jeden ausdrücklich ausgeschlossenen Anruftyp.
- Die Erfolgsmetrik, so definiert, dass ein System sie als wahr oder falsch markieren kann.
- Das eine führende System, aus dem der Agent liest oder in das er schreibt.
- Wohin Anrufe gehen, wenn der Agent nicht helfen kann, und zu welchen Zeiten.
- Wer die Formulierungen des Agenten freigibt und wer den Launch abzeichnet.
Aufbauen und anbinden (Tag 8 bis 14)
Bauen Sie auf einer Entwurfsversion auf. In Retell beginnt eine neue Version als Entwurf, den Sie bearbeiten und testen können; durch das Veröffentlichen wird sie schreibgeschützt, sodass Sie immer eine feste Konfiguration haben, zu der Sie zurückkehren können. Binden Sie nur das eine System aus Ihrem Scope an. Wenn diese Anbindung für Ihr Team neu ist, zeigt der Workflow vom CRM zur Sprach-KI, welche Daten an welchem Punkt des Anrufs fließen.
Richten Sie die Erfolgsmetrik jetzt ein, nicht erst nach dem Launch. Die Post Call Extraction von Retell läuft nach dem Ende jedes Anrufs und umfasst ein integriertes call_successful-Feld sowie benutzerdefinierte Felder, die Sie als Boolean, Text, Zahl oder Auswahl definieren. Ein Feld wie „appointment_booked“ ist das, was Sie in Woche vier visualisieren und mit Alerts überwachen.
Mit simulierten und echten Anrufen testen (Tag 15 bis 21)
Testen Sie zuerst per Text, dann per Sprache, dann über das Telefon. Die Simulationstests von Retell führen einen Testfall aus, ohne einen Anruf zu tätigen: Eine KI spielt den Anrufer anhand einer von Ihnen geschriebenen Persona, und der Durchlauf wird anhand Ihrer Erfolgskriterien mit Bestanden oder Nicht bestanden bewertet – inklusive schriftlicher Begründung. Gespeicherte Fälle laufen gemeinsam als Batch, der eine Bestehensquote ausgibt, sodass die Suite nach jeder Änderung zu Ihrem Regressionstest wird. Conductor, der Copilot im Dashboard von Retell, kann Testfälle von Grund auf oder aus echten Anrufen entwerfen.
Drei Dinge sollten Sie diese Woche richtig machen:
- Mocken Sie alles, was in ein Live-System schreibt. Die Dokumentation von Retell warnt, dass eine nicht gemockte benutzerdefinierte Funktion während eines Tests ihren echten Endpoint aufruft, sodass ein Test eine echte Buchung oder einen echten Datensatz erzeugen kann.
- Nutzen Sie Webanrufe für die Sprache und Telefonanrufe für die Telefonie. Bei einem Browser-Anruf hören Sie Unterbrechungen und Sprecherwechsel, aber Weiterleitungen an eine Telefonnummer schlagen dort fehl. Nutzen Sie einen echten Telefonanruf, um Weiterleitungen, Tastatureingaben und Carrier-Audio zu prüfen.
- Planen Sie das Budget ein. Tests werden in Retell zu Produktionstarifen abgerechnet: Texttests pro Nachricht, Sprachtests pro Minute.
Beenden Sie die Woche damit, dass Mitarbeitende so anrufen, wie echte Anrufer es tun würden – auch die schwierigen.
Soft Launch und Monitoring (Tag 22 bis 30)
Leiten Sie einen kleinen Anteil des echten Traffics an den Agenten, beobachten Sie ihn täglich und halten Sie einen Rollback mit einem Handgriff bereit. Für den ersten Anteil leitet Ihre für Telefonie verantwortliche Person einen Teil der Anrufe aus Ihrem bestehenden IVR oder Ihrer Warteschlange an die Nummer des Agenten weiter. Danach bietet Ihnen Retell drei Werkzeuge:
- A/B-Tests teilen den Traffic einer Telefonnummer prozentual zwischen Agenten auf, sodass ein Fix einen kleinen Anteil übernehmen kann, während der Rest beim bewährten Agenten bleibt.
- Environment-Tags verknüpfen eine Telefonnummer mit einer Version. Wird der
prod-Tag auf eine neue Version verschoben, laufen Live-Anrufe über diese; wird er zurückverschoben, erfolgt der Rollback. - Alert-Regeln senden eine E-Mail oder einen Webhook, wenn Anruferfolgsquote, Anrufvolumen, genutzte Concurrency, negatives Sentiment oder Kosten einen von Ihnen festgelegten Schwellenwert überschreiten.
Überprüfen Sie Anrufe jeden Tag. Die Call History lässt sich nach Ergebnis, Grund für die Verbindungsbeendigung und Agentenversion filtern. Mit Live Monitoring kann eine Supervisorin oder ein Supervisor ein Live-Transkript verfolgen, still mithören oder einen Anruf übernehmen. Das Analytics-Dashboard kann Ihr benutzerdefiniertes Extraktionsfeld neben dem Anrufvolumen darstellen, aufgeschlüsselt nach Agentenversion, sodass Sie sehen, ob ein Fix die Kennzahl bewegt hat. Wenn Sie strukturierte Bewertungen in großem Umfang benötigen, bewertet die AI QA von Retell eine Stichprobe von Anrufen anhand von Kriterien, die Sie festlegen.
Wer ist während des Rollouts wofür verantwortlich?
Eine verantwortliche Person pro Zeile. Geteilte Zeilen sind die Stellen, an denen Rollouts ins Stocken geraten.
| Arbeitsbereich | Verantwortlich auf Ihrer Seite | Rolle von Anbieter oder Partner |
|---|---|---|
| Scope, Erfolgsmetrik, Launch-Freigabe | Leitung von Contact Center oder Operations | Berät dazu, was in ein erstes Release passt |
| Aufbau des Agenten und Prompt-Änderungen | Ein Operations-Analyst oder Entwickler mit fest eingeplanter Zeit | Unterstützung bei der Implementierung, falls gebucht |
| Anbindung des führenden Systems | IT oder CRM-Admin | Dokumentiert die API und die Integrationsoptionen |
| Telefonnummern, Carrier- oder Contact-Center-Routing | Verantwortliche Person für Telefonie | Dokumentiert die Einrichtung; Support je nach Tarif |
| Testsuite und tägliche Anrufprüfung | Eine Teamleitung oder QA-Prüfer | Prüft die Suite, falls enthalten |
| Freigabe für Daten, Aufzeichnung und Compliance | Security oder Compliance | Stellt Vereinbarungen und Berichte bereit |
| Plattformvorfälle | Eskaliert | Verantwortlich, gemäß Ihrem Support-Level |
Am wichtigsten ist die zweite Zeile. Wenn niemand in Ihrem Team den Agenten ändern kann, ohne ein Ticket zu eröffnen, verbessert sich der Agent nur im Tempo der Warteschlange eines anderen. In immer mehr Teams gehört diese Zeile einem CX Automation Engineer: einer internen verantwortlichen Person, die den Agenten im Tagesgeschäft betreibt, nachdem die Forward Deployed Engineers des Anbieters beim Aufbau der ersten Version geholfen und das Team geschult haben.
Was sollten Sie einen Anbieter vor der Unterzeichnung zum Enablement fragen?
Fragen Sie schriftlich, welche Unterstützung Ihr Tarif umfasst und wen Sie anrufen, wenn der Aufbau ins Stocken gerät. Self-Service funktioniert, wenn Sie eine interne Person für den Aufbau mit ausreichend Zeit haben. Wenn nicht, kaufen Sie die Unterstützung von Anfang an ein, statt die Lücke in Woche zwei zu entdecken.
Bei Retell nennt die Preisseite Community- und E-Mail-Support für die nutzungsbasierte Abrechnung. Der Enterprise-Tarif umfasst 24/7-Support mit einem eigenen Portal, einen festen Account Manager sowie Dedicated Implementation Support als Add-on. Wenn Sie praktische Unterstützung beim Aufbau durch Dritte wünschen, listet das Verzeichnis der Lösungspartner von Retell zertifizierte Partner, die Sie nach Standort, Sprache, Integrationen, kostenloser Erstberatung und Preisspanne filtern können.
Fragen, die Sie jedem Anbieter stellen sollten:
- Welche Support-Kanäle und -Zeiten umfasst unser Tarif, und was gilt als dringend?
- Ist Unterstützung bei der Implementierung enthalten, ein Add-on oder wird sie über einen Partner erbracht? Was kostet sie, und ist der Preis fest oder wird er pro Projekt kalkuliert?
- Prüft jemand unseren Scope, das Agentendesign und die Testsuite vor dem Soft Launch?
- An wen wenden wir uns in der Soft-Launch-Woche, wenn etwas ausfällt, und wie schnell wird reagiert?
- Kann unser eigenes Team den gesamten Änderungszyklus (fehlgeschlagenen Anruf finden, beheben, testen, veröffentlichen, zurückrollen) ohne Tickets beim Anbieter durchlaufen?
- Wie werden Plattformvorfälle kommuniziert?
Wenn ein Partner mit Ihnen baut, erläutert wie Sprach-KI-Anbieter und Partner den ersten Deal eingrenzen die Aufteilung aus deren Sicht.
| Ihre Situation | Wahrscheinlicher Weg |
|---|---|
| Eine Person für den Aufbau mit fest eingeplanter Zeit und eine Standardintegration | Self-Service mit Dokumentation und Support gemäß Tarif |
| Eine Person für den Aufbau ist vorhanden, hat aber noch nie einen Sprach-Workflow live gebracht | Self-Service plus ein klar abgegrenztes Design-Review durch den Anbieter oder einen Partner |
| Niemand verantwortet den Aufbau, oder der Agent sitzt hinter einer Contact-Center-Plattform | Ein zertifizierter Partner oder Implementierungssupport des Anbieters ab dem ersten Tag |
Wie bewerten Sie einen KI-Piloten, bevor er in die Produktion geht?
Bewerten Sie den Piloten nach mindestens einer vollen Woche Live-Traffic anhand einer festen Scorecard, und überführen Sie ihn erst dann in die Produktion, wenn jede Gate-Zeile bestanden ist und die Gesamtpunktzahl eine in Woche eins festgelegte Grenze überschreitet. Die Scorecard macht aus „Es scheint gut zu laufen“ eine von drei Entscheidungen: ausbauen, anhalten und beheben oder neu eingrenzen.
Schreiben Sie die Grenze vor dem Soft Launch in das Scope-Dokument, damit niemand sie nach Ansicht der Zahlen herunterhandelt. Bewerten Sie jede Zeile mit 0 (nicht erfüllt), 1 (teilweise erfüllt) oder 2 (erfüllt). Gate-Zeilen müssen unabhängig von der Gesamtpunktzahl 2 erreichen. Neun Zeilen ergeben maximal 18 Punkte, und 16 ist eine sinnvolle Standardgrenze.
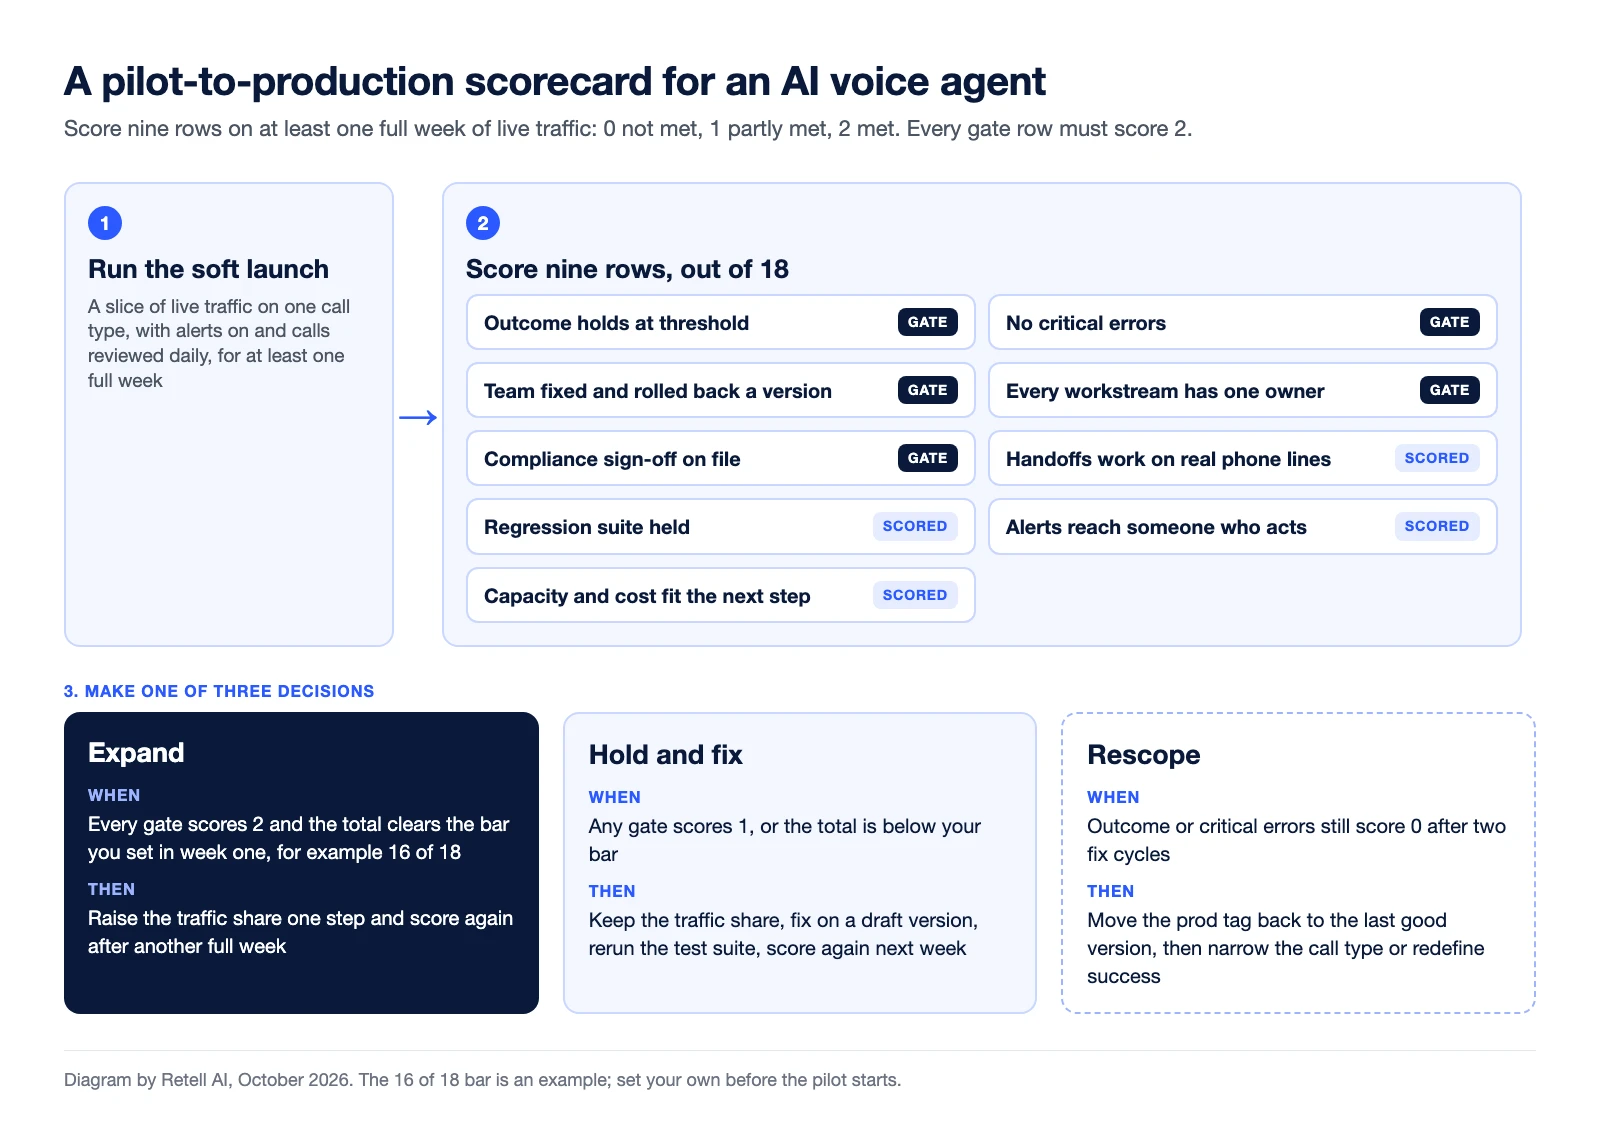
| Zeile | 2 Punkte, wenn | Nachweis | Typ |
|---|---|---|---|
| Ergebnis | Die Erfolgsmetrik liegt jeden Tag auf oder über Ihrem Schwellenwert | Ihr Extraktionsfeld nach Agentenversion dargestellt, stichprobenartig mit dem führenden System abgeglichen | Gate |
| Keine kritischen Fehler | Geprüfte Anrufe zeigen keine erfundenen Fakten und keine übersprungene Verifizierung oder vorgeschriebene Offenlegung | Ergebnisse der AI QA plus eine kleine, manuell bewertete Stichprobe | Gate |
| Änderungszyklus | Ihr Team hat einen fehlgeschlagenen Anruf auf einer Entwurfsversion behoben, getestet und veröffentlicht und eine Version gezielt zurückgerollt – ohne Ticket beim Anbieter | Versionsverlauf | Gate |
| Verantwortung | Jede Zeile der Verantwortungstabelle hat eine benannte Person, und der Eskalationskontakt bei Anbieter oder Partner ist schriftlich festgehalten | Die Verantwortungstabelle | Gate |
| Compliance | Freigaben für Datenaufbewahrung, Anrufaufzeichnung und Compliance liegen vor | Unterzeichnete Freigaben | Gate |
| Übergaben | Weiterleitungen erreichen die richtige Warteschlange auf einer echten Telefonleitung, innerhalb und außerhalb der Geschäftszeiten, und die Mitarbeitenden wissen, was der Anrufer bereits gesagt hat | Call History gefiltert nach Grund der Verbindungsbeendigung, plus einige vollständig angehörte Anrufe | Bewertet |
| Regressionssuite | Die Batch-Bestehensquote hat über die letzten zwei Änderungen gehalten, Schreibzugriffe auf Live-Systeme sind gemockt, und fehlgeschlagene Produktionsanrufe sind jetzt Testfälle | Batch-Testergebnisse | Bewertet |
| Monitoring | Alert-Regeln sind aktiv, jede erreicht eine Person, die handelt, und Anrufe wurden täglich geprüft | Alert-Einstellungen und die Notizen der täglichen Prüfung | Bewertet |
| Kapazität und Kosten | Die Concurrency deckt die Spitzenstunde beim nächsten Traffic-Anteil ab, und die Kosten pro gelöstem Anruf liegen im Budget | Concurrency-Limit und Abrechnung. Jedes Retell-Konto umfasst 20 gleichzeitige Anrufe, weitere kosten 8 $ pro gleichzeitigem Anruf und Monat | Bewertet |
| Entscheidung | Wann | Nächste Schritte |
|---|---|---|
| Ausbauen | Jede Gate-Zeile erreicht 2 und die Gesamtpunktzahl überschreitet Ihre Grenze | Erhöhen Sie den Traffic-Anteil um eine Stufe und bewerten Sie nach einer weiteren vollen Woche erneut |
| Anhalten und beheben | Eine Gate-Zeile erreicht 1 oder die Gesamtpunktzahl liegt unter Ihrer Grenze | Belassen Sie den Traffic-Anteil, beheben Sie Fehler auf einer Entwurfsversion, führen Sie die Testsuite erneut aus und bewerten Sie nächste Woche erneut |
| Neu eingrenzen | Ergebnis oder „Keine kritischen Fehler“ erreicht nach zwei Fix-Zyklen immer noch 0 | Verschieben Sie den prod-Tag zurück auf die letzte funktionierende Version, fassen Sie dann den Anruftyp enger oder definieren Sie Erfolg neu, bevor Sie Traffic hinzufügen |
Bewerten Sie bei jeder Erhöhung des Traffics erneut, denn was bei einem kleinen Anteil funktioniert hat, kann bei einem größeren scheitern. Die Zeile zum Änderungszyklus ist die, die Teams am ehesten überspringen möchten – und sie entscheidet, wie schnell sich der Agent in der Produktion verbessert. Behandeln Sie jede Prompt-Änderung als neue, testbare Version – eine Praxis, die als Prompt-Versionierung bekannt ist –, damit sich ein fehlgeschlagener Fix mit einem Handgriff rückgängig machen lässt.
Diese Scorecard dient dazu, einen Soft Launch auf einer bereits gewählten Plattform in die Produktion zu überführen. Um Anbieter in einem Pilotprojekt zu vergleichen, nutzen Sie die Go/No-Go-Liste im Leitfaden zur Plattformbewertung.
Was sollten Sie zuerst ausbauen?
Ändern Sie immer nur eine Sache. Erhöhen Sie zuerst den Traffic-Anteil, fügen Sie dann einen zweiten Anruftyp hinzu und danach ein zweites System. Jeder Ausbau nutzt denselben Zyklus: eingrenzen, auf einem Entwurf aufbauen, die Suite ausführen, Soft Launch, prüfen. Machen Sie aus jedem fehlgeschlagenen Produktionsanruf einen neuen Testfall, damit die Suite mit dem wächst, was Anrufer tatsächlich tun. Bevor Sie den Traffic deutlich erhöhen, führen Sie einen Lasttest durch, der dem echten Anrufpfad folgt.
Starten Sie mit dem richtigen Maß an Unterstützung
Die ersten 30 Tage verlaufen am schnellsten, wenn Sie vorab entscheiden, wie viel Unterstützung Sie brauchen. Vergleichen Sie auf der Preisseite, was die einzelnen Tarife von Retell umfassen, oder finden Sie – falls niemand in Ihrem Team den Aufbau verantworten kann – einen zertifizierten Partner im Verzeichnis der Lösungspartner von Retell.
Häufig gestellte Fragen
Was bedeutet „vom KI-Pilot in die Produktion“?
Vom KI-Pilot in die Produktion bezeichnet den Übergang von einem Test mit einem Teil des echten Traffics hin zum Betrieb eines KI-Agenten als Standardweg für einen Anruftyp – mit benannten Verantwortlichen, Monitoring und einem getesteten Rollback-Weg. Der Pilot beweist, dass der Agent den Anruf abschließen kann. Die Produktion beweist, dass Ihr Team ihn funktionsfähig halten kann.
Was sollte ein Sprach-KI-Proof-of-Concept umfassen?
Ihre schwierigsten echten Fälle, von Ihren eigenen Mitarbeitenden auf Datensätzen angerufen, die wie Ihre echten aufgebaut sind; Erfolgskriterien, die beide Seiten vor dem ersten Testanruf unterzeichnen; und eine schriftliche Aufteilung, wer Plattformnutzung, Aufbauzeit und Personalzeit bezahlt. Beschränken Sie ihn auf eine feste Fallliste und ein festes Zeitfenster, damit er in einer Entscheidung endet.
Können Sie einen Sprachagenten testen, ohne echte Kundendaten an den Anbieter zu senden?
Ja. Bilden Sie stattdessen die Struktur echter Datensätze in Testfällen nach. In Simulationstests von Retell legt jeder Fall eigene Werte für dynamische Variablen und gemockte Funktionsergebnisse fest. Mocken Sie jede Funktion, die ein Live-System erreicht, und geben Sie jedem Mock ein Ergebnis, denn ein leerer Mock führt die echte Funktion aus, und MCP-Tools ignorieren Mocks. Wenn echte Daten fließen müssen, unterzeichnen Sie zuerst die Vereinbarungen: Retell verlangt ein unterzeichnetes BAA, bevor geschützte Gesundheitsinformationen über die Plattform laufen. Klären Sie Ihre eigenen Regeln mit Ihrer Rechtsberatung oder Ihrem Compliance-Team.
Wie lange dauert ein Sprach-KI-Pilot vor der Produktion?
Planen Sie für einen Anruftyp etwa 30 Tage: jeweils eine Woche für Scope, Aufbau und Tests, danach einen Soft Launch mit einem Teil des Live-Traffics. Bewerten Sie den Piloten nach mindestens einer vollen Woche mit Live-Anrufen und erneut bei jeder Erhöhung des Traffics.
Woran erkennen Sie, dass ein Sprachagent bereit für die Produktion ist?
Wenn jede Gate-Zeile der Scorecard über eine volle Woche Live-Traffic 2 Punkte erreicht: Die Erfolgsmetrik hält, geprüfte Anrufe weisen keine kritischen Fehler auf, Ihr Team hat ohne Hilfe des Anbieters eine Version behoben und zurückgerollt, jeder Arbeitsbereich hat eine benannte verantwortliche Person, und die Compliance-Freigabe liegt vor.
Was sollten Sie tun, wenn der Pilot hinter den Erwartungen zurückbleibt?
Halten Sie den Traffic-Anteil, oder verschieben Sie den Produktions-Tag zurück auf die letzte funktionierende Version. Beheben Sie Fehler auf einer Entwurfsversion, führen Sie die Testsuite erneut aus und bewerten Sie nach einer weiteren Woche erneut. Wenn die Zeile zum Ergebnis oder zu kritischen Fehlern nach zwei Fix-Zyklen immer noch 0 erreicht, fassen Sie den Anruftyp enger oder definieren Sie Erfolg neu.
Sehen Sie, wie viel Ihr Unternehmen durch den Wechsel zu KI-gestützten Sprachagenten sparen könnte.
ROI-Ergebnis
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Eine Demo-Telefonnummer von Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs
Revolutionieren Sie Ihren Anrufbetrieb mit Retell


