Il ragionamento interlacciato (interleaved reasoning) è un modo di eseguire un modello di ragionamento in cui il modello alterna ragionamento privato e azioni visibili, come chiamate agli strumenti o parti della risposta, invece di completare tutto il ragionamento prima di rispondere.
È chiamato anche pensiero interlacciato (interleaved thinking). La documentazione dei fornitori usa il termine soprattutto per il ragionamento tra una chiamata agli strumenti e l'altra. Gli articoli di ricerca lo usano per un modello che alterna il pensiero a parti della risposta. Entrambi descrivono lo stesso cambiamento: il ragionamento smette di essere un unico blocco all'inizio del turno.
Che cos'è un modello di ragionamento?
Un modello di ragionamento è un large language model che genera un ragionamento intermedio prima della risposta. La guida al ragionamento di OpenAI lo riassume in una riga: "I modelli di ragionamento usano token di ragionamento interni prima di produrre una risposta." La documentazione di Gemini di Google afferma che un modello di pensiero "ragiona internamente prima di rispondere", e la documentazione di DeepSeek spiega che la sua modalità di pensiero produce un ragionamento a catena (chain-of-thought) "per migliorare l'accuratezza della risposta finale".
Che cosa sono i token di ragionamento?
I token di ragionamento, chiamati anche token di pensiero, sono i token che un modello genera mentre lavora su un problema. Non fanno parte della risposta. Contano tre proprietà:
- Vengono fatturati. OpenAI afferma che i token di ragionamento "vengono fatturati come token di output". La documentazione di Anthropic sul pensiero dice lo stesso per Claude, "anche quando il testo del pensiero non ti viene restituito". Google calcola il prezzo di una risposta come "la somma dei token di output e dei token di pensiero".
- Spesso sono nascosti. I token di ragionamento di OpenAI "non sono visibili tramite l'API". Anthropic afferma che ciò che vedi "non è mai la catena di pensiero grezza". Entrambi possono restituire un riepilogo se lo richiedi.
- Richiedono tempo e spazio. OpenAI afferma che un modello può generare "da poche centinaia a decine di migliaia di token di ragionamento" per una singola richiesta, e questi occupano la finestra di contesto.
Gli sviluppatori ne controllano la quantità con un'impostazione: reasoning effort in OpenAI, effort in Anthropic, thinking level in Google.
In cosa il ragionamento interlacciato è diverso dal ragionamento think-first?
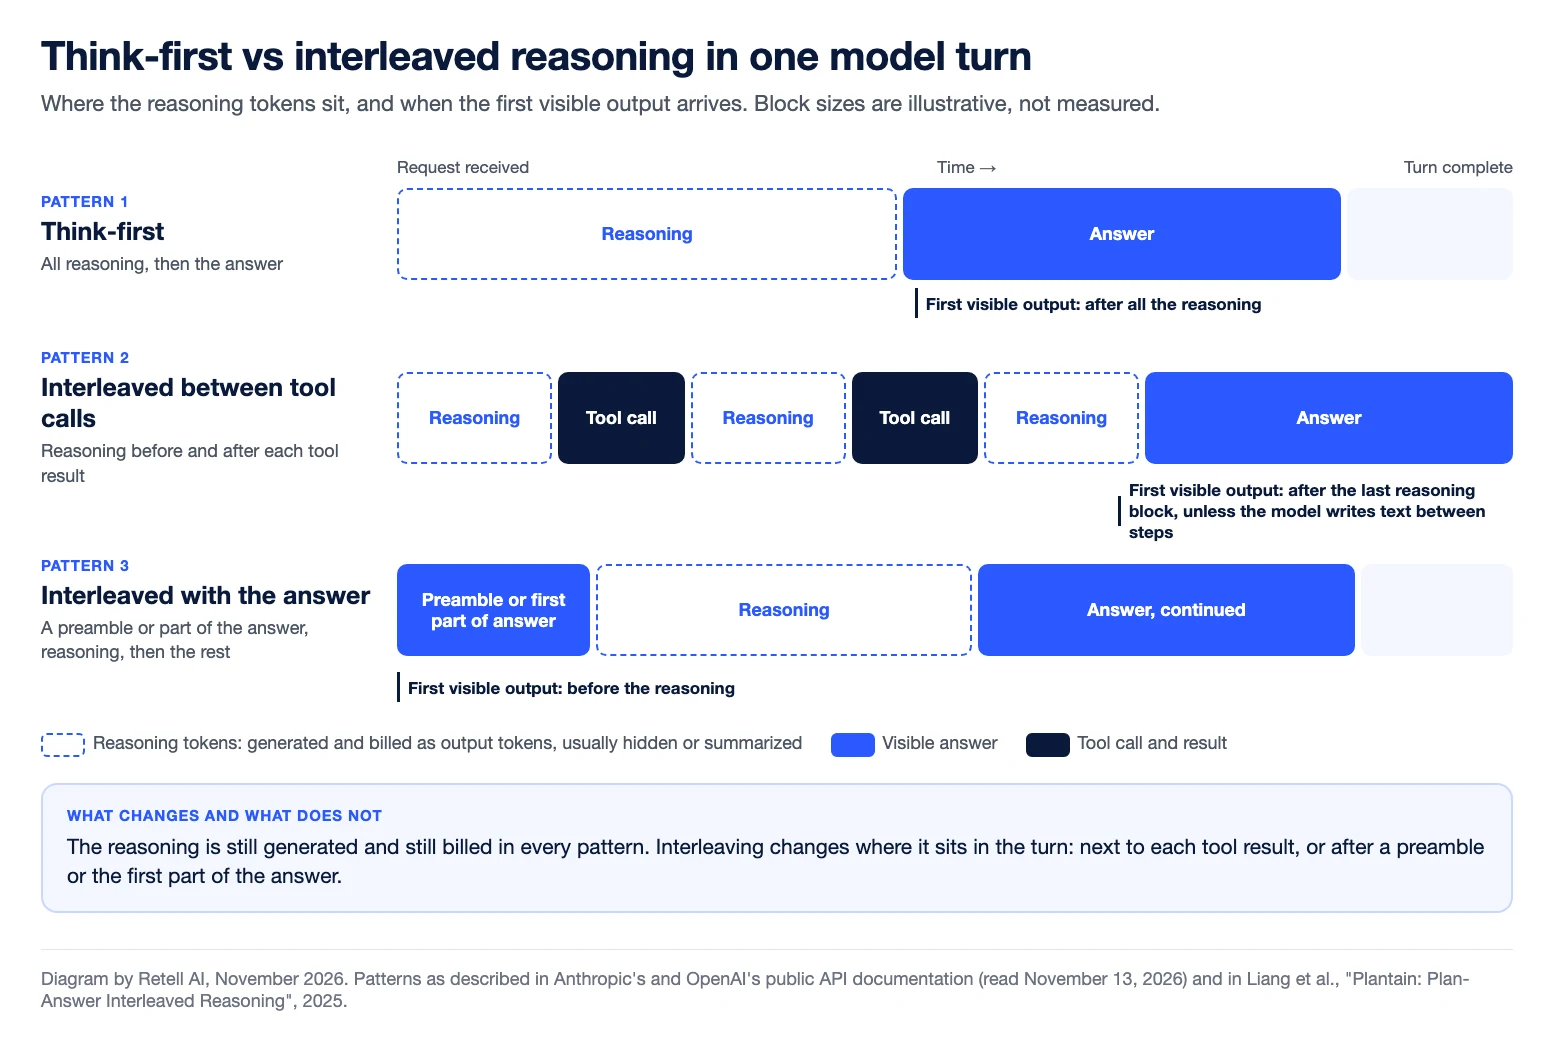
Nel ragionamento think-first, tutto il ragionamento avviene prima del primo token visibile. Anthropic lo chiama pensiero anticipato (up-front thinking): i blocchi di pensiero "arrivano prima dei blocchi di testo". Il ragionamento interlacciato suddivide il ragionamento in blocchi più piccoli e li colloca dove servono.
| Schema | Ordine del lavoro in un turno | Prima cosa che vede l'utente | Descritto pubblicamente da |
|---|---|---|---|
| Nessun ragionamento | Risposta | L'inizio della risposta | Qualsiasi modello con il ragionamento disattivato |
| Think-first | Tutto il ragionamento, poi la risposta | Nulla finché il ragionamento non termina | Anthropic (pensiero anticipato), DeepSeek |
| Interlacciato tra chiamate agli strumenti | Ragiona, chiama uno strumento, legge il risultato, ragiona di nuovo, poi risponde | Nulla finché non termina l'ultimo blocco di ragionamento, a meno che il modello non scriva testo tra un passaggio e l'altro | Anthropic, OpenAI, vLLM, DeepSeek (senza usare il termine) |
| Interlacciato con la risposta | Un preambolo o una parte della risposta, ragionamento, altra parte della risposta | Un preambolo o una prima parte della risposta | OpenAI, articoli di ricerca |
| Interlacciato con il parlato | Prima frase della risposta, ragionamento silenzioso mentre viene riprodotta, poi il resto della risposta | La prima frase della risposta | Tell-1, l'LLM proprietario di Retell |
Cosa documentano oggi i fornitori?
Consultato il 13 novembre 2026:
- Anthropic. "Il pensiero interlacciato consente a Claude di pensare tra una chiamata agli strumenti e l'altra, ragionando su ogni risultato prima di agire." È automatico sui modelli che supportano l'adaptive thinking. I modelli con extended thinking manuale richiedono un header beta.
- OpenAI. Modelli come gpt-5.5 "supportano il pensiero interlacciato, in cui il modello è in grado di generare token di output visibili prima e durante il pensiero, e di pensare tra una chiamata agli strumenti e l'altra".
- Google. La pagina sul pensiero di Gemini non usa il termine. Afferma che i passaggi di pensiero "compaiono in ordine cronologico insieme alle chiamate di funzione, agli input dell'utente o agli output del modello", e che le firme di pensiero (thought signatures) sono "necessarie per mantenere la continuità del ragionamento nelle interazioni a più turni".
- vLLM. Il server di inferenza open source supporta il pensiero interlacciato per due serie di modelli e avverte che "aumenta l'uso di token e la latenza di risposta".
In ambito di ricerca, Xie et al. (2025) hanno addestrato modelli "ad alternare pensiero e risposta" e riportano una riduzione del tempo al primo token di oltre l'80% in media. Liang et al. (2025) definiscono il ragionamento interlacciato come un modello che "alterna il pensiero alla presentazione di risposte intermedie" e riportano che la loro variante con pianificazione iniziale, Plantain, ha ridotto il tempo alla prima risposta di oltre il 60%. Entrambi gli studi riguardavano attività testuali.
Perché il ragionamento think-first costa silenzio durante una telefonata?
In una telefonata, la sintesi vocale non può iniziare finché il modello non produce le prime parole della risposta. Ogni token di ragionamento generato prima di quelle parole è tempo in cui chi chiama non sente nulla. In una finestra di chat la stessa attesa è un indicatore di avanzamento. In una chiamata è silenzio e latenza aggiuntiva.
La documentazione di Retell sulla risoluzione dei problemi di latenza afferma che i modelli più grandi e orientati al ragionamento "sono più lenti al primo token" e "sacrificano la latenza in cambio di capacità". OpenAI indica la voce come caso d'uso comune per l'esecuzione con reasoning effort impostato su none e suggerisce che le applicazioni sensibili alla latenza "chiedano al modello di generare un breve preambolo prima di proseguire con un ragionamento più approfondito". La guida al miglior LLM per agenti vocali con IA approfondisce la scelta del modello.
Che cos'è il ragionamento interlacciato in un agente vocale?
In un agente vocale, il ragionamento interlacciato significa che il modello scrive subito la prima frase della risposta, ragiona in silenzio mentre quella frase viene pronunciata e poi prosegue la risposta basandosi su quel ragionamento. Chi chiama sente un'unica risposta senza interruzioni e il ragionamento non viene mai pronunciato.
Tell-1 funziona così. L'articolo tecnico di Retell, Retell LLM: ragionamento interlacciato per agenti vocali in tempo reale, descrive il formato come "un'apertura parlata, poi il ragionamento, poi il resto della risposta". L'articolo riporta in media 200 token di ragionamento a metà risposta e che nel 99,98% dei turni la pausa dopo la prima frase è inferiore a 400 ms.
Rispetto al ragionamento think-first, chi chiama non attende in silenzio che il ragionamento finisca. L'articolo indica anche il compromesso: "parlare prima significa impegnarsi sull'apertura prima che sia avvenuto qualsiasi ragionamento". Tell-1 si classifica al n. 1 assoluto nel Retell vCX Benchmark (a novembre 2026).
Domande frequenti sul ragionamento interlacciato
Il ragionamento interlacciato è la stessa cosa del pensiero interlacciato?
Sì, nella maggior parte dei casi. Anthropic e OpenAI parlano di interleaved thinking (pensiero interlacciato); gli articoli di ricerca tendono a parlare di interleaved reasoning (ragionamento interlacciato).
I token di ragionamento vengono fatturati?
Sì. OpenAI, Anthropic e Google li conteggiano tutti nell'output fatturato. OpenAI e Anthropic li fatturano anche quando il testo del ragionamento non viene restituito.
Puoi leggere i token di ragionamento di un modello?
Di solito no. OpenAI e Anthropic possono restituire un riepilogo se lo richiedi. Nessuno dei due restituisce il ragionamento grezzo.
Il ragionamento interlacciato fa rispondere un modello più velocemente?
Non di per sé. Tra le chiamate agli strumenti aggiunge token, e la documentazione di vLLM avverte che aumenta la latenza di risposta. Il primo output visibile arriva prima solo quando l'output visibile precede il ragionamento, o si inserisce tra blocchi di ragionamento più brevi.
Che cos'è il ragionamento interlacciato nell'IA vocale?
È un modello che inizia subito a parlare, ragiona in silenzio mentre viene riprodotta la sua prima frase, poi completa la risposta usando quel ragionamento. Tell-1, l'LLM proprietario di Retell, è progettato in questo modo.
Esegui modelli di ragionamento sulle chiamate dal vivo
Retell AI è una piattaforma di agenti vocali con IA per i contact center. Scegli tu il modello alla base di ogni agente. Tell-1 è uno di questi. Parla con il team di Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


