La session affinity, detta anche sticky session o persistenza della sessione, è una tecnica di bilanciamento del carico che invia ogni richiesta proveniente dallo stesso client o dalla stessa sessione allo stesso server di backend. In questo modo lo stato conservato nella memoria di quel server resta raggiungibile.
Senza session affinity, ogni richiesta viene instradata in modo indipendente. AWS spiega che un Application Load Balancer per impostazione predefinita "instrada ogni richiesta in modo indipendente verso un target registrato" e che la funzionalità di sticky session gli consente di "associare la sessione di un utente a un target specifico". Questo conta quando un server conserva localmente qualcosa di cui la richiesta successiva ha bisogno: una sessione di login, un carrello o una cache.
Come implementano la session affinity i load balancer?
Un load balancer ha bisogno di un modo per riconoscere la sessione e di una regola che la associ a un server. Tre metodi coprono la maggior parte dei prodotti.
Cookie. Il load balancer imposta un cookie nella prima risposta e lo legge nelle richieste successive. La stickiness basata sulla durata di AWS usa un cookie chiamato AWSALB, con una durata che puoi impostare tra 1 secondo e 7 giorni. HAProxy usa un cookie per "ricordare verso quale server era stato instradato il client in precedenza". Il client deve supportare i cookie.
IP hash. È l'indirizzo IP del client a scegliere il server. ip_hash di NGINX usa come chiave di hashing "i primi tre ottetti dell'indirizzo IPv4 del client, o l'intero indirizzo IPv6". Un Service di Kubernetes offre lo stesso meccanismo con sessionAffinity: ClientIP, con un timeout predefinito di 3 ore. Nessuno dei due richiede un cookie. Però i client dietro un unico indirizzo condiviso finiscono sullo stesso server e, con NGINX, lo stesso accade a chiunque condivida quei tre ottetti.
Consistent hashing. Il load balancer calcola l'hash di una proprietà della richiesta, come un header o un ID di sessione, e lo mappa su un anello di server. Envoy spiega che, con un anello ben partizionato, aggiungere o rimuovere un host da un insieme di N "influirà solo su 1/N delle richieste". La direttiva hash di NGINX ha un'opzione consistent che, secondo la documentazione, "aiuta a ottenere un tasso di cache hit più elevato per i server di caching".
| Metodo | Cosa identifica la sessione | Esempio documentato | Limite principale |
|---|---|---|---|
| Cookie | Un cookie impostato dal load balancer o dall'applicazione | AWS Application Load Balancer, HAProxy | Il client deve supportare i cookie |
| IP hash | L'indirizzo IP del client | NGINX ip_hash, Kubernetes ClientIP | I client dietro un indirizzo condiviso si accumulano su un solo server |
| Consistent hashing | Qualsiasi proprietà della richiesta a tua scelta | Envoy ring hash e Maglev, NGINX hash ... consistent | Ogni richiesta deve contenere una chiave stabile |
| Routing basato sul prefisso | I token iniziali di un prompt LLM | Prompt caching di OpenAI, Ray Serve | Il carico conta comunque, quindi un server occupato può perdere la richiesta |
Quali sono i compromessi delle sticky session?
La session affinity sacrifica un po' di bilanciamento e di resilienza in cambio di uno stato mantenuto vicino.
- Il carico può sbilanciarsi. Google Cloud spiega che l'affinity "funziona bene quando c'è una distribuzione ragionevolmente ampia di connessioni univoche". Con poche sessioni o con sessioni distribuite in modo non uniforme, alcuni server si fanno carico di più lavoro, a scapito della scalabilità.
- Un server guasto mette fine all'affinity. Su AWS, se un target si guasta, il load balancer "sceglie un nuovo target integro" e mantiene lì la sessione "anche se il target guasto torna disponibile". Tutto ciò che era conservato solo nella memoria del vecchio server deve essere ricostruito.
- Funziona secondo il principio del best effort. Google Cloud fornisce la session affinity "secondo il principio del best effort". Tra gli eventi che possono interromperla indica le variazioni dei controlli di integrità, l'aggiunta o la rimozione di backend e la saturazione dei backend.
La documentazione di HAProxy dà il consiglio standard: "Spesso la soluzione ottimale è evitare del tutto la persistenza della sessione progettando i servizi in modo che siano stateless", ad esempio salvando lo stato in un database condiviso. L'affinity serve per lo stato che non puoi spostare a basso costo. Il caso tipico è una cache.
Perché la session affinity è importante per il serving degli LLM?
È importante perché la cache che rende economico un prompt ripetuto risiede su una sola macchina. Un server del modello conserva in memoria lo stato calcolato di un prompt, la KV cache. vLLM la riutilizza quando una nuova query "condivide lo stesso prefisso con una delle query esistenti, consentendo alla nuova query di saltare il calcolo della parte condivisa".
Questo funziona solo se la richiesta successiva raggiunge la stessa macchina. La guida al prompt caching di OpenAI lo afferma chiaramente: "Gli stati in cache risiedono su singole macchine" e "una richiesta può riutilizzare un prefisso in cache solo se raggiunge una macchina che contiene una voce corrispondente non ancora scaduta". OpenAI instrada le richieste in base a tre fattori: il carico della macchina, un hash dei token iniziali del prompt e, sui modelli meno recenti, una chiave di cache fornita da te. Per i modelli self-hosted, Ray Serve include un router che "instrada le richieste con prefissi simili verso le stesse repliche, massimizzando il tasso di hit della KV cache". Quando le code sono sbilanciate, ripiega sul semplice bilanciamento del carico.
Le telefonate si adattano molto bene a questo schema. A ogni turno di una conversazione multi-turno, un agente vocale invia al large language model le proprie istruzioni più la trascrizione fino a quel momento, perché il modello non conserva la chiamata tra una richiesta e l'altra. Ogni richiesta ripete gran parte della precedente. Quindi la chiamata è la sessione e l'ID della chiamata è una chiave naturale. Un turno che arriva su un server diverso elabora di nuovo l'intero prompt, aumentando la latenza.
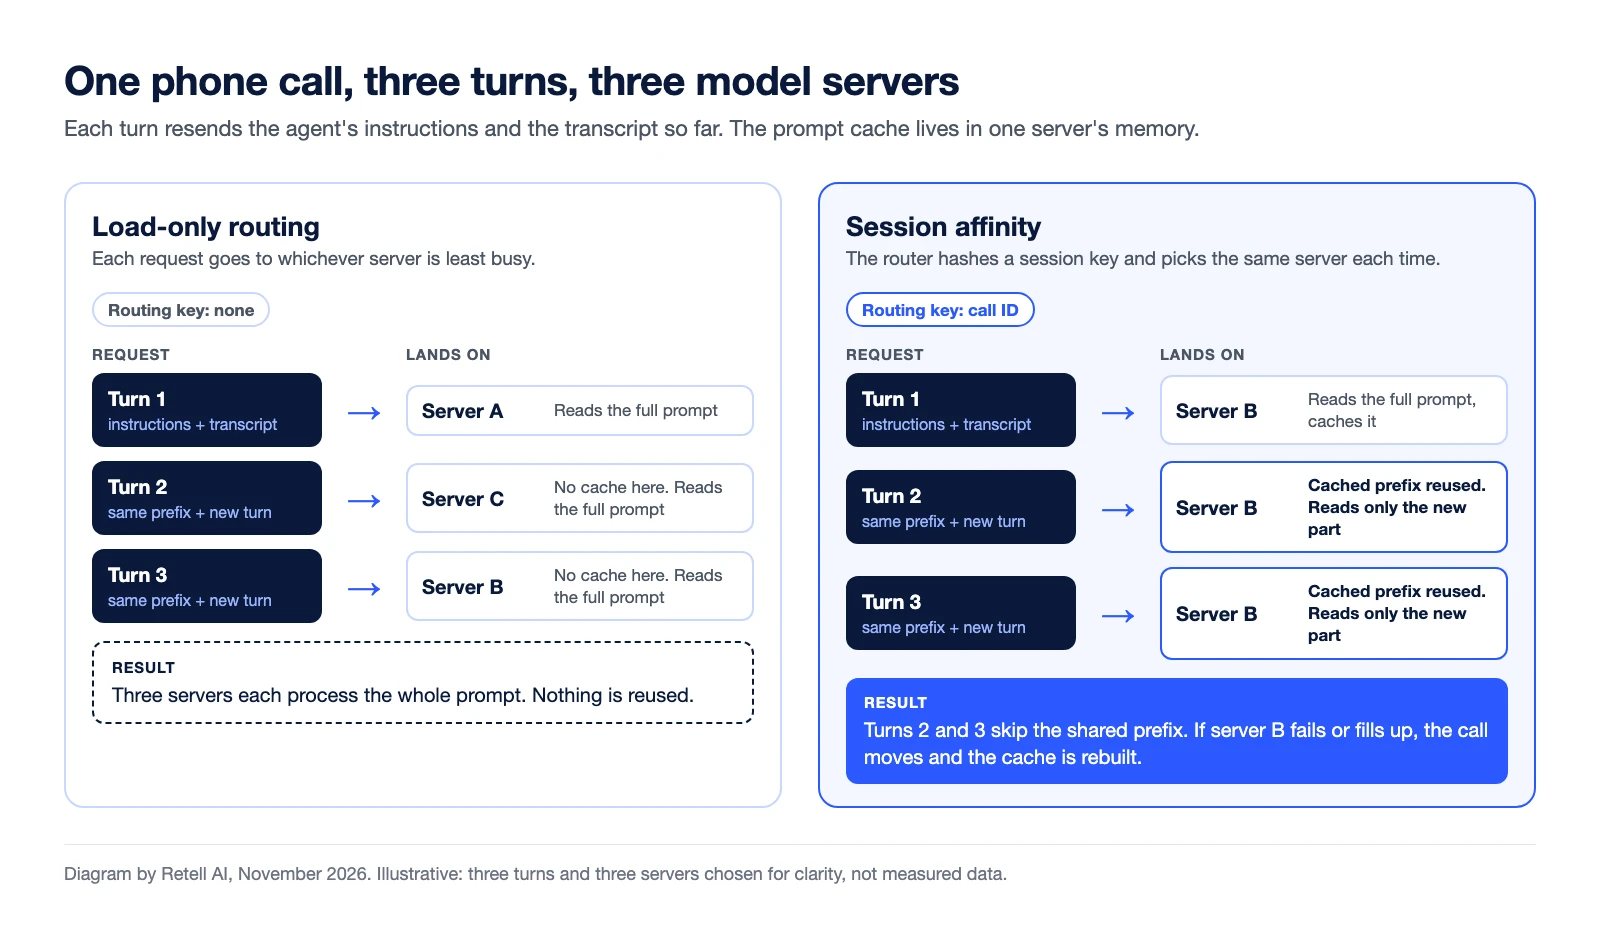
Tell-1, l'LLM proprietario di Retell, viene servito proprio in questo modo. Il post tecnico sull'LLM di Retell chiama questo approccio call-aware routing, cioè instradamento basato sulla chiamata. Poiché a ogni turno viene reinviata l'intera conversazione, ogni chiamata viene mantenuta sulle GPU che la hanno già in cache. Secondo il post, questo ha portato la quota di token del prompt serviti dalla cache dal 36% al 69%.
Dove entra in gioco la session affinity su Retell
Entra in gioco quando esegui un tuo server del modello. Con un LLM personalizzato, Retell "apre un WebSocket verso il tuo server per ogni chiamata", con l'ID della chiamata come ultimo segmento del percorso dell'URL. AWS osserva che "le connessioni WebSocket sono intrinsecamente sticky", quindi una chiamata resta su uno dei tuoi server finché il suo socket è aperto.
Le best practice di Retell consigliano di mantenere "uno stato esplicito per chiamata sul tuo server, indicizzato in base all'ID della chiamata presente nell'URL del WebSocket". Inoltre Retell ricostruisce una connessione che cade a metà chiamata. Se esegui più server dietro un load balancer, il nuovo socket può raggiungerne uno diverso. Per mantenere lo stato raggiungibile, instrada in base all'ID della chiamata nel percorso, oppure conserva quello stato in uno storage condiviso. In questo caso l'IP hash non distribuisce il carico. La guida alla configurazione indica un unico indirizzo IP in uscita per questa connessione, quindi l'hash di ogni chiamata porta sempre allo stesso server.
Domande frequenti sulla session affinity
La session affinity è la stessa cosa delle sticky session?
Sì. AWS descrive la sua funzionalità di sticky session come "nota anche come session affinity". Persistenza della sessione è un terzo nome per la stessa cosa.
Cosa succede a una sticky session quando il server si guasta?
Il load balancer sceglie un altro server integro e la sessione resta associata a quello. Lo stato che risiedeva solo nella memoria del server guasto va perso, a meno che non fosse salvato anche in uno storage condiviso.
Le connessioni WebSocket hanno bisogno di sticky session?
Non finché la connessione è aperta, perché ogni messaggio viaggia sulla stessa connessione verso lo stesso server. L'affinity torna importante quando il client si riconnette.
Perché la session affinity è importante per il prompt caching?
Una prompt cache risiede nella memoria della macchina che l'ha creata. Una richiesta successiva ottiene il prefisso in cache solo se viene instradata verso quella macchina.
Porta il tuo modello nelle chiamate dal vivo
Retell AI è una piattaforma di agenti vocali con IA per i contact center. Retell gestisce telefonia, trascrizione, turni di conversazione e sintesi vocale. L'integrazione con LLM personalizzato collega il tuo server del modello tramite un WebSocket per chiamata.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


