L'SSML (Speech Synthesis Markup Language) è un linguaggio di markup basato su XML che indica a un motore di sintesi vocale (text-to-speech) come pronunciare un testo: dove fare una pausa, come pronunciare una parola, come leggere un numero o una data e con quale velocità, volume o tono parlare. Il motore interpreta i tag come istruzioni e non li pronuncia.
L'SSML è uno standard del World Wide Web Consortium (W3C). La versione attuale, SSML 1.1, è diventata una W3C Recommendation il 7 settembre 2010 ed è stata elaborata dal Voice Browser Working Group del W3C. La specifica dichiara di voler offrire agli autori «un modo standard per controllare aspetti del parlato come pronuncia, volume, tono, velocità, ecc. su diverse piattaforme in grado di effettuare la sintesi».
Che aspetto ha l'SSML?
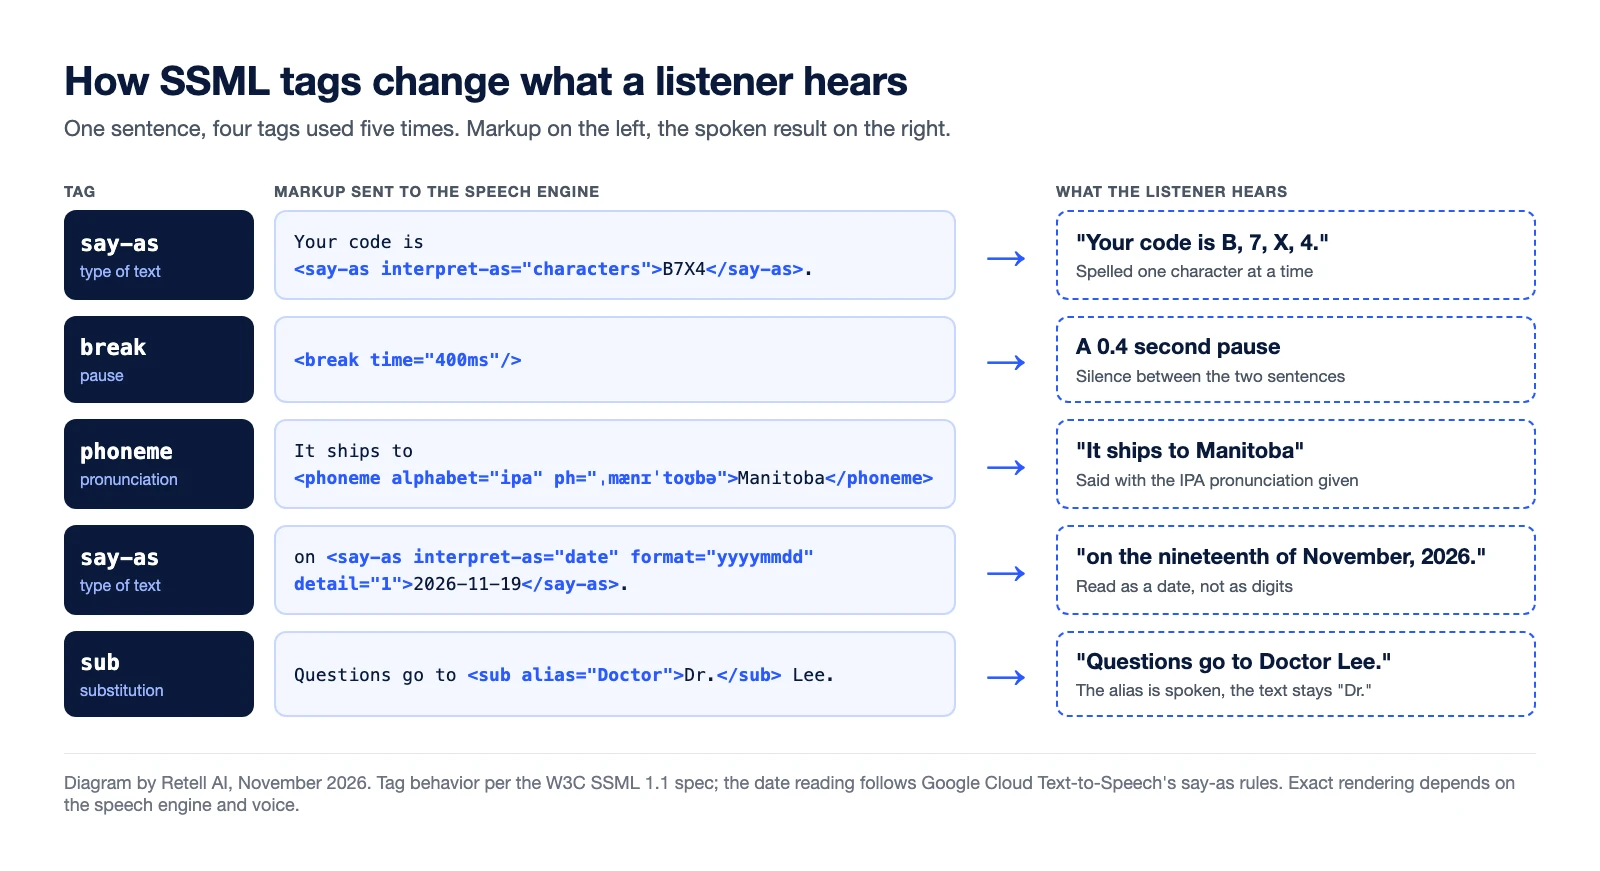
Un documento SSML è un file XML con un unico elemento radice, <speak>. Questo breve esempio è SSML 1.1 valido:
<speak version="1.1" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="en-US">
  Your code is <say-as interpret-as="characters">B7X4</say-as>.
  <break time="400ms"/>
  It ships to <phoneme alphabet="ipa" ph="ˌmænɪˈtoʊbə">Manitoba</phoneme>
  on <say-as interpret-as="date" format="yyyymmdd" detail="1">2026-11-19</say-as>.
  Questions go to <sub alias="Doctor">Dr.</sub> Lee.
</speak>
La figura mostra cosa sente chi ascolta per ciascun tag, quando il motore lo supporta.
Quali sono i tag SSML più comuni?
Le descrizioni seguono la specifica W3C.
| Tag | Cosa fa | Esempio |
|---|---|---|
<speak> | Elemento radice di ogni documento SSML. In SSML 1.1 gli attributi version e xml:lang sono obbligatori, insieme al namespace SSML. | <speak version="1.1" xml:lang="en-US"> |
<break> | Aggiunge una pausa o un confine prosodico, impostato tramite strength (da none a x-strong) o tramite time. | <break time="400ms"/> |
<say-as> | Indica al motore che tipo di testo sta leggendo, ad esempio una data, un orario, un numero o un importo in valuta. | <say-as interpret-as="characters">B7X4</say-as> |
<phoneme> | Fornisce una pronuncia fonetica per il testo racchiuso. La specifica afferma che i motori dovrebbero supportare l'alfabeto ipa. | <phoneme alphabet="ipa" ph="..."> |
<sub> | Pronuncia il valore di alias al posto del testo scritto. | <sub alias="Doctor">Dr.</sub> |
<prosody> | Modifica tono, velocità di eloquio e volume del testo racchiuso. | <prosody rate="slow"> |
<emphasis> | Richiede l'accento su una parola o una frase, con un level tra strong, moderate, none o reduced. | <emphasis level="strong"> |
Due dettagli della specifica spiegano perché i risultati variano. Primo, definisce <say-as> ma «non elenca i possibili valori degli attributi», quindi l'elenco dei valori di interpret-as è specifico di ciascun fornitore. Secondo, definisce i valori di prosodia «indicativi» e lascia al motore la decisione su come rendere l'enfasi.
In cosa differisce il supporto SSML tra i motori vocali?
Ogni motore implementa un proprio sottoinsieme, e i modelli vocali più recenti spesso supportano meno markup di quelli precedenti. Dalla documentazione di ciascun fornitore, consultata il 13 novembre 2026:
- Google Cloud Text-to-Speech supporta «un sottoinsieme dei tag SSML disponibili». Le sue voci Chirp 3: HD accettano dieci tag senza
<emphasis>, gli altri tag «verranno ignorati» e le richieste in streaming non accettano SSML. - Amazon Polly elenca il supporto dei tag per tipo di voce.
<emphasis>non è disponibile sulle voci neurali, long-form o generative, e un tag non supportato sulle voci standard, neurali o long-form restituisce un errore. - Azure AI Speech basa la propria implementazione su SSML 1.0 e afferma che gli elementi supportati «possono differire dallo standard W3C». Aggiunge propri elementi
msttsper gli stili di eloquio, e l'enfasi a livello di parola funziona su tre specifiche voci inglesi. - ElevenLabs supporta due tag SSML su alcuni modelli:
<break>per pause fino a 3 secondi e<phoneme>solo su Flash v2. Eleven v3 e v4 non supportano i tag break. - Cartesia Sonic documenta propri tag «simili a SSML»: speed, volume, emotion, break e spell.
Lo stesso documento può essere rispettato da un motore, ignorato silenziosamente da un altro e rifiutato da un terzo. Testa il markup sulla voce e sul modello esatti che userai.
Perché l'SSML è importante per gli agenti vocali?
Chi chiama non può vedere il testo. Nell'IA vocale, una lettura sbagliata costa una ripetizione o un dato registrato in modo errato:
- Nomi. Pronunce di marchi, farmaci e cognomi che la voce sbaglia.
- Numeri. Un codice di conferma letto come una sola parola, o un numero di conto letto come una quantità.
- Date e orari. Una data come 11/19 letta come due numeri separati.
- Pause. Il tempo per annotare ciascun gruppo di cifre di un numero di telefono.
L'SSML è adatto ai prompt predefiniti, in cui uno sviluppatore tagga ogni riga una sola volta. Funziona bene per un menu IVR. Si adatta meno a un agente vocale con IA in tempo reale.
Come gestiscono la pronuncia senza SSML gli agenti vocali basati su LLM?
In un agente basato su LLM, un large language model scrive ogni risposta durante la chiamata e il testo viene trasmesso in streaming al motore vocale man mano che viene generato (come funziona la pipeline STT, LLM e TTS). Nessuno tagga le frasi a mano, e lo streaming aggiunge un'insidia: la documentazione di Cartesia avverte che un tag di velocità o volume diviso tra token trasmessi in streaming viene letto ad alta voce. I team usano invece quattro metodi:
- Prompt per un testo pronunciabile. Chiedi al modello di scrivere «quattro uno cinque» al posto di «415».
- Normalizzazione del testo. Un passaggio prima della sintesi converte numeri, date e valute in forma parlata.
- Un dizionario di pronuncia. Un elenco di parole con trascrizioni fonetiche, applicato a ogni risposta.
- Controlli vocali della piattaforma. Marcatori inline che la piattaforma traduce per ciascun provider vocale.
Come gestisce Retell AI pause e pronuncia?
La documentazione di Retell AI non descrive l'input SSML grezzo. Documenta questi controlli:
- Pause e spelling. Secondo la documentazione sui controlli vocali, un trattino con uno spazio su ciascun lato aggiunge una pausa, e i tag
<spell>leggono un codice o un numero di conto un carattere alla volta. Retell converte il tag «nel formato più adatto alla voce del tuo agente». - Dizionario di pronuncia. Gli elementi del dizionario accettano una parola e un fonema in IPA, CMU, Pinyin o Jyutping. Le voci della piattaforma Retell accettano IPA e CMU, mentre alcuni modelli dei provider non ne accettano nessuno.
- Speech Normalization. Un preset dell'Agent Handbook, disattivato per impostazione predefinita, che formatta numeri, date, importi e numeri di telefono in forma parlata.
Vedi anche come funzionano gli agenti vocali con IA durante una chiamata.
Domande frequenti sull'SSML
A cosa serve l'SSML?
Controlla il modo in cui un motore di sintesi vocale legge il testo ad alta voce: pause, pronuncia, lettura di numeri e date, oltre a tono, velocità e volume.
L'SSML è uguale su tutti i motori di sintesi vocale?
No. Ogni motore supporta un proprio sottoinsieme della specifica W3C e aggiunge tag propri, quindi spesso il markup va modificato da un motore all'altro.
ElevenLabs supporta l'SSML?
In parte. La sua documentazione descrive i tag break per pause fino a 3 secondi e i tag phoneme sul modello Flash v2. Eleven v3 e v4 non supportano i tag break (a novembre 2026).
Qual è la differenza tra SSML e un dizionario di pronuncia?
I tag SSML si trovano all'interno di un singolo testo e si applicano solo lì. Un dizionario di pronuncia è un elenco di parole separato che il motore o la piattaforma applica a ogni parola corrispondente.
Gli agenti vocali con IA usano l'SSML?
Alcuni sì, quando il motore vocale lo accetta. Molti si affidano a prompt, normalizzazione del testo e dizionari di pronuncia, perché le risposte vengono generate in tempo reale e alcuni modelli vocali più recenti accettano poco SSML.
Ogni nome e ogni numero, pronunciati correttamente
Retell AI è una piattaforma di agenti vocali con IA per i contact center. Puoi controllare pause, spelling e pronuncia per ciascun agente e ascoltare il risultato in un test di chiamata web. Parla con il team di Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


