LLM as a judge (LLM come giudice) è un metodo di valutazione in cui un modello linguistico di grandi dimensioni assegna un punteggio o una classifica all'output di un altro sistema di IA in base a criteri scritti, al posto di un revisore umano. I team lo usano per valutare attività aperte, come una conversazione telefonica, che non hanno un'unica risposta corretta.
Il nome deriva da un paper del 2023, Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Gli autori hanno riportato che giudici avanzati come GPT-4 concordavano con le preferenze umane con "oltre l'80% di accordo, lo stesso livello di accordo che si osserva tra esseri umani". Ne hanno anche elencato i limiti: bias di posizione, di verbosità e di autovalorizzazione.
Come valuta una conversazione un giudice LLM?
Un giudice LLM legge la conversazione e una serie di istruzioni, quindi restituisce un verdetto in una di tre forme.
| Metodo | Cosa fa il giudice | Cosa restituisce | Quando usarlo |
|---|---|---|---|
| Valutazione con rubrica | Legge una trascrizione e la confronta con criteri scritti | Superato o non superato, oppure un punteggio, con una motivazione | QA in produzione e test di regressione |
| Ranking a coppie | Confronta due o più risposte allo stesso turno | Un vincitore o una classifica | Scegliere tra prompt o modelli |
| Panel di giudici | Diversi modelli giudice valutano lo stesso elemento e i verdetti vengono aggregati | Un unico punteggio aggregato | Punteggi che il bias di un singolo modello potrebbe falsare |
Valutazione con rubrica. Nel paper G-Eval il giudice ragionava sui criteri e poi compilava un modulo di valutazione. Nei riassunti, i suoi punteggi risultavano più correlati alle valutazioni umane rispetto ai metodi precedenti.
Ranking a coppie. Chiedere quale di due risposte sia migliore è adatto a qualità come il tono, dove una differenza è più facile da notare che da quantificare.
Panel di giudici. In Replacing Judges with Juries, un panel di modelli più piccoli appartenenti a famiglie diverse "supera un singolo giudice di grandi dimensioni, mostra meno bias intra-modello" ed è risultato "oltre sette volte meno costoso".
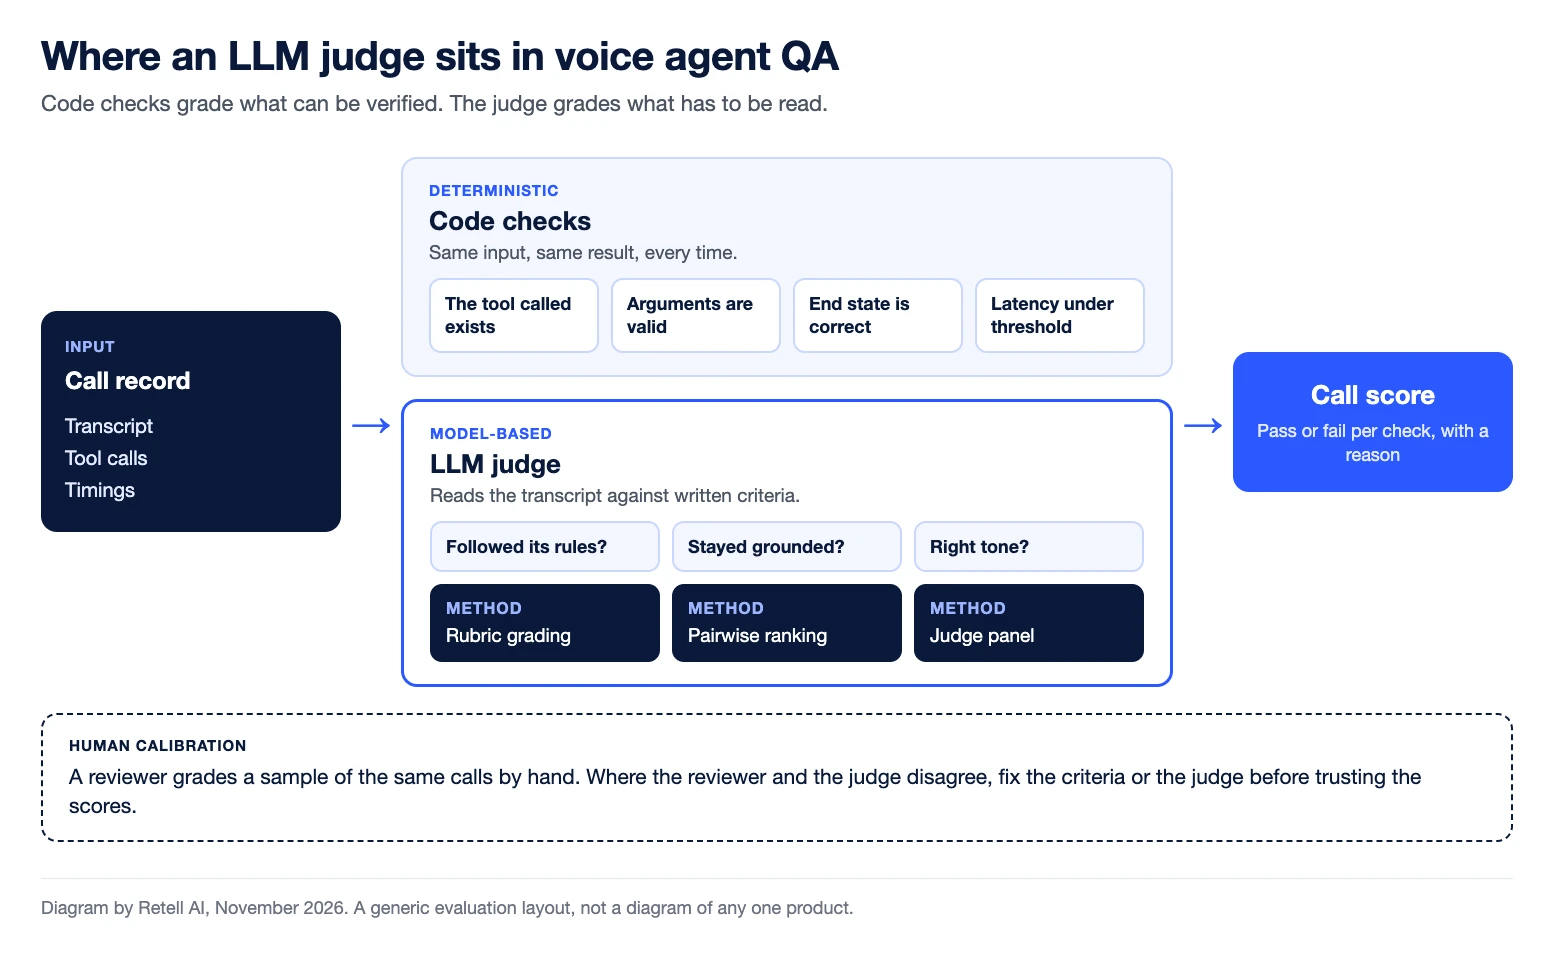
Come si usa LLM as a judge nel QA e nei benchmark degli agenti vocali?
Il QA degli agenti vocali usa un giudice LLM per le parti di una chiamata che si possono valutare solo leggendo la trascrizione: se l'agente ha seguito le sue regole, è rimasto entro le sue fonti e ha risolto la richiesta.
La documentazione di Retell mostra entrambe le configurazioni più comuni. In AI QA, una condizione valutata dall'IA è "un controllo qualitativo che l'IA esegue sulla trascrizione e sul contesto di ogni chiamata", scritto come "il prompt che l'IA usa per giudicare se la condizione è soddisfatta". Nei test di simulazione, un'IA interpreta il chiamante e "ogni esecuzione viene valutata come superata o non superata con una spiegazione scritta".
I benchmark riportano lo stesso tipo di verdetto su larga scala. Il Retell vCX Benchmark pubblica il punteggio di ogni suite come tasso di superamento, "la percentuale di scenari testati gestiti correttamente", per aderenza alle istruzioni, grounding, chiamate agli strumenti e linguaggio colloquiale (consultato il 13 novembre 2026).
Per trasformare i verdetti in una revisione settimanale, consulta la scorecard di QA per agenti vocali.
Quali sono i limiti noti di un giudice LLM?
Un giudice LLM sbaglia in quattro modi documentati. Per ciascuno esiste un controllo noto.
- Bias di posizione. In Large Language Models are not Fair Evaluators, invertire l'ordine di due risposte ha permesso a un modello di vincere "66 su 80 query testate". Esegui ogni confronto in entrambi gli ordini.
- Autopreferenza. Uno studio del 2024 ha rilevato che un valutatore "assegna punteggi più alti ai propri output rispetto a quelli altrui, mentre gli annotatori umani li considerano di pari qualità". Usa un giudice di una famiglia di modelli diversa, oppure un panel.
- Scarso accordo con gli esseri umani. Judging the Judges ha testato tredici modelli giudice e ha rilevato che "solo i modelli migliori (e più grandi) raggiungono un allineamento ragionevole con gli esseri umani", con "una tendenza all'indulgenza". Valuta un campione a mano e confronta i risultati.
- Deriva. Il modello dietro un'API può cambiare: uno studio ha misurato un calo dell'accuratezza di GPT-4 dall'84% al 51% sullo stesso compito in tre mesi. Anche i criteri cambiano. Who Validates the Validators? la definisce deriva dei criteri: "gli utenti hanno bisogno di criteri per valutare gli output, ma valutare gli output aiuta gli utenti a definire i criteri". Fissa la versione del giudice e riesegui un set fisso etichettato a mano dopo ogni modifica.
I giudici, inoltre, non sono deterministici. La documentazione sulle simulazioni di Retell consiglia: "Giudica uno scenario in base al suo tasso di superamento su più esecuzioni, non su una sola."
Quando i controlli via codice sono migliori di un giudice LLM?
I controlli via codice sono migliori di un giudice LLM ogni volta che la risposta si può verificare anziché leggere. La guida di Anthropic alle valutazioni degli agenti raccomanda di "scegliere valutatori deterministici dove possibile, valutatori LLM dove necessario". Descrive i valutatori basati su codice come veloci, economici, oggettivi e riproducibili, e quelli basati su modelli come non deterministici.
In una chiamata, il codice può verificare che lo strumento chiamato dall'agente esista, che i suoi argomenti siano validi e che il tempo di risposta sia rimasto sotto una soglia. tau-bench valuta intere conversazioni in questo modo, confrontando "lo stato del database alla fine di una conversazione con lo stato obiettivo annotato".
AI QA di Retell tiene separati i due approcci: le metriche di performance sono soglie quantitative, mentre le condizioni valutate dall'IA si occupano dei controlli qualitativi. Come testare e rilasciare le modifiche agli agenti vocali spiega dove viene eseguito ciascuno.
Come si usano i panel di giudici per addestrare un modello vocale?
Tell-1, l'LLM proprietario di Retell, ha usato giudici LLM in due delle sue tre fasi di addestramento, secondo l'articolo tecnico sull'LLM di Retell. La fase di preference tuning ha appreso da "coppie di preferenze classificate da un panel di giudici LLM".
Nella fase di reinforcement learning, spiega l'articolo, "il modello scrive otto risposte e ognuna riceve un punteggio". Il codice viene eseguito per primo: le chiamate a strumenti al di fuori del set dell'agente, gli output malformati e altri errori critici "vengono intercettati dal codice prima che un giudice li veda". Per la correttezza, "più modelli giudice valutano la correttezza delle chiamate agli strumenti, le allucinazioni e l'aderenza alle istruzioni, e i loro verdetti vengono aggregati in un unico segnale di ricompensa". Per la naturalezza, un singolo giudice classifica tutte e otto le risposte affiancate in base a una rubrica, perché "la naturalezza è più facile da confrontare che da quantificare".
È lo schema descritto in questa pagina: controlli via codice per ciò che si può verificare, un panel di giudici per la correttezza e il ranking per il tono.
Domande frequenti su LLM as a judge
Cosa fa un giudice LLM?
Legge un output, come la trascrizione di una chiamata, insieme alle istruzioni di valutazione, e restituisce un verdetto: superato o non superato, un punteggio o una preferenza tra due opzioni.
Quanto è affidabile LLM as a judge?
Dipende dal modello giudice e dal compito. Uno studio ha rilevato oltre l'80% di accordo con le preferenze umane; un altro ha rilevato che solo i giudici più grandi erano ragionevolmente allineati con gli esseri umani. Verifica prima il giudice su chiamate valutate a mano.
Cos'è un panel di giudici?
Un panel di giudici è composto da diversi modelli giudice che valutano lo stesso output, con i verdetti aggregati. Riduce l'effetto del bias di un singolo modello.
Qual è la differenza tra valutazione con rubrica e ranking a coppie?
La valutazione con rubrica assegna un punteggio a un output in base a criteri scritti. Il ranking a coppie mostra al giudice due output e chiede quale sia migliore.
Un giudice LLM può valutare una chiamata vocale?
Sì, a partire dalla trascrizione e dalle chiamate agli strumenti. Le qualità che risiedono nell'audio richiedono anche l'audio: la documentazione di Retell indica che Agent Naturalness viene "valutata usando sia l'audio sia la trascrizione".
Valuta le tue chiamate prima di scalare
Retell AI è una piattaforma di agenti vocali con IA per i contact center. AI QA valuta un campione delle tue chiamate in base alle condizioni e alle soglie che imposti, con evidenze dalla trascrizione per ogni risultato.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


