Il prompt caching è una tecnica che permette a un large language model di saltare il lavoro già svolto: quando una nuova richiesta inizia con gli stessi token di una precedente, il modello riutilizza il calcolo salvato per quella parte iniziale condivisa ed elabora solo ciò che è nuovo. Il risultato è un primo token più rapido e, sulla maggior parte delle API, un prezzo inferiore per i token riutilizzati.
La parte riutilizzata si chiama prefisso. La guida di OpenAI lo definisce come "i token invariati all'inizio di un prompt". Di solito lì si trovano le istruzioni, le definizioni dei tool e i turni precedenti della conversazione.
Come funziona il prompt caching?
La documentazione di Anthropic descrive la sequenza: il sistema verifica se un prefisso del prompt è già in cache da una query recente; se lo è, usa la versione in cache, altrimenti elabora l'intero prompt e salva il prefisso in cache.
Da questo design derivano tre regole:
- La corrispondenza è esatta. Anthropic afferma che i cache hit richiedono "segmenti di prompt identici al 100 percento". Un solo carattere modificato all'inizio del prompt significa che tutto ciò che segue viene elaborato di nuovo.
- L'ordine conta. I contenuti stabili vanno per primi e quelli variabili per ultimi.
- Le voci scadono. La durata predefinita della cache di Anthropic è di 5 minuti, rinnovata ogni volta che il contenuto in cache viene usato. Le durate di OpenAI dipendono dal modello.
Che relazione c'è tra prompt caching, prefix caching e KV cache?
Sono tre livelli della stessa idea. La KV cache sono i dati, il prefix caching è il riutilizzo di quei dati tra richieste diverse e il prompt caching è il nome che i provider di API danno alla funzionalità.
| Termine | Che cos'è | Ambito | Dove trovi il termine |
|---|---|---|---|
| KV cache | Gli stati key e value che un modello calcola per ogni token letto, conservati per non doverli ricalcolare a ogni nuovo token | All'interno di una singola richiesta | Funzionamento interno dei modelli, motori di inferenza |
| Prefix caching | Conservare la KV cache al termine di una richiesta e riutilizzarla per una richiesta successiva che inizia con gli stessi token | Tra richieste sullo stesso server | Motori di inferenza come vLLM |
| Prompt caching | Prefix caching offerto come funzionalità delle API, con regole su durata, lunghezza minima e prezzo | Tra chiamate API | Documentazione e pagine prezzi dei provider di modelli |
Un articolo esplicativo di Hugging Face descrive la KV cache in modo semplice: "Invece di ricalcolare tutto da zero, il modello riutilizza ciò che ha già calcolato". La documentazione di vLLM spiega che il suo prefix caching automatico "mette in cache la KV cache delle query esistenti, così una nuova query può riutilizzare direttamente la KV cache se condivide lo stesso prefisso". OpenAI conferma il legame dal lato API: "La prompt cache memorizza i tensori key-value (KV), non i token stessi."
Perché il prompt caching è importante in una telefonata a più turni?
Un agente vocale interroga il modello una volta per turno e ogni richiesta contiene le istruzioni, le definizioni dei tool e la conversazione fino a quel momento. In una conversazione a più turni quasi tutto è identico alla richiesta del turno precedente. Solo l'ultimo scambio è nuovo. Senza caching, il modello rilegge le stesse istruzioni a ogni turno.
Esempio pratico (numeri indicativi). Un agente ha 2.500 token di istruzioni e tool, ogni turno aggiunge 100 token di conversazione e ogni turno successivo al primo trova il proprio prefisso in cache:
| Turno | Token del prompt | Riutilizzati dalla cache | Nuovi token da leggere |
|---|---|---|---|
| 1 | 2.600 | 0 | 2.600 |
| 2 | 2.700 | 2.600 | 100 |
| 5 | 3.000 | 2.900 | 100 |
| 10 | 3.500 | 3.400 | 100 |
| Tutti i 10 turni | 30.500 | 27.000 | 3.500 |
Nell'arco della chiamata, 27.000 dei 30.500 token del prompt (circa l'89%) provengono dalla cache. Dal secondo turno in poi, il modello legge 100 nuovi token invece di oltre 2.600.
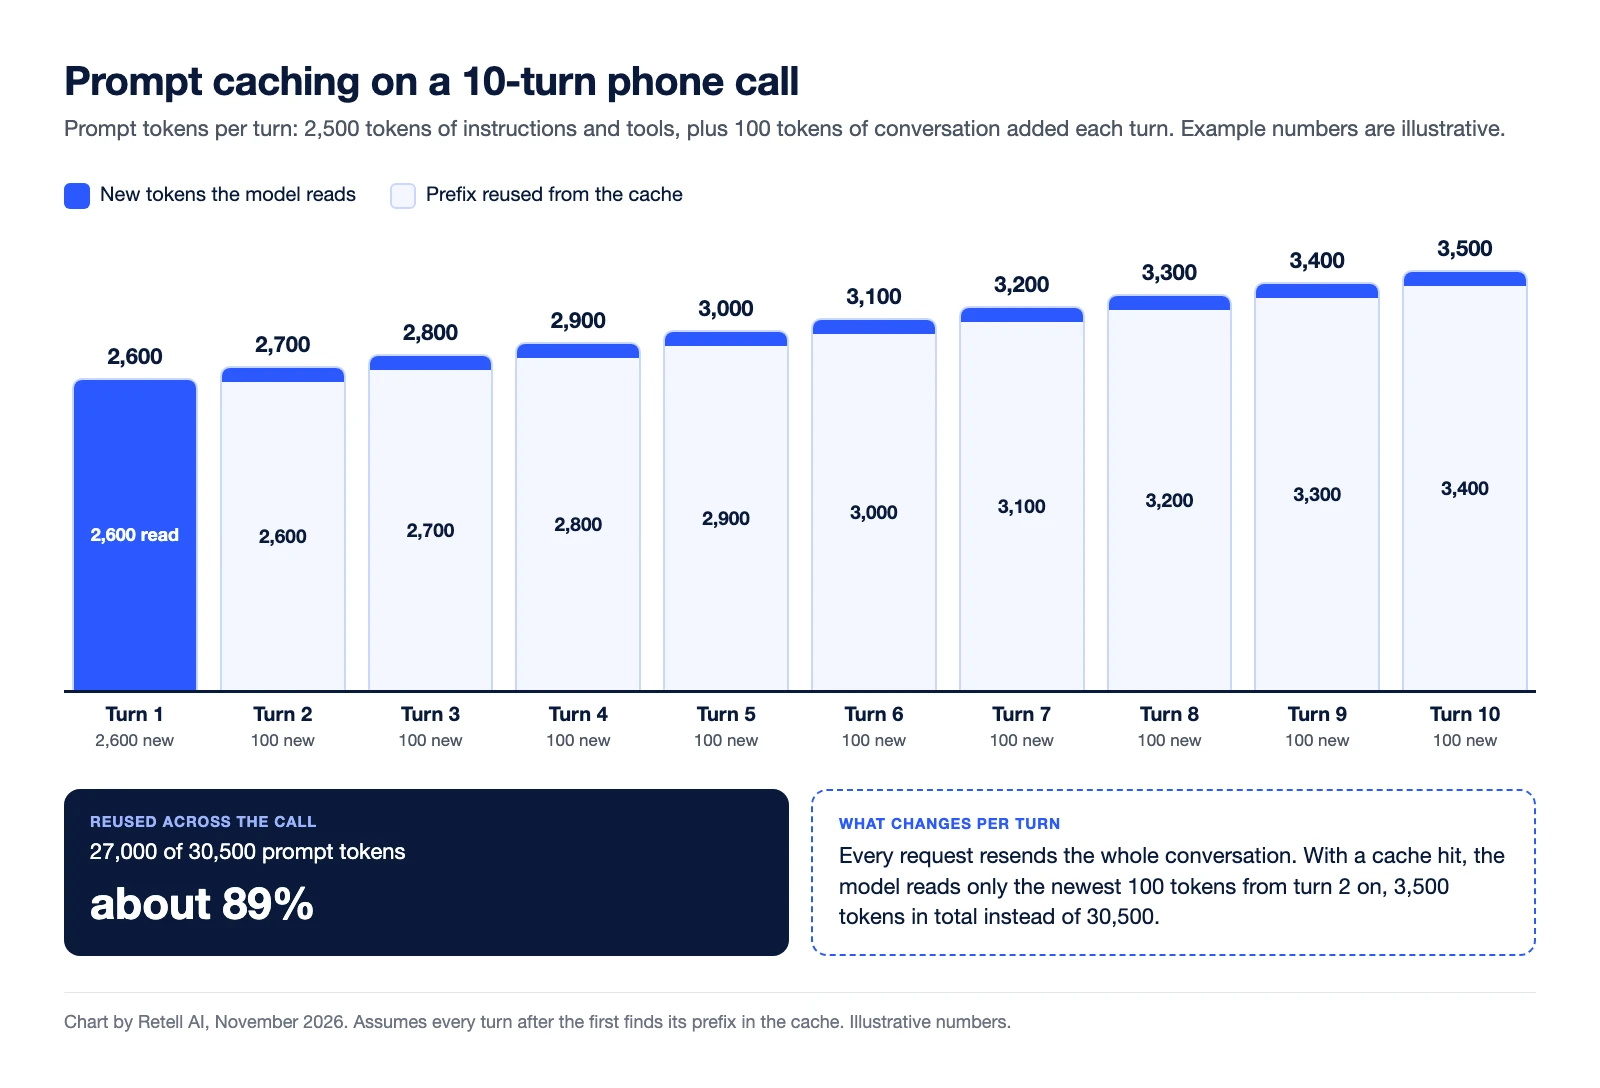
Questo conta per due motivi. Il tempo al primo token fa parte della latenza che chi chiama percepisce come silenzio, e leggere un prompt lungo richiede tempo. Il secondo è il costo: Anthropic applica alle letture dalla cache un prezzo pari a 0,1 volte il prezzo base dei token di input, mentre le scritture in cache costano 1,25 volte per la durata di 5 minuti.
Cosa impedisce un cache hit?
- Un prefisso modificato. Un timestamp, il nome di chi chiama o un elenco di tool riordinato vicino all'inizio del prompt cambia tutti i token successivi.
- Un intervallo più lungo della durata della cache.
- La richiesta che arriva a una macchina diversa. La guida di OpenAI osserva che "gli stati in cache risiedono su singole macchine" e che una richiesta può riutilizzare un prefisso "solo se raggiunge una macchina che contiene una voce corrispondente non ancora scaduta".
Il routing può colmare quest'ultima lacuna. Tell-1, l'LLM proprietario di Retell, mantiene ogni chiamata sulle GPU che la hanno già in cache, grazie alla session affinity. Secondo il post tecnico sull'LLM di Retell, questo quasi raddoppia la quota di token del prompt serviti dalla cache, dal 36% al 69%, quindi a ogni turno c'è meno da leggere e le risposte partono prima.
Il caching non cambia la risposta. Le note di design di vLLM affermano che il prefix caching "non modifica gli output del modello".
Il ruolo negli agenti vocali con IA
La guida alla risoluzione dei problemi di latenza di Retell indica chiaramente il costo della lunghezza del prompt: "Ogni token del tuo prompt si aggiunge al tempo al primo token, e questo costo si paga a ogni turno della conversazione."
Se colleghi il tuo modello tramite l'LLM WebSocket di Retell, ogni richiesta di risposta arriva con la "trascrizione live completa raccolta finora nella chiamata". È il tuo server a costruire il prompt, quindi il comportamento della cache dipende da come lo costruisci e dal tuo provider del modello: tieni istruzioni e tool all'inizio e invariati, e aggiungi la trascrizione dopo di essi. Per il percorso completo di un turno, scopri come funziona l'IA vocale in tempo reale.
Domande frequenti sul prompt caching
Qual è la differenza tra prompt caching e KV cache?
La KV cache è lo stato di attenzione memorizzato che un modello costruisce mentre legge i token. Il prompt caching conserva quello stato al termine di una richiesta, così una richiesta successiva con gli stessi token iniziali può riutilizzarlo.
Il prefix caching è uguale al prompt caching?
Si tratta dello stesso meccanismo. Prefix caching è il termine usato dai motori di inferenza. Prompt caching è il nome commerciale che i provider di modelli usano nelle loro API.
Il prompt caching modifica la risposta del modello?
No. Evita soltanto di ricalcolare il prefisso condiviso.
Quanto dura una prompt cache?
Dipende dal provider. Il valore predefinito di Anthropic è di 5 minuti, rinnovati a ogni utilizzo, con un'opzione da 1 ora a un prezzo di scrittura più alto. Le durate di OpenAI dipendono dal modello.
Perché il prompt caching è importante per gli agenti vocali?
Ogni turno di una chiamata reinvia le istruzioni e la conversazione fino a quel momento. Con un cache hit, il modello legge solo lo scambio più recente.
Senti la differenza nelle tue chiamate
Retell AI è una piattaforma di agenti vocali con IA per i contact center. Tell-1 è il suo LLM proprietario, creato per le telefonate. La documentazione mostra come verificare la latenza di ogni chiamata per componente, così puoi vedere quanta parte dell'attesa dipende dal modello. Parla con il team di Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


