Il time to first token (TTFT) è il tempo che intercorre tra l'invio di una richiesta a un large language model (LLM) e la ricezione del primo token della sua risposta. Misura quanto rapidamente un modello inizia a rispondere, non quanto dura la risposta.
La guida al benchmarking di NVIDIA lo definisce come "il tempo che va dall'invio della query al primo token ricevuto". In una telefonata, il TTFT è solo una parte della latenza percepita da chi chiama. Altre due misure si sovrappongono a esso: il tempo alla prima frase (time to first sentence) e la latenza vocale end-to-end.
Cosa include il TTFT?
Il TTFT comprende tutto ciò che avviene prima che il modello trasmetta in streaming il primo token. IBM ne elenca quattro componenti: il ritardo di accodamento, il tempo di prefill (l'elaborazione del prompt), la generazione del primo token e l'overhead di rete e API.
IBM definisce il prefill "spesso il fattore che contribuisce maggiormente al TTFT, soprattutto con prompt più lunghi". Il modello legge l'intero prompt prima di scrivere qualsiasi cosa, quindi un prompt più lungo significa un'attesa più lunga. Anche il carico conta. La documentazione di Anyscale osserva che un server sottoposto a un uso intenso può mettere in coda le richieste in arrivo, e quell'attesa si aggiunge al TTFT.
Come si misura il TTFT?
- TTFT = istante di ricezione del primo token meno istante di invio della richiesta
Tre scelte cambiano il risultato. Dichiarale insieme a qualsiasi valore di TTFT:
- Dove si trova il cronometro. Misurato sul client, il TTFT include il tempo di rete. Misurato all'interno del server del modello, no.
- Quale percentile. La mediana (P50) mostra la richiesta tipica. P90 e P99 mostrano quelle lente.
- Quanto carico. Una singola richiesta su un server inattivo è il caso migliore. In produzione, osserva NVIDIA, il prefill di una richiesta può sovrapporsi alla generazione di un'altra.
In cosa differiscono TTFT, tempo alla prima frase e latenza end-to-end in una telefonata?
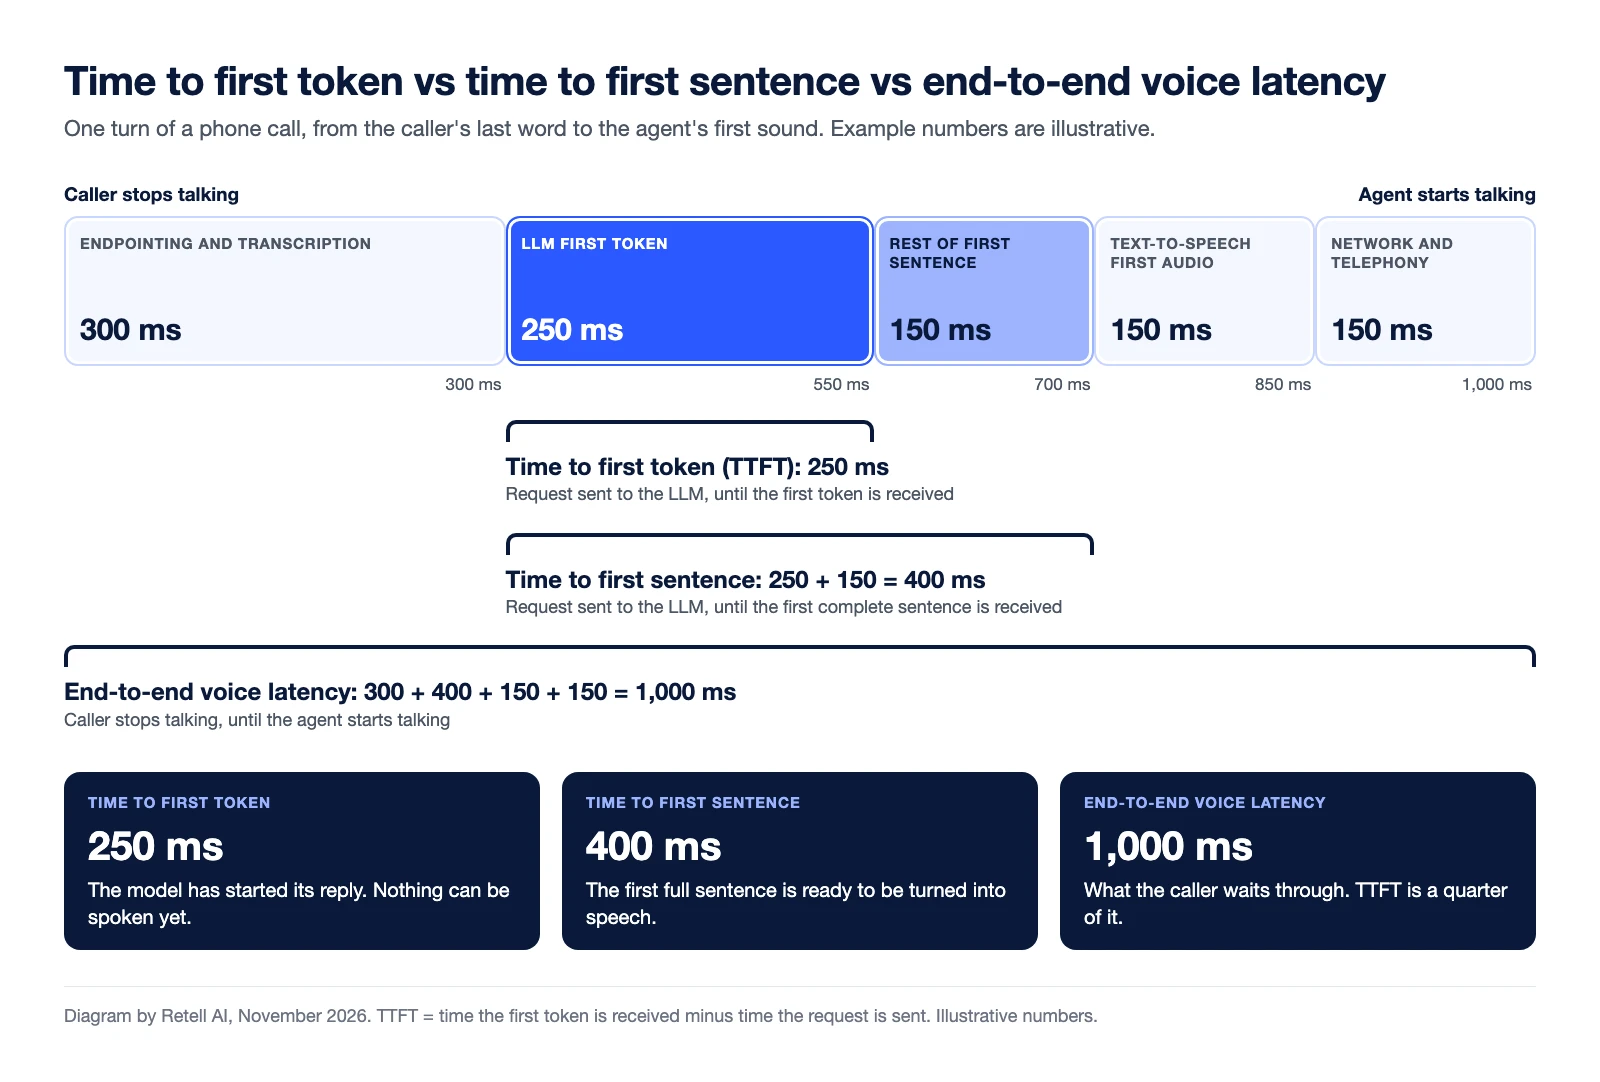
Il TTFT si ferma al primo token. Il tempo alla prima frase si ferma quando è arrivata una frase completa. La latenza vocale end-to-end copre l'intero intervallo percepito da chi chiama.
Chi chiama non sente mai un token. Le best practice per LLM personalizzati di Retell affermano: "Retell inizia a parlare non appena riceve la tua prima frase completa." Il valore che conta in questo caso è "il time to first token più il tempo necessario per completare quella prima frase".
La documentazione sulla latenza di Retell misura la latenza end-to-end "da quando l'utente smette di parlare a quando l'agente inizia a parlare".
| Misura | Inizio del cronometro | Fine del cronometro | Cosa esclude |
|---|---|---|---|
| Time to first token (TTFT) | Richiesta inviata all'LLM | Primo token ricevuto | Il resto della prima frase, il riconoscimento vocale, la sintesi vocale |
| Tempo alla prima frase | Richiesta inviata all'LLM | Prima frase completa ricevuta | Riconoscimento vocale, sintesi vocale, telefonia |
| Latenza vocale end-to-end | Chi chiama smette di parlare | L'agente inizia a parlare | Nulla della pipeline. Verifica se il valore include il tratto di rete verso chi chiama |
Attenzione a un equivoco terminologico: nel benchmarking degli LLM, la latenza end-to-end arriva fino all'ultimo token. NVIDIA la definisce come "il tempo necessario dall'invio di una query alla ricezione della risposta completa".
Esempio pratico (valori illustrativi). Un turno di una chiamata:
- Endpointing e trascrizione: 300 ms
- Primo token dell'LLM: 250 ms
- Resto della prima frase: 150 ms (altri 15 token da 10 ms ciascuno)
- Primo audio della sintesi vocale (text-to-speech): 150 ms
- Rete e telefonia: 150 ms
Il TTFT è di 250 ms. Il tempo alla prima frase è 250 + 150 = 400 ms. La latenza vocale end-to-end è 300 + 400 + 150 + 150 = 1.000 ms, quindi il TTFT rappresenta un quarto dell'attesa di chi chiama. La nostra guida ai benchmark di latenza dell'IA vocale usa lo stesso budget.
Perché il TTFT può essere fuorviante quando confronti i modelli?
Un valore di TTFT è confrontabile solo con un altro valore di TTFT misurato allo stesso modo. Se metti il TTFT di un modello a confronto con il tempo alla prima frase di un altro, il primo sembrerà sempre più veloce. Lo stesso vale per il tempo del solo modello rispetto a quello misurato in una chiamata reale, e per una mediana rispetto a un P99.
Un modello può anche inviare rapidamente il primo token e poi trasmettere lentamente il resto, lasciando comunque chi chiama nel silenzio.
Come ridurre il TTFT di un agente vocale?
La guida alla risoluzione dei problemi di latenza di Retell indica la scelta del modello e la lunghezza del prompt come le due cause più comuni di latenza elevata.
- Scegli un modello più veloce. Tell-1 è un'opzione progettata per le chiamate. Secondo la guida, i modelli più grandi e orientati al ragionamento "sono più lenti ad arrivare al primo token".
- Accorcia il prompt. "Ogni token nel tuo prompt si aggiunge al time to first token", a ogni turno. I prompt oltre circa 8k token diventano sensibilmente più lenti.
- Trasmetti la risposta in streaming. Con un LLM personalizzato, inviare la risposta completa in un unico evento "colloca l'intera generazione nel silenzio di chi chiama".
La Get Call API di Retell restituisce la latenza end-to-end, dell'LLM e del text-to-speech per ogni chiamata a P50, P90, P95 e P99. Il valore dell'LLM arriva "fino al primo chunk pronunciabile ricevuto", quindi misura il testo pronunciabile, non il primo token grezzo.
Alcuni modelli sono costruiti attorno a questa misura. Tell-1, l'LLM proprietario di Retell, avvia la risposta e continua a ragionare mentre viene riprodotta la prima frase. Ha la latenza mediana più bassa del Retell vCX Benchmark con 76 ms, un tempo mediano alla prima frase calcolato su una finestra mobile di 24 ore (rilevato il 13 novembre 2026). Il post tecnico su Retell LLM spiega come funziona; il tempo del modello, comunque, è solo una parte della latenza vocale end-to-end.
Domande frequenti sul time to first token
Qual è un buon time to first token?
Non esiste uno standard unico. Dipende dal modello, dalla lunghezza del prompt e dal carico del server. Per un agente vocale, valutalo all'interno del valore end-to-end. La documentazione di Retell suggerisce di mantenere la latenza stimata di un agente sotto 1,5 secondi.
Il TTFT equivale alla latenza?
No. Il TTFT è il ritardo dell'LLM fino al primo token. La latenza in una chiamata è l'intero intervallo tra il momento in cui chi chiama finisce di parlare e quello in cui l'agente inizia a parlare.
Il TTFT include il tempo di rete?
Dipende da dove viene misurato. Secondo NVIDIA, il TTFT "in genere include il tempo di accodamento della richiesta, il tempo di prefill e la latenza di rete". Un valore del solo modello misurato all'interno del server esclude la rete.
Qual è la differenza tra TTFT e tempo alla prima frase?
Il TTFT si ferma al primo token. Il tempo alla prima frase si ferma quando è arrivata la prima frase completa, cioè il momento in cui un agente vocale può iniziare a parlare.
Misura la latenza delle tue chiamate
Retell AI è una piattaforma di agenti vocali con IA per contact center. La sezione Call History mostra la latenza di ogni chiamata, suddivisa per componente nella Get Call API. Contatta il team di Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


