La decodifica speculativa è una tecnica per velocizzare un modello linguistico di grandi dimensioni: un piccolo modello di bozza prova a indovinare i prossimi token, e il modello grande li verifica tutti in un unico passaggio, conservando quelli che avrebbe generato lui stesso.
Il metodo nasce da due articoli di ricerca. Google Research gli ha dato il nome in Fast Inference from Transformers via Speculative Decoding (Leviathan, Kalman e Matias, prima pubblicazione a novembre 2022). DeepMind ha descritto una propria versione, sviluppata in modo indipendente, in Accelerating Large Language Model Decoding with Speculative Sampling (Chen e colleghi, febbraio 2023).
Perché la decodifica standard è lenta?
La decodifica standard è lenta perché un modello linguistico di grandi dimensioni scrive un token alla volta, e ogni token richiede un'esecuzione completa del modello. L'articolo di Google lo riassume in una riga: «decodificare K token richiede K esecuzioni seriali del modello».
Molti di questi token sono facili da prevedere. Lo stesso articolo osserva che «i compiti difficili di modellazione del linguaggio spesso includono sotto-compiti più semplici che possono essere approssimati bene da modelli più efficienti».
Come collaborano il modello di bozza e il modello completo?
I due modelli lavorano a turni, e ogni turno è composto da tre fasi:
- Bozza. Il modello piccolo scrive una breve sequenza di ipotesi, un token dopo l'altro. L'articolo di Google lo chiama modello di approssimazione; DeepMind lo chiama modello di bozza.
- Verifica. Il modello grande, chiamato modello target, valuta in parallelo ogni posizione ipotizzata, in un solo passaggio.
- Accettazione o correzione. Le ipotesi vengono accettate da sinistra a destra. Alla prima ipotesi rifiutata, il modello grande fornisce il proprio token e le ipotesi successive vengono scartate. Se tutte le ipotesi vengono accettate, il modello grande aggiunge un ulteriore token.
Ogni passaggio del modello grande produce almeno un token e al massimo il numero di ipotesi più uno, quindi non richiede mai più passaggi della decodifica standard.
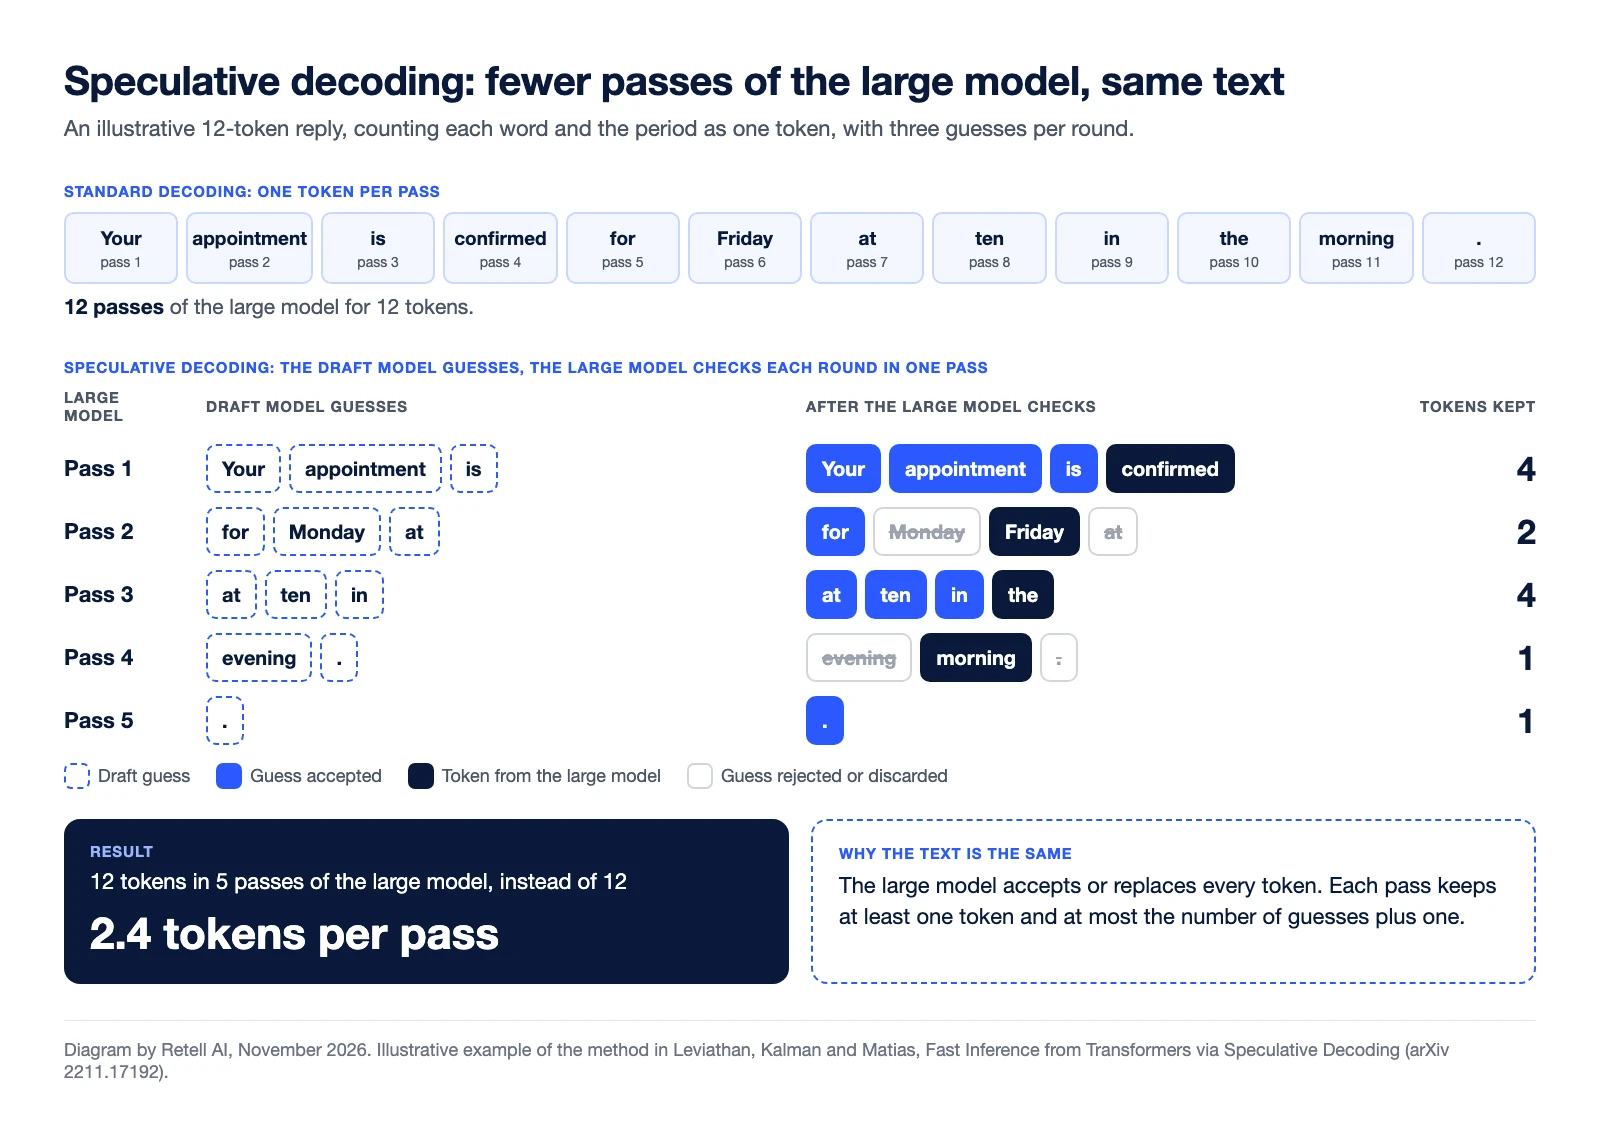
Esempio pratico (illustrativo). Una risposta in inglese di 12 token, contando ogni parola e il punto come un token, con tre ipotesi per turno:
| Passaggio del modello grande | Ipotesi del modello di bozza | Verdetto del modello grande | Token conservati |
|---|---|---|---|
| 1 | Your appointment is | Tutte e tre accettate, aggiunge «confirmed» | 4 |
| 2 | for Monday at | «for» accettata. «Monday» rifiutata e sostituita con «Friday». «at» scartata | 2 |
| 3 | at ten in | Tutte e tre accettate, aggiunge «the» | 4 |
| 4 | evening . | «evening» rifiutata e sostituita con «morning». Il punto viene scartato | 1 |
| 5 | . | Accettata, e la risposta termina | 1 |
| Totale | 12 token in 5 passaggi |
Con la decodifica standard servono 12 passaggi del modello grande per questa frase. Qui il modello viene eseguito 5 volte, con una media di 2,4 token per passaggio.
Perché l'output non cambia?
L'output non cambia perché il modello grande ha l'ultima parola su ogni token. Con la decodifica greedy, in cui il modello sceglie sempre l'opzione più probabile, un'ipotesi viene conservata solo se è il token che il modello grande avrebbe scelto. La documentazione di vLLM elenca un test proprio per questo: il campionamento greedy con decodifica speculativa «coincide con il campionamento greedy senza di essa».
Con il campionamento casuale, un'ipotesi viene accettata con una probabilità che dipende da come la valutano i due modelli, e un'ipotesi rifiutata viene ricampionata da una distribuzione corretta. L'articolo di Google dimostra che in questo modo la distribuzione dell'output resta invariata. Secondo la formulazione di DeepMind, lo schema «preserva la distribuzione del modello target entro i limiti della precisione numerica dell'hardware».
Alcune varianti più recenti allentano di proposito la verifica per guadagnare velocità. vLLM segnala che uno dei suoi metodi di verifica «non preserva la distribuzione».
Quando la decodifica speculativa è utile e quando no?
La decodifica speculativa è utile quando il modello di bozza è economico e di solito indovina, e il server dispone di capacità di calcolo inutilizzata.
| Condizione | Effetto sulla velocità | Fonte |
|---|---|---|
| Le ipotesi vengono quasi sempre accettate | Più token per passaggio. Token attesi per passaggio = (1 − α^(γ+1)) ÷ (1 − α), dove α è il tasso di accettazione e γ il numero di ipotesi per turno | Articolo di Google |
| Il modello di bozza è molto più piccolo del target | Basso costo di generazione della bozza. Un modello di bozza più piccolo di circa due ordini di grandezza «in genere ha dato i risultati migliori» | Articolo di Google |
| È disponibile capacità di calcolo inutilizzata | Necessaria. Il metodo presuppone «risorse di calcolo sufficienti a supportare la maggiore concorrenza» | Articolo di Google |
| Traffico elevato sul server | Guadagno minore. vLLM classifica un modello di bozza come «High gain» con bassi volumi di richieste e «Medium gain» con volumi elevati | Documentazione di vLLM |
| La bozza sbaglia troppo spesso rispetto a quanto costa | Nessun guadagno. Si ottiene un'accelerazione solo quando il tasso di accettazione è superiore al costo della bozza rispetto al target | Articolo di Google |
A titolo illustrativo, un tasso di accettazione di 0,6 con tre ipotesi per turno dà circa 2,2 token per passaggio.
Accelerazioni pubblicate: l'articolo di Google riporta da 2X a 3X su un modello T5-XXL da 11 miliardi di parametri. DeepMind riporta un'accelerazione da 2 a 2,5 volte su Chinchilla da 70 miliardi di parametri con un modello di bozza da 4 miliardi di parametri. I risultati dipendono dai modelli, dal compito e dall'hardware.
Un esempio in produzione dal mondo della voce: Tell-1, l'LLM proprietario di Retell, usa la decodifica speculativa per ottenere circa quattro token da ogni passaggio del modello completo, secondo l'articolo tecnico di Retell su Retell LLM.
Perché la decodifica speculativa è importante per la voce in tempo reale?
La decodifica speculativa è importante per la voce in tempo reale perché chi chiama percepisce il tempo di elaborazione del modello come silenzio. In una chiamata, il modello è una delle fasi della pipeline speech-to-text, LLM e text-to-speech, e il suo ritardo si somma alla latenza della chiamata.
Le best practice di Retell per gli LLM personalizzati spiegano quale parte del tempo del modello conta: Retell «inizia a parlare non appena ha la tua prima frase completa», quindi il valore da monitorare è «il tempo al primo token più il tempo per completare quella prima frase». La decodifica speculativa agisce sulla seconda parte: una volta avviata la generazione, i token arrivano a gruppi. Non riduce invece la lettura del prompt che precede il primo token. Per questo, la guida di Retell alla risoluzione dei problemi di latenza parte dalla scelta del modello e dalla lunghezza del prompt.
L'altro motivo è l'accuratezza. Anche passare a un modello più piccolo riduce il ritardo, ma la stessa guida avverte che cambiare modello «modifica il comportamento del tuo agente, non solo la sua velocità». La decodifica speculativa esatta mantiene l'output del modello grande.
A applicarla è chi serve il modello, quindi chi crea un agente la percepisce come velocità del modello. Su Retell, Tell-1 viene servito in questo modo. Per confrontare i modelli in termini di velocità e qualità delle chiamate, consulta i migliori LLM per agenti vocali con IA.
Domande frequenti sulla decodifica speculativa
La decodifica speculativa è senza perdite?
Nella sua forma esatta, sì. Gli articoli originali dimostrano che la distribuzione dell'output coincide con quella del modello grande, e vLLM la descrive come «teoricamente senza perdite, entro i limiti di precisione numerica dell'hardware». Le varianti che allentano la verifica non sono senza perdite.
Chi ha inventato la decodifica speculativa?
Yaniv Leviathan, Matan Kalman e Yossi Matias di Google Research hanno pubblicato l'articolo a novembre 2022 e lo hanno presentato a ICML 2023. Un team di DeepMind ha pubblicato una propria versione, chiamata campionamento speculativo, a febbraio 2023.
Che cos'è un modello di bozza?
Un modello di bozza è il modello piccolo e veloce che scrive le ipotesi. La documentazione di Hugging Face afferma che il metodo funziona al meglio quando il modello di bozza «è significativamente più piccolo del modello principale e usa lo stesso tokenizer».
La decodifica speculativa riduce i costi?
Dipende. L'articolo di Google osserva che il numero totale di operazioni aritmetiche «potrebbe essere superiore a quello dell'algoritmo di decodifica standard», poiché le ipotesi rifiutate sono lavoro sprecato. La retrospettiva di Google del 2024 aggiunge che risultati più rapidi sullo stesso hardware significano che «servono meno macchine per gestire la stessa quantità di traffico».
La multi-token prediction è la stessa cosa della decodifica speculativa?
No. La multi-token prediction (MTP) è uno dei modi per produrre le ipotesi. La documentazione di vLLM elenca la MTP accanto ai modelli di bozza come metodo di speculazione.
Metti alla prova la velocità del modello sulle tue chiamate
Retell AI è una piattaforma di agenti vocali con IA per i contact center. Parla con il team di Retell di un progetto pilota su chiamate reali.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


