El listón para comprar IA de voz ha cambiado: de la voz natural a la iteración rápida y segura




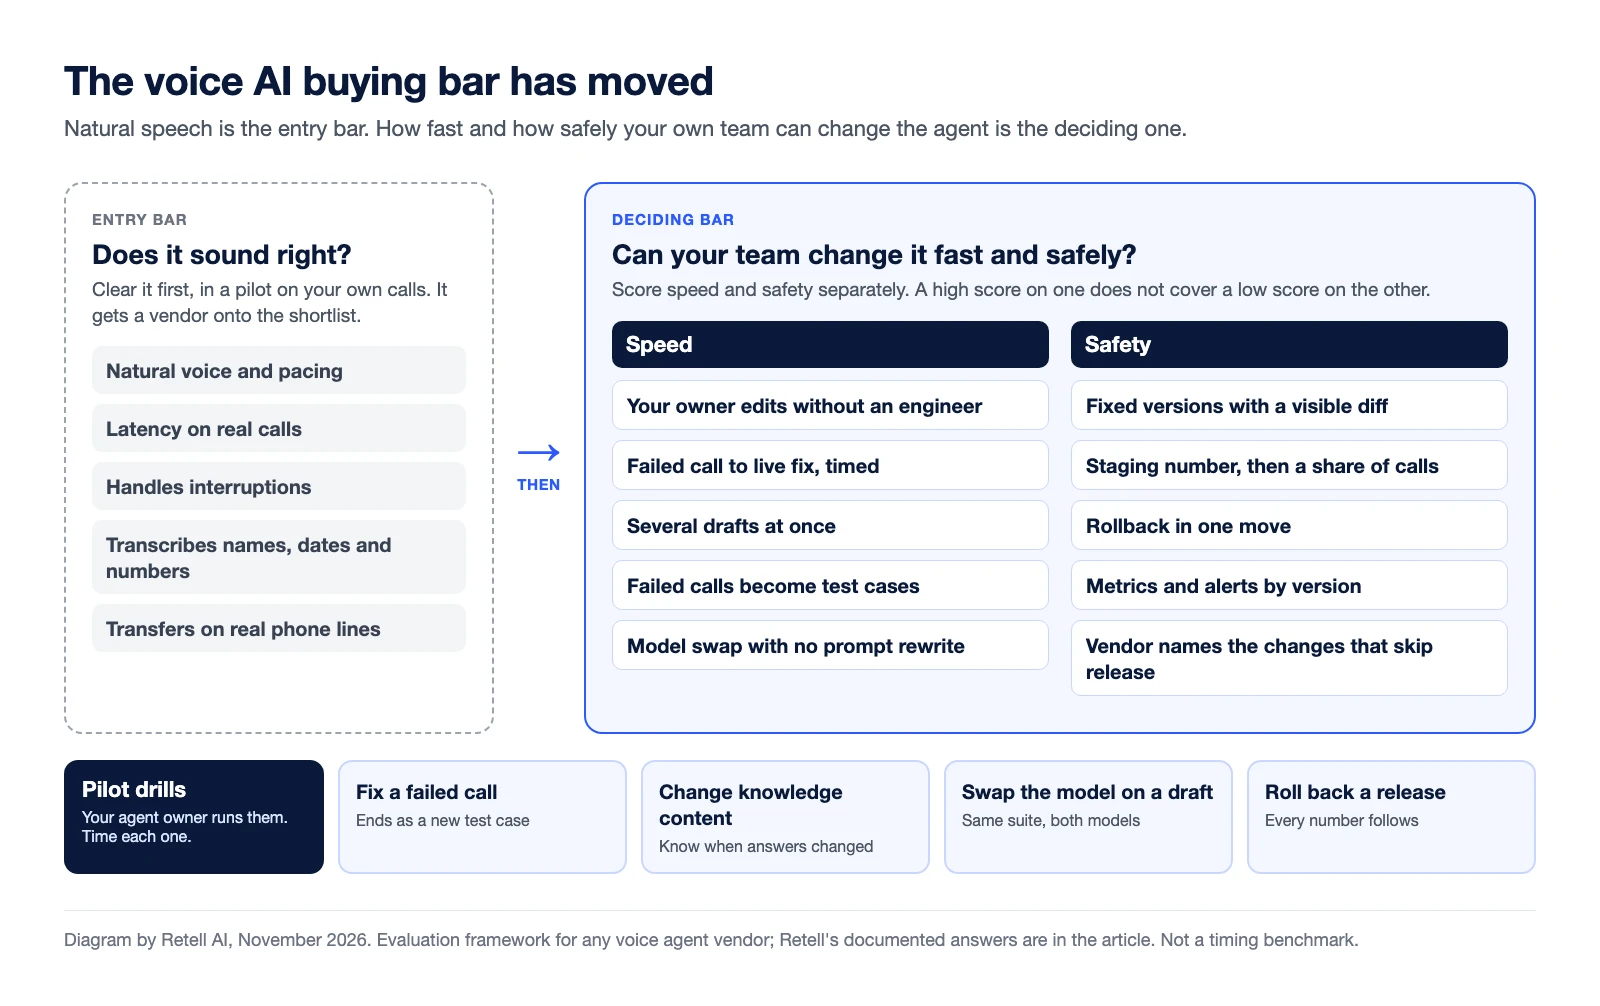
Los criterios de evaluación de IA de voz son las pruebas que usa un comprador para decidir si una plataforma de agentes de voz resistirá en sus propias líneas telefónicas. Antes, la prueba decisiva era una voz con sonido natural. Ahora es el requisito de entrada. Cuando todos los proveedores de la lista corta suenan bien en una llamada, la pregunta decisiva es con qué rapidez puede tu equipo cambiar el agente, y con qué seguridad.
En las conversaciones de compra se repite un patrón. La primera ronda de evaluación compara voces, latencia e interrupciones. La segunda pregunta qué pasa el día 40, cuando cambia una política, una campaña saliente necesita un nuevo guion o sale un modelo más reciente. Un proveedor que no puede responder a esas preguntas con una demo en directo del proceso de cambio te está vendiendo el lanzamiento y dejándote a ti la operación.
Retell AI publica esta guía y vende una plataforma de agentes de voz. Las preguntas sirven para cualquier proveedor, incluidos nosotros, y señalamos dónde tienen límites nuestras propias respuestas documentadas.
¿Por qué la voz natural ya no basta para elegir proveedor?
Porque la calidad de voz decide la primera semana de vida de un agente y los cambios deciden el resto. Sigues teniendo que comprobar que el agente suena bien en tus llamadas: cómo evaluar una plataforma de agentes de voz antes de salir a producción cubre la latencia, las interrupciones, la transcripción y las transferencias en un piloto. Pero un agente de voz nunca está terminado. Las personas que llaman formulan cosas que tus guiones no esperaban, los precios y las políticas cambian y llegan nuevos tipos de llamada.
Cada uno de esos cambios es una publicación en producción sobre una línea telefónica, donde una frase errónea llega a una persona real antes de que nadie lea la transcripción. Por eso el listón tiene dos partes, velocidad y seguridad, y por eso debes puntuar ambas.
Los equipos de software ya miden así la entrega. DORA, un programa de investigación de Google Cloud, divide el rendimiento de la entrega de software en rendimiento e inestabilidad: la rapidez con que los cambios llegan a producción y la frecuencia con que requieren una reversión o un parche urgente. DORA afirma que "la velocidad y la estabilidad no son contrapartidas" y que las métricas están correlacionadas en la mayoría de los equipos. Un proveedor no debería pedirte que elijas entre cambiar el agente rápido y cambiarlo de forma segura.
¿Qué cambios deberías puntuar en un proveedor?
Puntúa los cambios que de verdad vas a hacer, no una valoración genérica de "facilidad de uso". Cada tipo de cambio conlleva un riesgo distinto, así que pregunta por cada uno por separado.
| Cambio | Ejemplo | Cómo es hacerlo rápido | Cómo es hacerlo seguro |
|---|---|---|---|
| Redacción del prompt | Reformular la política de reembolsos | El responsable del agente lo edita sin un ingeniero | Una versión numerada, un diff visible y una prueba antes de que lo oigan las personas que llaman |
| Contenido de conocimiento | Nueva lista de precios u horario de apertura | Actualizar la fuente una sola vez | Sabes cuándo llega la actualización a las respuestas en directo |
| Flujo de conversación | Añadir una rama para un nuevo motivo de llamada | Editar el flujo en el editor | Las partes compartidas no cambian otros agentes por sorpresa |
| Modelo | Pasar a un LLM más reciente o más barato | Sin reescribir el prompt | El mismo conjunto de pruebas se ejecuta en ambos modelos antes del cambio |
| Campaña saliente | Nuevo guion a mitad de campaña | Cambiar la versión del agente que usa la campaña | Un borrador no puede llegar a las marcaciones reales por accidente |
| Voz o saludo | Nueva voz o frase de apertura | Cambiarlo en la configuración | Alguien lo escucha en una llamada antes de publicarlo |
El resto de esta guía convierte esa tabla en preguntas. Para el proceso práctico de publicación una vez elegida la plataforma, consulta cómo probar y publicar cambios en agentes de voz.
¿Qué deberías preguntar sobre la velocidad de iteración?
Pregunta quién puede hacer un cambio y cuánto tarda una corrección real, y luego haz que el proveedor lo demuestre.
- ¿Quién de nuestro equipo puede cambiar el agente y necesita un ingeniero? La respuesta debería nombrar un rol de tu lado, no el equipo de servicios del proveedor. El control de acceso de Retell separa los roles que pueden crear, probar y editar agentes de un rol Member de solo lectura.
- ¿Cuánto se tarda desde una llamada fallida hasta una corrección en llamadas reales? No aceptes una estimación. Elige una llamada fallida del piloto, idealmente una que muestre un modo de fallo conocido de agentes de voz, y haz que tu propio responsable la corrija, la compruebe y la publique mientras tú miras.
- ¿Podemos probar más de una corrección a la vez? Las versiones de agente de Retell te permiten crear un borrador a partir de cualquier versión anterior y mantener varios borradores a la vez para probar enfoques distintos.
- ¿Puede una llamada fallida convertirse en caso de prueba sin escribirlo a mano? En Retell, Conductor puede convertir una llamada de Call History o de AI QA en un caso de prueba de simulación, redactando el perfil y los criterios de éxito. Su documentación advierte que aun así debes revisar cada caso y simular cualquier función que llegue a un endpoint real.
- ¿Puede ejecutarse el conjunto de pruebas de regresión desde nuestro propio pipeline? La API de pruebas por lotes de Retell inicia un lote y, al consultarla, devuelve sus recuentos de aprobados, fallidos y errores, de modo que un job de CI puede comprobar los resultados antes de desplegar.
- ¿Un cambio de modelo implica reescribir? Para agentes de un solo prompt y de varios prompts, la documentación de Retell indica que puedes cambiar de modelo más adelante sin reescribir tu prompt.
- ¿Cuánto cuesta iterar? En Retell, las pruebas se facturan a tarifas de producción, por mensaje en las pruebas de texto y por minuto en las pruebas web y telefónicas. Inclúyelo en el presupuesto, porque un conjunto de pruebas que no puedes permitirte repetir no se repetirá.
¿Qué deberías preguntar sobre la seguridad de la iteración?
Pregunta cómo se contiene un cambio antes de publicarlo, cómo se expone después y con qué rapidez puede deshacerse.
- ¿Cada cambio es una versión fija a la que puedes volver? En Retell, publicar una versión de agente en borrador la convierte en solo lectura, "lo que te da una configuración fija a la que puedes volver más adelante". El concepto se explica en versionado de prompts.
- ¿Podemos ver exactamente qué ha cambiado? La comparación de versiones de Retell muestra dos versiones lado a lado, con diffs a nivel de palabra para textos de prompt largos y los cambios en las bases de conocimiento y funciones vinculadas.
- ¿Puede un cambio llegar a unas pocas personas antes que a todas? El SRE workbook de Google define el canarying como "un despliegue parcial y limitado en el tiempo de un cambio en un servicio y su evaluación". En Retell, las pruebas A/B reparten por porcentaje el tráfico entrante o saliente de un número entre agentes. Cada agente empieza además con las etiquetas de entorno prod y staging, así que puedes apuntar staging a una nueva versión y llamarla primero desde un número de prueba.
- ¿Cómo revertimos y lo siguen todos los números? En Retell, mueves la etiqueta prod de vuelta a la versión anterior y los números asociados a la etiqueta la siguen. Los números asignados directamente a una versión se quedan en esa versión, así que pregunta cómo comprobar qué números usan la etiqueta.
- ¿Qué nos indica que un cambio ha empeorado las cosas? El panel de analítica de Retell desglosa las métricas por versión de agente, las reglas de alerta pueden limitarse a etiquetas de entorno y compararse con el ciclo anterior, y AI QA puntúa una muestra de llamadas en busca de problemas como las alucinaciones.
Después haz la pregunta que la mayoría de las evaluaciones se saltan: ¿qué cambios eluden el proceso de publicación? Todas las plataformas tienen alguno. Un proveedor que nombra los suyos es más fácil de operar de forma segura que uno que afirma que no hay ninguno. Estos son los de Retell, según su documentación:
- Subflujos compartidos. Un subflujo de biblioteca se comparte entre agentes, y una edición llega a todos los agentes que lo usan, incluidas las versiones publicadas. La documentación indica que lo conviertas en un subflujo local antes de publicar si quieres evitarlo.
- Conocimiento con actualización automática. Con la actualización automática activada, una base de conocimiento vuelve a obtener sus fuentes URL y resincroniza los archivos conectados modificados cada 24 horas, así que una edición en una página fuente puede llegar a las respuestas en la siguiente actualización y no mediante una nueva versión del agente.
- Campañas configuradas con el último borrador. Un paso de campaña puede usar una versión fija, la última versión publicada, una etiqueta o la última versión creada. La documentación de Dialer desaconseja Latest Created, porque un borrador que aún estás editando llega a llamadas reales en la siguiente marcación.
¿Las campañas salientes y los cambios de modelo necesitan preguntas distintas?
Sí, porque ambos cambian las llamadas reales de formas en que no lo hace una edición del prompt.
Campañas. Una campaña saliente en curso son muchas llamadas futuras en cola contra un mismo agente. Pregunta qué versión usa cada marcación y qué puedes cambiar una vez que la campaña está en marcha. Dialer de Retell resuelve la versión del agente en cada marcación, no en el lanzamiento, así que una versión fija mantiene el agente estable durante toda la campaña y Latest Published incorpora a ella los cambios publicados. La secuencia y la lista de contactos se bloquean en el lanzamiento, y cambiarlas implica duplicar la campaña. Una pausa detiene las nuevas marcaciones en aproximadamente un minuto mientras terminan las llamadas ya realizadas.
Modelos. Un cambio de modelo puede alterar a la vez la redacción, las llamadas a herramientas y los tiempos. Pregunta si el mismo conjunto de pruebas puede ejecutarse en el modelo antiguo y en el nuevo, y si puedes usar un modelo de respaldo rápido. Para agentes de voz con modelos gestionados por Retell, la configuración de LLM de Retell ofrece un modelo de fallback rápido que se ejecuta junto al principal, y la documentación indica que compruebes que ambos modelos siguen las instrucciones y llaman a las herramientas correctamente antes de desplegar. También indica que vuelvas a probar las instrucciones y las llamadas a herramientas después de cambiar la temperatura.
¿Cómo puntúas a los proveedores en iteración rápida y segura?
Haz los mismos cuatro ejercicios en cada plataforma de la lista corta durante el piloto, con la persona que será responsable del agente haciendo el trabajo, y cronometra cada uno.
| Ejercicio | Qué registrar | Un resultado aprobado |
|---|---|---|
| Corregir una llamada fallida | Tiempo desde que se encuentra la llamada hasta que la corrección funciona en un número de staging | Tu responsable lo hace sin ayuda del proveedor, y la llamada fallida ya es un caso de prueba |
| Cambiar el contenido de conocimiento | Cuándo llegó el cambio a las respuestas en directo y cómo lo confirmaste | Puedes decir qué llamadas oyeron el contenido antiguo y cuáles el nuevo |
| Cambiar el modelo en un borrador | Tasa de aprobación del mismo conjunto de pruebas en ambos modelos | El conjunto se vuelve a ejecutar sin reescribir nada, y el resultado decide el cambio |
| Revertir una publicación defectuosa | Tiempo desde la decisión hasta que todos los números de producción están en la versión anterior | Un solo paso, y puedes mostrar qué números la siguieron |
Puntúa la velocidad y la seguridad por separado, de uno a cinco cada una, y no dejes que una puntuación alta en una oculte una baja en la otra. Una plataforma en la que las correcciones salen en una hora pero no pueden revertirse suspende. También suspende una en la que todos los cambios son seguros pero requieren un ticket al proveedor. El propio consejo de DORA para mejorar ambas a la vez es mantener cada cambio pequeño: "Los cambios más pequeños también son más fáciles de recuperar si hay un fallo".
Otras dos páginas cubren decisiones relacionadas. Si desarrollar, comprar o usar un servicio gestionado decide quién hace estos ejercicios; consulta desarrollar o comprar agentes de voz con IA. El caso financiero del programa está en el ROI de los agentes de voz con IA. Esta tabla de puntuación da ambas por resueltas y solo pregunta si tu equipo puede seguir mejorando el agente. Qué llamadas automatizar primero es una decisión aparte, tratada en cómo elegir casos de uso de IA de voz.
Preguntas frecuentes
¿Cuáles son los criterios más importantes al evaluar una plataforma de IA de voz?
Empieza por si completa tu flujo de trabajo en tus propias llamadas, encaja con tus sistemas telefónicos y de datos y suena natural. Cuando los proveedores de la lista corta superan eso, el criterio que los diferencia es la iteración: con qué rapidez puede tu equipo cambiar prompts, conocimiento, flujos, campañas y modelos, y con qué seguridad llegan esos cambios a las personas que llaman.
¿Cómo pruebas con qué rapidez te permite un proveedor cambiar un agente de voz?
Elige una llamada fallida del piloto y pide a la persona que será responsable del agente que la corrija, la compruebe, la publique en un número de prueba y la revierta mientras tú la cronometras. Repite con un cambio de conocimiento y un cambio de modelo en un borrador. Una demo grabada por el propio personal del proveedor no cuenta.
¿Qué hace que un cambio en un agente de voz sea seguro?
Un cambio seguro es una versión fija con un diff visible, supera un conjunto de pruebas guardado antes de publicarse, llega primero a una pequeña parte de las llamadas y puede revertirse en un solo paso. También necesitas saber qué cambios se saltan ese proceso, como los componentes compartidos o el conocimiento con actualización automática.
¿Quién debería hacer los ejercicios de iteración durante un piloto?
La persona que será responsable del agente tras el lanzamiento, no el equipo del proveedor. Algunos equipos asignan esa tarea a un ingeniero de automatización de CX, el responsable interno que detecta las llamadas mal gestionadas, crea correcciones, las comprueba y las despliega.
¿Puedes cambiar el modelo de lenguaje de un agente de voz sin reconstruirlo?
Muchas plataformas lo permiten, pero no deberías cambiarlo a ciegas. Ejecuta el mismo conjunto de pruebas en ambos modelos, compara los resultados y publica el nuevo modelo primero para una parte de las llamadas. En los agentes de un solo prompt y de varios prompts de Retell, la documentación indica que puedes cambiar de modelo más adelante sin reescribir tu prompt, y que compruebes que el modelo de fallback sigue tus instrucciones y vuelvas a probar las llamadas a herramientas después de cambiar la temperatura.
Incluye la iteración en tu tabla de evaluación
El listón de compra de la IA de voz ha pasado de "¿suena humano?" a "¿podemos cambiarlo rápido sin romper llamadas?". Retell es una plataforma de agentes de voz con IA para centros de contacto, con versiones en borrador, comparación de versiones, etiquetas de entorno, pruebas de simulación y por lotes, reparto de tráfico A/B y AI QA, para que la persona responsable del agente pueda probar, publicar y revertir un cambio sin esperar al proveedor. El precio es de pago por uso desde 0,07 $ por minuto en la página de precios. Lleva tu cambio más difícil al piloto y cronométralo.
Descubre cuánto podría ahorrar tu empresa al pasar a agentes de voz impulsados por IA.
Resultado del ROI
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Un número de teléfono de demostración de Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs

Revoluciona tu operación de llamadas con Retell


