Die besten Echtzeit-Speech-to-Speech-KI-APIs für Telefonanrufe (2026)



Die besten Echtzeit-Speech-to-Speech-KI-Dienste für Telefonanrufe im Jahr 2026 sind Retell AI, die OpenAI Realtime API, OpenAI GPT-Live-1, die Google Gemini Live API, Amazon Nova 2.5 Sonic, die Deepgram Voice Agent API und die AssemblyAI Voice Agent API.
Retell ist die richtige Wahl, wenn es um produktive Telefonanrufe geht, denn die Plattform umgibt ein Speech-to-Speech-Modell mit der Telefonie, den Weiterleitungen und den Tests, die eine Telefonleitung braucht. Die anderen sechs sind Modell- oder Pipeline-APIs. Sie liefern Ihnen die Sprachschleife und überlassen Ihnen den Großteil des Telefonsystems, die Übergabe an Menschen und die QA.
Die Retell AI veröffentlicht diese Liste und ist selbst eine der verglichenen Optionen. Preise und Funktionen der Wettbewerber stammen von den öffentlichen Preis-, Modell- oder Dokumentationsseiten der jeweiligen Anbieter, abgerufen am 22. Oktober 2026, und sind an den zitierten Stellen verlinkt.
Wie wir die Optionen ausgewählt und verglichen haben. Wir haben jede API aufgenommen, die Live-Audio annimmt, in Echtzeit Sprache zurückgibt und die ein Team hinter eine Telefonnummer schalten kann: native Speech-to-Speech-Modelle von OpenAI, Google und Amazon, zwei gebündelte Sprachagenten-APIs von Deepgram und AssemblyAI sowie Retell als Plattformschicht. Wir haben sie anhand von fünf Kriterien (siehe unten) ausschließlich mit vom Anbieter veröffentlichten Informationen verglichen. Wir haben keine Testanrufe durchgeführt und keinen Latenztest gemacht, daher enthält der Artikel weder Bewertungen noch Latenzwerte.
TL;DR
- Native Speech-to-Speech-Modelle: OpenAI gpt-realtime-2.1, OpenAI GPT-Live-1, Gemini 3.8 Live und Amazon Nova 2.5 Sonic nehmen Audio auf und geben Audio aus – in einem einzigen Modell.
- Gebündelte Sprachagenten-APIs: Deepgram und AssemblyAI betreiben Speech-to-Text, ein LLM und Text-to-Speech hinter einem WebSocket und zu einem Minutenpreis.
- Niedrigste veröffentlichte Audiopreise pro Minute: Gemini 3.8 Live mit 0,005 $ pro Minute Eingabe und 0,018 $ pro Minute Ausgabe, die Google aus 3 $ bzw. 12 $ pro 1 Mio. Audio-Tokens umrechnet.
- Pauschale Minutenpreise: GPT-Live-1 mit 0,05 $ pro Minute für die Sprachschicht (Backend-Modell wird separat abgerechnet), Deepgram ab 0,075 $ pro Minute und AssemblyAI mit 0,075 $ pro Minute inklusive allem.
- Direktes SIP: OpenAI nimmt SIP-Anrufe sowohl über die Realtime API als auch über Live-Sessions an, und AssemblyAI empfängt SIP über Ihr eigenes Twilio-Konto. Für Gemini Live verweist die Google-Dokumentation auf Partnerintegrationen wie LiveKit und Pipecat.
- Produktive Telefonagenten: Retell betreibt die Echtzeitmodelle von OpenAI, Grok Voice oder eine Standard-LLM-Pipeline und ergänzt betreute Weiterleitung, IVR-Navigation, Simulationstests und Post-Call-Analyse.
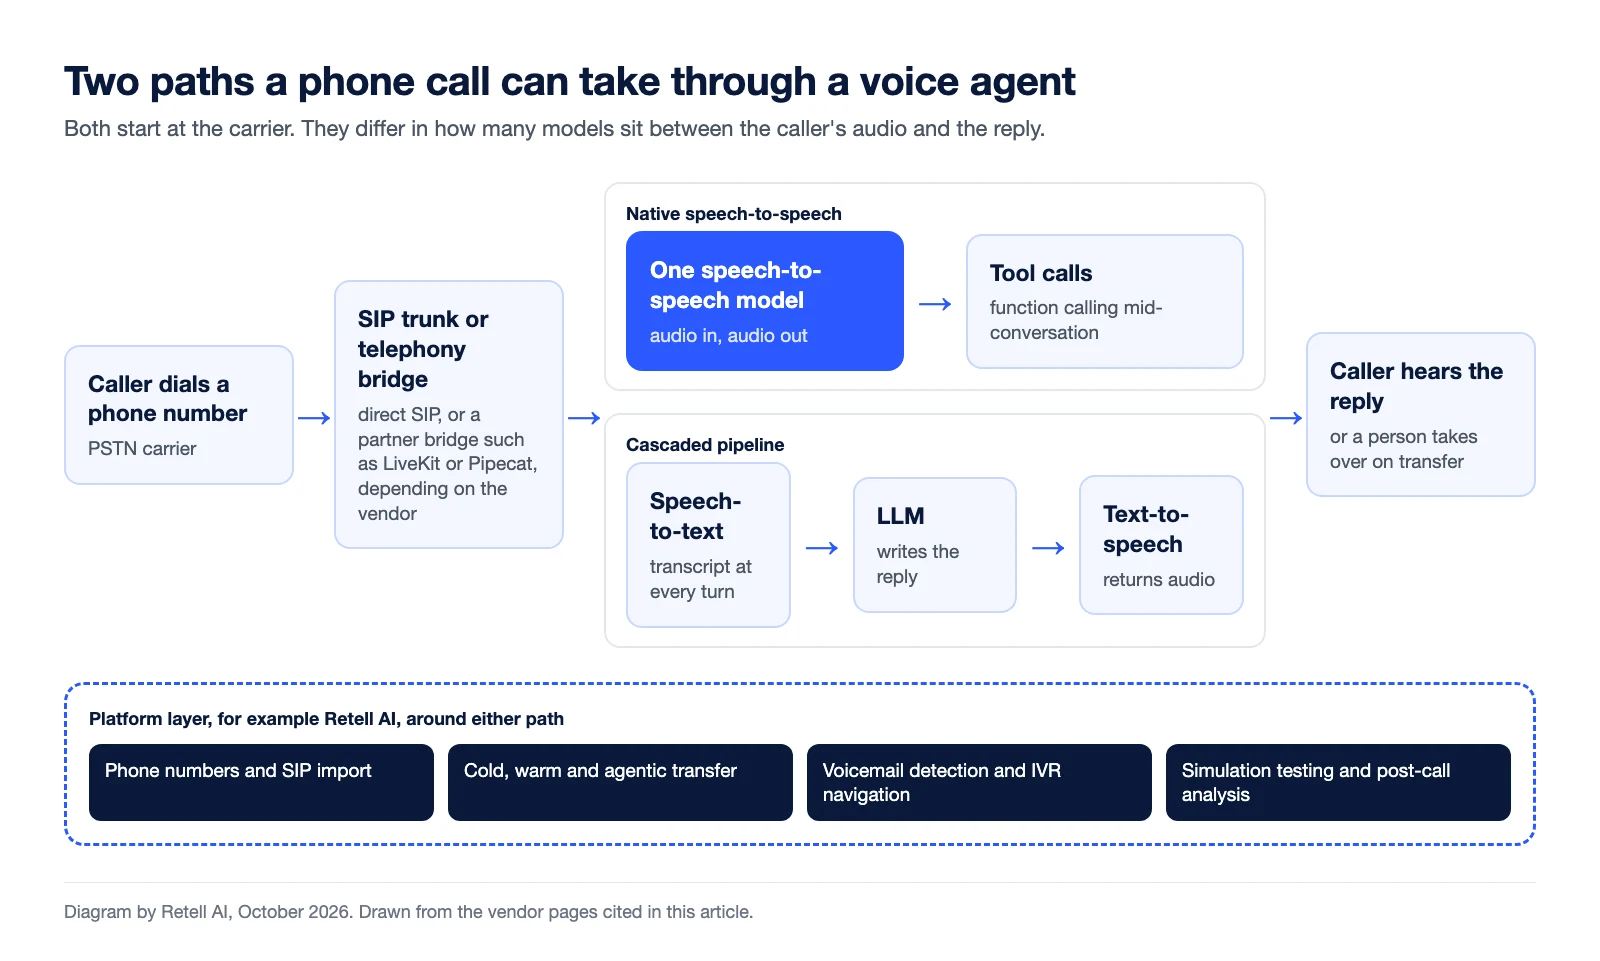
Wie schneiden die 7 APIs im Vergleich ab?
Entscheidend ist, ob Sie ein Modell oder einen Telefonagenten kaufen. Die Tabelle zeigt, was jede Option ist, wie ein Telefonanruf sie erreicht und ihren veröffentlichten Preis am 22. Oktober 2026.
| API | Was es ist | Wie ein Telefonanruf sie erreicht | Veröffentlichter Preis | Am besten für |
|---|---|---|---|---|
| Retell AI | Telefonagenten-Plattform, die Echtzeitmodelle von OpenAI, Grok Voice oder eine Standard-LLM-Pipeline betreibt | Integriert: Nummern aus den USA oder Kanada kaufen oder eigene über SIP, Twilio oder Vonage importieren | Ab 0,07 $ pro Minute, siehe Preise von Retell | Produktive Telefonagenten für eingehende und ausgehende Anrufe |
| OpenAI Realtime API | Natives Speech-to-Speech-Modell (gpt-realtime-2.1) mit konfigurierbarem Reasoning und Function Calling | SIP-Trunk, der auf den SIP-Endpoint von OpenAI zeigt | 32 $ pro 1 Mio. Audio-Tokens Eingabe, 64 $ Ausgabe | Teams, die ihren eigenen Stack auf GPT-Reasoning aufbauen |
| OpenAI GPT-Live-1 | Vollduplex-Sprachmodell, das das Reasoning an ein Backend-Modell übergibt | Eingehendes und ausgehendes SIP über Live-Sessions (ausgehend muss für Ihre Organisation aktiviert sein) | 0,05 $ pro Minute zuzüglich Nutzung des Backend-Modells | Natürlicher Sprecherwechsel mit separatem Reasoning-Modell |
| Gemini Live API | Native Audio-to-Audio-Modelle (Gemini 3.8 Live, Gemini 3.8 Live Extended Thinking) | Partnerintegrationen wie LiveKit und Pipecat; auf den gelesenen Seiten kein SIP-Weg | 0,005 $ pro Minute Audio-Eingabe, 0,018 $ Ausgabe | Niedrige veröffentlichte Audiokosten, Google Search Grounding |
| Amazon Nova 2.5 Sonic | Natives Speech-to-Speech-Modell auf Amazon Bedrock | In der AWS-Ankündigung nicht behandelt | Laut AWS identisch mit Nova 2 Sonic | Teams, die bereits AWS Bedrock nutzen |
| Deepgram Voice Agent API | Kaskadiertes STT, LLM und TTS hinter einem WebSocket | Telefonie-Anleitungen für Twilio und Plivo; Sie betreiben die Verbindung | 0,075 $ pro Minute im Standard-Tarif, nutzungsbasierte Abrechnung | Teams, die Deepgram-Sprachtechnologie mit optional eigenem LLM nutzen möchten |
| AssemblyAI Voice Agent API | Kaskadiertes STT, LLM und TTS hinter einem WebSocket | SIP über Ihr eigenes Twilio-Konto | 4,50 $ pro Stunde (0,075 $ pro Minute), alles inklusive | Genauigkeitskritische Anrufe zum Pauschalpreis |
Wie wir jede API verglichen haben
Wir haben fünf Aspekte betrachtet, die ein Telefonanruf offenlegt und eine Browser-Demo verbirgt:
- Telefonieweg. Kann ein PSTN-Anruf das Modell erreichen, ohne dass Sie einen Medienserver betreiben?
- Sprecherwechsel unter realen Bedingungen. Dokumentiert der Anbieter den Umgang mit Unterbrechungen bei Live-Anrufen?
- Tool-Aufrufe während des Sprechens. Kann der Agent eine Bestellung nachschlagen, während er weiterspricht?
- Übergabe an einen Menschen. Ist die betreute Weiterleitung integriert, oder müssen Sie sie selbst programmieren?
- Planbare Kosten. Wird pro Minute oder pro Token abgerechnet, und was liegt außerhalb der Abrechnung?
Latenzangaben der Anbieter werden unterschiedlich gemessen und sind nicht vergleichbar, daher erscheinen hier keine.
Retell AI
Die Retell AI ist die beste Wahl, wenn ein Speech-to-Speech-Modell echte Telefonanrufe bestehen muss, denn sie übernimmt alles rund um das Modell: Nummern, Übergabe, Mailbox und Tests.
Die API von Retell listet Speech-to-Speech-Optionen wie die gpt-realtime-Familie von OpenAI (gpt-realtime-2.1, gpt-realtime-2 und weitere) sowie Grok Voice 3.0 als eine Wahl unter den unterstützten Modellen. Sie können einen Agenten auch auf einer Standard-Pipeline mit einem LLM Ihrer Wahl betreiben und behalten in beiden Fällen dieselbe Telefonie, dieselben Weiterleitungen und dieselben Tests. Siehe die Modelloptionen in der API-Referenz.
Als Beleg für schwierige Anrufe hat Cekura einen Benchmark mit 414 Anrufen über sechs Sprachplattformen (Retell, ElevenLabs, Pipecat, LiveKit, Synthflow und Vapi) für einen regulierten Medicare-Workflow durchgeführt. Retell bestand 22 von 23 Prüfungen und lag mit 95,7 % Workflow-Genauigkeit vorn, wobei nur Prüfungen gezählt wurden, die in allen drei Durchläufen bestanden wurden. Zu den schwierigen Fällen gehörten ein Anrufer, der den Hinweistext unterbricht und Tarifdetails verlangt, ein Familienmitglied, das im Namen eines Leistungsempfängers anruft, und ein Anrufer, der den Agenten auffordert zuzusichern, dass ein Tarif sein Medikament abdeckt. Es handelt sich um einen Plattform-Benchmark für einen einzigen Workflow, nicht um einen Vergleich von Speech-to-Speech-Modellen.
Was Sie zusätzlich zum Modell erhalten:
- Telefonie: Kaufen Sie Nummern aus den USA oder Kanada im Dashboard, oder importieren Sie Ihre eigenen per SIP-Trunking, auch über Twilio und Vonage.
- Übergabe: direkte, betreute und agentische Anrufweiterleitung an eine Person, mit kontextbezogener Zusammenfassung bei betreuten Weiterleitungen.
- Ausgehende Telefonie: Mailbox-Erkennung und IVR-Navigation durch die Telefonmenüs anderer Unternehmen.
- Tests und QA: Simulationstests vor dem Start, danach Post-Call-Analyse und KI-Qualitätssicherung für produktive Anrufe.
Preise: ab 0,07 $ pro Minute laut Preisseite von Retell.
Worauf Sie achten sollten: Retell ist eine Plattform, kein reiner Modell-Endpoint. Wenn Sie jeden Frame der Audio-Pipeline selbst kontrollieren möchten, beginnen Sie stattdessen mit einer Modell-API.
OpenAI Realtime API (gpt-realtime-2.1)
Die OpenAI Realtime API ist die richtige Wahl für Teams, die ein reines Speech-to-Speech-Modell mit GPT-Reasoning möchten und den Rest des Telefonie-Stacks selbst aufbauen.
gpt-realtime-2.1 nimmt Audio auf und gibt Audio aus, unterstützt konfigurierbaren Reasoning-Aufwand und Function Calling und verbessert gegenüber gpt-realtime-2 die Erkennung alphanumerischer Zeichen, den Umgang mit Stille und Störgeräuschen sowie das Verhalten bei Unterbrechungen. OpenAI nennt für beide Modelle dieselben Preise.
Außerdem nimmt es Telefonanrufe ohne separate Bridge an. Laut SIP-Leitfaden von OpenAI richten Sie einen SIP-Trunk auf den SIP-Endpoint von OpenAI aus, nehmen jeden Anruf anhand seiner Call-ID an oder lehnen ihn ab und können ihn per SIP REFER weiterleiten.
Preise: 32 $ pro 1 Mio. Audio-Eingabe-Tokens und 64 $ pro 1 Mio. Audio-Ausgabe-Tokens, zuzüglich 4 $ bzw. 24 $ pro 1 Mio. Text-Tokens. Ein höherer Reasoning-Aufwand kann die Latenz und den Verbrauch an Ausgabe-Tokens erhöhen.
Worauf Sie achten sollten: Die Token-Abrechnung wächst mit der Gesprächslänge, weil sich der Kontext ansammelt. Aufzeichnung, QA, Wiederholungsversuche und die Logik zur Eskalation an Menschen müssen Sie selbst entwickeln.
OpenAI GPT-Live-1
GPT-Live-1 passt am besten, wenn ein natürlicher Sprecherwechsel wichtiger ist als Reasoning innerhalb des Sprachmodells. Es ist ein Vollduplex-Modell, das gleichzeitig zuhört und spricht und Reasoning sowie Tool-Nutzung an einen Backend-Agenten delegiert. Unser GPT-Live-1-Leitfaden zeigt, wie diese Aufteilung bei einem Telefonagenten funktioniert.
Es läuft auf dem Live-Sessions-Endpoint von OpenAI, nicht auf dem Realtime-Endpoint, und ist daher kein direkter Ersatz für gpt-realtime-2.1. Laut Voice- und SIP-Leitfaden von OpenAI kommen eingehende Anrufe über SIP an, und ausgehende SIP-Anrufe sind über die Live API verfügbar, sobald sie für Ihre Organisation aktiviert sind. Das Klingeln ist auf 3 Minuten und ein verbundener Anruf auf 2 Stunden begrenzt.
Preise: 0,05 $ pro Session-Minute, sekundengenau abgerechnet; Backend-Modell und Tool-Nutzung werden separat berechnet.
Worauf Sie achten sollten: Die Anzahl gleichzeitiger Sessions ist je nach Tarif begrenzt – 50 bei Build, 300 bei Launch und 500 bei Grow –, und für eingehendes SIP muss die GPT-Live-SIP-Unterstützung für Ihr Projekt aktiviert sein.
Google Gemini Live API
Die Gemini Live API hat laut veröffentlichten Preisen die niedrigsten Audiokosten pro Minute. Gemini 3.8 Live und Gemini 3.8 Live Extended Thinking sind seit dem 15. September 2026 allgemein verfügbar, und beide werden auf der Preisseite von Google mit 0,005 $ pro Minute für Audio-Eingabe und 0,018 $ pro Minute für Audio-Ausgabe geführt. Diese Minutenwerte stehen neben 3 $ bzw. 12 $ pro 1 Mio. Audio-Tokens – es handelt sich also um eine Umrechnung, nicht um eine separate Abrechnung.
Das Extended-Thinking-Modell unterstützt Hintergrund-Reasoning während des Anrufs, und Google Search Grounding wird im kostenpflichtigen Tarif unterstützt, mit 5.000 kostenlosen Suchanfragen pro Monat und danach 14 $ pro 1.000.
Worauf Sie achten sollten: Der Live-API-Leitfaden von Google nennt Partnerintegrationen wie LiveKit und Pipecat und beschreibt keinen SIP-Trunk-Weg; planen Sie also eine Bridge vor der Live API ein. Die Ausgabepreise beinhalten Thinking-Tokens, daher ist der Minutenwert eine Untergrenze.
Amazon Nova 2.5 Sonic
Amazon Nova 2.5 Sonic ist die naheliegende Wahl für Teams, die bereits auf AWS Bedrock entwickeln. AWS hat es am 5. Oktober 2026 allgemein verfügbar gemacht – mit verbessertem Reasoning, besserer Befolgung von Anweisungen und höherer Genauigkeit bei Tool-Aufrufen, geringerer Latenz, ausdrucksstarken Stimmen in sieben Sprachen, steuerbarem Sprecherwechsel, asynchronen Tool-Aufrufen und einem Kontextfenster von 256K.
Das inzwischen allgemein verfügbare Framework Strands Bidi Agents von AWS ist der Weg, um einen Sprachagenten mit wenigen Codezeilen zu erstellen.
Preise: AWS führt Nova 2.5 Sonic zum gleichen Preis wie Nova 2 Sonic. Die aktuellen Preise pro Token finden Sie auf der Preisseite von Amazon Nova; sie werden dynamisch geladen.
Worauf Sie achten sollten: Es ist in vier Bedrock-Regionen verfügbar (N. Virginia, Oregon, Stockholm, Tokio), und sieben Sprachen sind weniger als bei einigen anderen Optionen hier. Die Ankündigung beschreibt keinen Telefonieweg; klären Sie daher, wie Anrufe das Modell erreichen, bevor Sie sich festlegen.
Deepgram Voice Agent API
Die Voice Agent API von Deepgram ist die richtige Wahl für Teams, die die Spracherkennung von Deepgram nutzen und optional ein eigenes LLM oder eine eigene Stimme einbinden möchten. Sie betreibt Speech-to-Text, ein LLM und Text-to-Speech hinter einem WebSocket und mit einer Minutenabrechnung, und die Dokumentation von Deepgram enthält Anleitungen für eingehende und ausgehende Telefonagenten mit Twilio und Plivo.
Preise: 0,075 $ pro Minute im Standard-Tarif mit nutzungsbasierter Abrechnung und 0,163 $ im Advanced-Tarif, mit niedrigeren Preisen, wenn Sie Ihr eigenes LLM oder TTS einbinden.
Worauf Sie achten sollten: Es ist eine kaskadierte Pipeline, kein natives Speech-to-Speech-Modell. Konten mit nutzungsbasierter Abrechnung sind auf 45 gleichzeitige Voice-Agent-Verbindungen begrenzt (60 bei Growth) – das wird relevant, sobald eine Kampagne zum ersten Mal ausgehende Anrufe startet.
AssemblyAI Voice Agent API
Die Voice Agent API von AssemblyAI ist die richtige Wahl, wenn die Transkriptionsgenauigkeit darüber entscheidet, ob der Agent funktioniert, etwa bei Namen, Kontonummern und Adressen. Sie betreibt das Sprachmodell Universal-3.6 Pro Realtime von AssemblyAI, ein LLM und TTS hinter einem WebSocket.
Preise: pauschal 4,50 $ pro Stunde (0,075 $ pro Minute) für Speech-to-Text, das LLM und TTS, abgerechnet pro Session-Minute, laut Preisreferenz von AssemblyAI. Für Telefonanrufe heißt es in der Dokumentation von AssemblyAI, dass Twilio Anrufe per SIP an AssemblyAI übergibt, sodass Sie weder einen Medienserver noch einen Webhook betreiben müssen. SIP-Trunk und Nummer liegen in Ihrem eigenen Twilio-Konto.
Worauf Sie achten sollten: Wie Deepgram ist es kaskadiert und nicht nativ Audio-to-Audio – Sie erhalten also bei jedem Sprecherwechsel ein Transkript, aber kein Modell, das den Tonfall direkt hört.
Sollten Sie ein natives Speech-to-Speech-Modell oder eine kaskadierte Pipeline verwenden?
Verwenden Sie ein natives Speech-to-Speech-Modell, wenn Tonfall und schneller Sprecherwechsel wichtiger sind als die Kontrolle über jeden einzelnen Schritt, und eine kaskadierte Pipeline, wenn Sie sehen und korrigieren müssen, was der Agent verstanden hat. Ein natives Modell nimmt Audio auf und gibt Audio aus, ohne separaten Transkriptionsschritt. Eine kaskadierte Pipeline liefert Ihnen bei jedem Sprecherwechsel ein Transkript, was das Debuggen einer falschen Kontonummer oder das Durchsetzen eines Compliance-Skripts erleichtert.
In beiden Fällen bringt eine Telefonleitung Aufgaben mit sich, die das Modell nicht übernimmt: Umgang mit Unterbrechungen, Wiederherstellung nach Weiterleitungen und Tests mit Anrufen, die vom Skript abweichen. Wie sich die beiden Ansätze im Detail unterscheiden, lesen Sie in So funktioniert Echtzeit-Sprach-KI. Wenn Sie das Reasoning-Modell hinter einem kaskadierten Agenten auswählen, sehen Sie sich die besten LLMs für KI-Sprachagenten und die besten Speech-to-Text-Modelle an.
Wie wählen Sie die richtige API für Ihre Anrufe?
Gehen Sie davon aus, wo der Anruf ankommt und wer für Fehler verantwortlich ist. Vier Fragen bringen Klarheit:
- Kommen die Anrufe aus dem Telefonnetz? Wenn ja, schließen Sie alles aus, was eine Bridge erfordert, die Sie nicht betreiben möchten, oder wählen Sie eine Plattform mit integrierter Telefonie. Unser Leitfaden zu SIP-Trunking und moderner Telefonie behandelt die Carrier-Seite.
- Was passiert, wenn der Agent nicht weiterweiß? Wenn eine Person mit Kontext übernehmen muss, brauchen Sie eine betreute Weiterleitung, nicht nur einen Endpoint zum Auflegen.
- Können Sie die Rechnung vorhersagen? Minutenpreise (GPT-Live-1, Deepgram, AssemblyAI) lassen sich leichter budgetieren als Token-Preise, bei denen lange Anrufe pro Minute mehr kosten.
- Wer behebt einen fehlgeschlagenen Anruf? Wenn Ihr Operations-Team und nicht Ihre Entwickler Prompts und Abläufe optimieren, wählen Sie eine Plattform mit integrierten Tests und Versionierung.
FAQ
Was ist eine Speech-to-Speech-KI-API?
Eine Speech-to-Speech-KI-API nimmt das Audio eines Anrufers entgegen und gibt gesprochenes Audio aus einem einzigen Modell zurück, ohne separaten Transkriptions- und Sprachausgabeschritt. OpenAI gpt-realtime-2.1, GPT-Live-1, Gemini 3.8 Live und Amazon Nova 2.5 Sonic funktionieren auf diese Weise.
Welche Speech-to-Speech-API ist für Telefonanrufe am günstigsten?
Gemini 3.8 Live weist die niedrigsten Audiopreise pro Minute aus: 0,005 $ pro Minute für Audio-Eingabe und 0,018 $ pro Minute für Audio-Ausgabe, von Google aus 3 $ bzw. 12 $ pro 1 Mio. Audio-Tokens umgerechnet. Zu Ihren tatsächlichen Kosten kommen Telefonie, eine eventuell betriebene Bridge und Thinking-Tokens hinzu, die als Ausgabe abgerechnet werden. AWS führt Nova 2.5 Sonic zum gleichen Preis wie Nova 2 Sonic, und OpenAI rechnet die Realtime API pro Token ab – vergleichen Sie daher anhand Ihrer eigenen Anruflänge.
Kann ich die OpenAI Realtime API mit einer Telefonnummer verbinden?
Ja. Richten Sie einen SIP-Trunk eines Carriers wie Twilio auf den SIP-Endpoint von OpenAI aus und nehmen Sie dann jeden Anruf anhand seiner Call-ID an. Weiterleitungen erfolgen per SIP REFER.
Unterstützt die Retell AI Speech-to-Speech-Modelle?
Ja. Die API von Retell listet Speech-to-Speech-Optionen wie die gpt-realtime-Familie von OpenAI und Grok Voice 3.0, und ein Retell-Agent kann stattdessen auch auf einer Standard-Pipeline mit dem LLM Ihrer Wahl laufen. Die Telefonie- und Weiterleitungsfunktionen sind in beiden Fällen dieselben.
Was passiert, wenn der KI-Agent keine Antwort weiß?
Bei einer Modell-API schreiben Sie die Eskalationslogik selbst. Bei Retell kann der Agent eine direkte, betreute oder agentische Anrufweiterleitung an eine Person durchführen, und bei einer betreuten Weiterleitung wird eine kontextbezogene Zusammenfassung übergeben, sodass sich der Anrufer nicht wiederholen muss.
Kann ich meine bestehende Telefonnummer behalten?
Bei Retell ja: Sie können eine bestehende Nummer per SIP-Trunking importieren, statt eine neue zu kaufen. Bei den Modell-APIs hängt es vom SIP-Trunk oder der Bridge ab, die Sie betreiben.
Testen Sie es mit Ihren eigenen Anrufen
Ein Demo-Skript zeigt keine Unterschiede zwischen diesen APIs – Ihre eigenen Anrufe schon. Erstellen Sie kostenlos einen Retell-Agenten, wählen Sie ein Speech-to-Speech- oder Standardmodell und testen Sie ihn mit den Anrufen, die Ihr Team am schwierigsten findet.
Sehen Sie, wie viel Ihr Unternehmen durch den Wechsel zu KI-gestützten Sprachagenten sparen könnte.
ROI-Ergebnis
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Eine Demo-Telefonnummer von Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs

Revolutionieren Sie Ihren Anrufbetrieb mit Retell


