コンタクトセンター向け特化型LLMと汎用LLMの比較





ほとんどのコンタクトセンターにとって、まず汎用LLMから始めるのが安全な選択です。特化型LLMが真価を発揮するのは、ある1つの通話タイプが大量に発生し、汎用モデルが同じ測定可能なかたちで失敗し続ける場合です。たとえば、最初の一言が遅い、ツール呼び出しを誤る、Webページを読み上げたような返答になる、といったケースです。カテゴリーだけで優劣は決まりません。選ぶべきモデルは、自社の通話で何度実行しても合格し、予測可能な1分あたりのコストで運用できるモデルです。
本ガイドは、電話窓口の責任を担うリーダー向けです。本ガイドを公開しているRetell AIは、どちらの立場にも利害関係があります。Retell AIのプラットフォームはOpenAI、Anthropic、Googleの汎用モデルを提供しているほか、独自モデルも開発しています。それが、コンタクトセンターの通話向けに作られたRetell独自のLLM、Tell-1です。Tell-1はRetellの公開ベンチマークであるRetell vCX Benchmarkで総合1位にランクされています(2026年11月13日時点)。ほかのベンダーのベンチマークと同様に扱ってください。つまり、候補に加える理由にはなりますが、その後は自社の通話で検証すべきものです。
コンタクトセンターの通話は言語モデルに何を求めるのか?
コンタクトセンターの通話では、モデルにすべてのターンで5つのことが求められます。長いスクリプトに従うこと、ツールを正しく呼び出すこと、音声で自然に聞こえること、すばやく応答すること、そして大量の通話でもコストを抑えることです。
- 長いスクリプト。エージェントのプロンプトには、その通話タイプの手順、ポリシー、例外が含まれており、モデルはターンごとに適切なルールを適用しなければなりません。Multi-IFベンチマークでは、評価された14モデルすべてで、ターンが増えるごとに守れない指示が増えました。
- ツール呼び出し。予約、照会、転送はツールを介して実行され、誤った呼び出しは実際のレコードを書き換えてしまいます。2024年のtau-bench論文によると、主要な汎用モデルを基盤とする関数呼び出しエージェントは、カスタマーサポートタスクの成功率が50%未満で、小売タスクの8回の繰り返し試行すべてに合格できたのは25%未満でした。
- 自然な話し言葉。返答は読まれるのではなく、聞かれます。画面上では機能する箇条書きや記号も、合成音声では不自然に聞こえます。
- 速度。人は会話のターンの間にわずかな間しか空けません。ターンテイキング研究のレビューでは、一般的な間は約200ミリ秒とされています。モデルは発信者の最後の言葉からエージェントの最初の言葉までの間にある処理段階の1つであり、返答を始めるまでにかかる時間はそのまま沈黙として聞こえます。
- 大量通話時のコスト。ターンのたびに、スクリプトとそれまでの会話がモデルに送り返されます。プロバイダーはこの繰り返しの入力を割引しています(OpenAIのプロンプトキャッシュガイドでは、キャッシュされた入力が最大95%オフとされています)が、コンタクトセンターの通話量では、1分あたりのわずかな差が予算の一項目になります。
コンタクトセンターで汎用LLMが適しているのはどこか?
汎用LLMが最も適しているのは、通話の内容が多様な場合です。つまり、通話タイプが多い、言語が多い、誰もスクリプト化していない質問が来る、といった状況です。汎用LLMは幅広いデータで学習され、複数のプロバイダーが提供しているため、ニーズの変化に応じてモデルを切り替えられます。
また、多くの購入者が想定するほどカスタム作業は必要ありません。OpenAIのモデル最適化ガイドは、評価(evals)とプロンプトエンジニアリングを繰り返すループを説明しており、ファインチューニングは「一部のユースケースで」追加するものとしています。エージェントをスクリプトどおりに動かす要素の多くはプロンプト、コールフロー、ツールにあり、その作業はモデルを変更しても引き継がれます。
限界が表れるのは電話の場面です。回答前に思考する推論モードは、最初の一言までの遅延を増やします。書き言葉のチャット向けに調整されたモデルは、返答を短く話しやすいものに保つためのプロンプト設計が必要です。また、スケジュールを決めるのはプロバイダーです。OpenAIの非推奨化ポリシーでは、一般提供モデルを廃止する少なくとも6か月前に通知するとしており、その後エージェントを後継モデルで検証し直す必要があります。モデルごとの比較は、音声AIエージェントにはどのLLMを使うべきかをご覧ください。
特化型LLMやファインチューニング済みLLMで何が変わるのか?
特化型LLMは、振る舞いをプロンプトからモデルの学習へと移します。汎用モデルに対して簡潔に話す、ポリシーに従う、適切なタイミングでツールを呼び出すよう指示する代わりに、ベンダーはまさにそうした振る舞いの例でモデルを学習させます。多くの場合、より小さなモデルが使われます。混同されやすい用語が3つあります。
- ドメイン特化型LLM(バーティカルLLM)は、ベンダーが特定の業界や業務向けに学習・調整し、すべての顧客に提供するモデルです。
- ファインチューニング済みモデルは、ベースモデルを、より限定されたデータセット(多くの場合は自社のデータ)でさらに学習させたものです。仕組みについては、用語集のAIモデルのファインチューニングをご覧ください。
- カスタムLLMは通常、調整の有無にかかわらず、自分でプラットフォームに持ち込むあらゆるモデルを指します。
OpenAIのLLMの精度に関するガイドでは、ファインチューニングを行う理由を2つ挙げています。特定タスクでの精度向上と、効率の向上、つまりより少ないトークンや、より小さなモデルで同じ精度を実現することです。通話においては、より安定したスクリプト遵守、より短いプロンプト、1分あたりのコスト削減につながる可能性があります。
この考え方は新しいものではありません。Observe.AIは2023年6月にContact Center LLMを発表しており、数億件の顧客対応からなるドメイン特化型データセットで学習した300億パラメータのモデルだと説明しています。この発表における精度向上は、ベンダー自身による初期ベンチマークに基づくものです。これはこのカテゴリーでは一般的なことであり、だからこそ、どんな発表よりも自社での評価が重要なのです。
両者のトレードオフとは?
トレードオフはロックイン、カバー範囲、評価負担の3つで、いずれも両方向に作用します。
| 項目 | 汎用LLM | 特化型またはファインチューニング済みLLM |
|---|---|---|
| 最適な用途 | 多様な通話タイプ、多言語、スクリプト外の質問 | ルールが安定した、大量に発生する単一の通話タイプ |
| スクリプトとツールの挙動 | プロンプトとコールフローで設定 | 学習で組み込まれるため、必要なプロンプトが少ない |
| 速度と1分あたりのコスト | モデルサイズと推論モードに依存 | モデルが小さければ低く抑えられる |
| ロックイン | 複数のプロバイダーがあり、それぞれ独自のスケジュールでモデルを廃止 | 多くの場合、単一ベンダーまたは単一プラットフォーム |
| カバー範囲 | 広い | 学習データの範囲外では狭い |
| 得られるエビデンス | 公開ベンチマーク(電話通話を対象とするものは少ない) | 多くの場合、ベンダー独自のベンチマーク |
| 評価負担 | モデルが廃止されるたびに再検証 | 導入前と再学習のたびに検証 |
ロックイン。特化型モデルは単一のベンダーから、場合によっては単一のプラットフォーム内でのみ提供されることが少なくありません。エージェントを作り直さずにモデルを切り替えられるか、プロンプト、フロー、テストケースが自社の資産として残るかを確認しましょう。汎用モデルにも、プロバイダーがバージョンを廃止する際に、目立たないかたちで同じリスクがあります。
カバー範囲。英語の予約通話で学習したモデルは、スペイン語や、学習時に見たことのない請求トラブルには弱い可能性があります。平均値ではなく、言語別・通話タイプ別の結果を求めましょう。
評価負担。公開ベンチマークで電話通話が測定されることはまれで、ベンダーのベンチマークは販売者が選んだエビデンスです。自社でモデルをファインチューニングする場合、負担はさらに大きくなります。OpenAIの精度ガイドは、学習データの例は「モデルが現実世界で目にするものを正確に表していなければならない」とし、過学習を検出するためのホールドアウトセットを推奨しています。
自社の通話でどちらのモデルも評価するには?
どちらも同じ方法で評価します。自社の通話から作成した固定シナリオを、明文化した合格基準で採点し、複数回実行したうえで、ライブトラフィックを分割します。
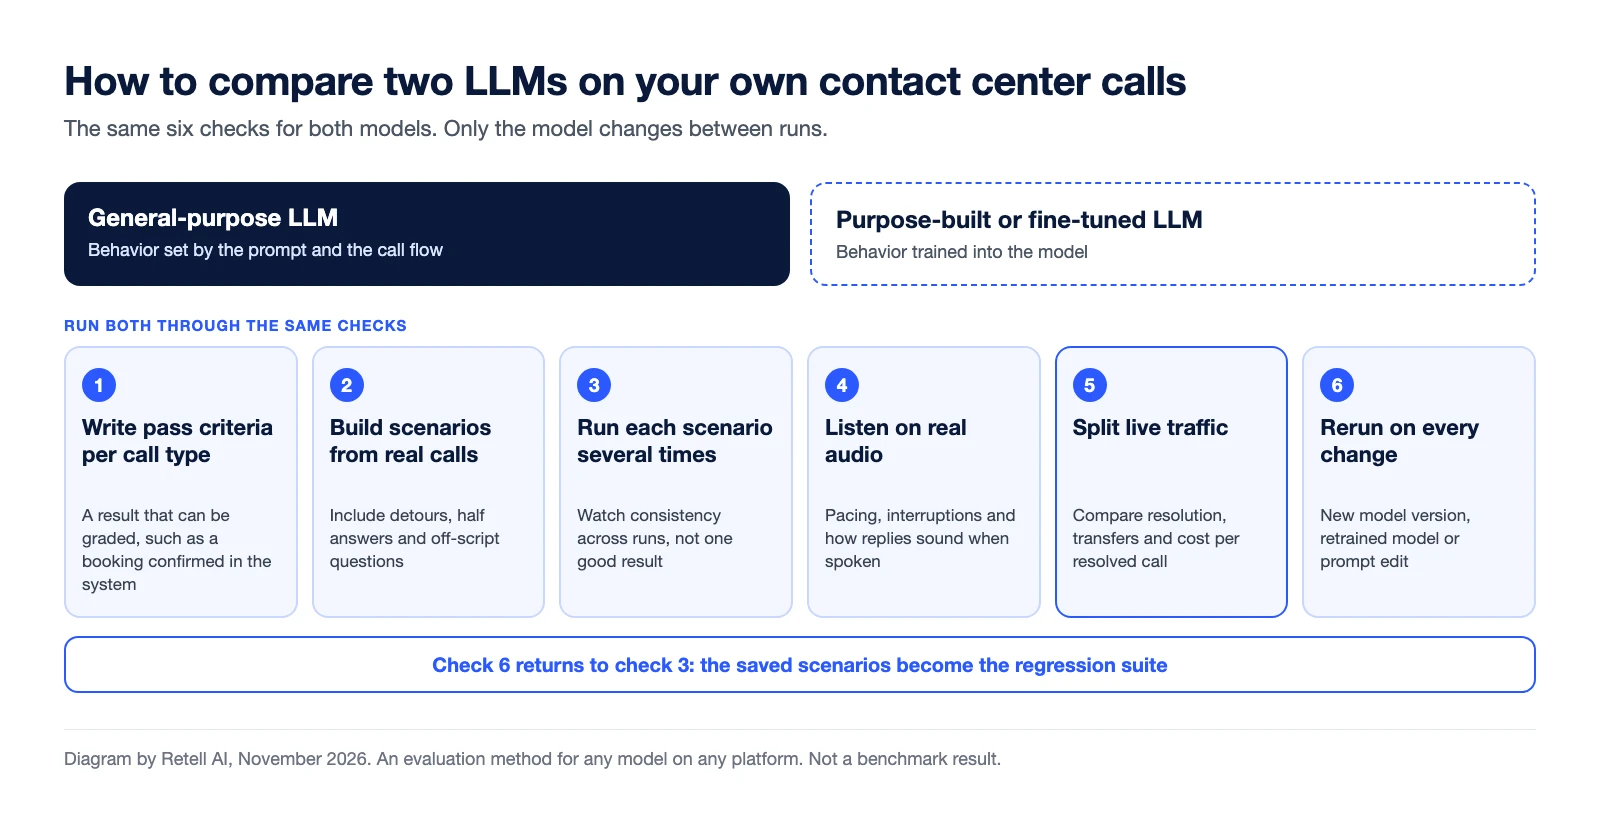
- 通話タイプごとに合格基準を書く。「予約システムに予約が登録され、発信者に確認が伝えられた」は採点できます。「良い感じだった」は採点できません。
- 実際の通話からシナリオを作成する。話の脱線も含めましょう。途中で気が変わる発信者、スクリプト外の質問をする発信者、不完全な回答をする発信者などです。
- 各モデルで、すべてのシナリオを複数回実行する。tau-benchの著者らは、繰り返し試行における信頼性を測るpass^k指標を提案しています。
- 実際の音声で聴く。テキストの結果では、話すテンポ、割り込み、返答が音声でどう聞こえるかを見落とします。
- ライブトラフィックを分割する。通話の一部をそれぞれの選択肢に振り分け、解決率、転送、解決1件あたりのコストを比較します。
- 変更のたびに再実行する。新しいモデルバージョン、再学習したモデル、プロンプトの編集のいずれでも、同じテストスイートが必要です。
Retellでは、シミュレーションテストが成功基準に照らして各実行を合格・不合格で採点し、バッチテストが保存済みのケースを回帰テストスイートとして再実行し、A/Bテストがエージェント間で通話トラフィックを割合に応じて分割します。ドキュメントによれば、プロンプトを書き直さずに後からモデルを切り替えることができます。独自のモデルを持ち込む場合、シミュレーションテストとバッチテストは適用されず、Web通話と電話で検証することになります。より広範なパイロットについては、本番稼働前にAI音声エージェントプラットフォームを評価する方法をご覧ください。
この比較においてTell-1はどこに位置するのか?
Retell独自のLLMであるTell-1は、コンタクトセンターの通話向けの特化型モデルです。そのため、本ガイドで取り上げたトレードオフはすべてTell-1にも当てはまります。以下に、各項目における位置づけを、すべての数値の出典とともに示します。
- スクリプト、ツール、話し言葉。Retell vCX Benchmarkにおいて、Tell-1の平均スコアは94.45で、総合1位です。スイート別では、指示遵守88.6%(2位)、グラウンディング97.2%(2位)、ツール呼び出し95.4%(5位)、口語的な話し言葉96.6%(1位)で、いずれも2026年11月13日時点の数値です。このベンチマークはRetellが運営しているため、本ガイドが勧めるとおり、候補に加える理由として活用してください。
- 速度。レイテンシの中央値はボード上で最も低い76 msです(2026年11月13日時点)。これはベンチマーク上のモデル単体の数値であり、通話全体のエンドツーエンドの応答時間ではありません。
- コスト。ベンチマークでは1分あたり3.5セントと記載されています。これはLLM部分のみの費用で、通話料金ではありません。また、ボード上の一部の汎用構成のほうが安価です。Retellの料金は1分あたり$0.07からです。
- 仕組み。モデルは返答を開始し、最初の言葉が再生されている間も推論を続けます。技術記事Retell LLM: Interleaved Reasoning for Real-Time Voice Agentsでは、返答の途中で平均約200の推論トークンが生成されると報告し、その背景にある3段階の学習プロセスを説明しています。
- ロックイン。Tell-1はRetell内で提供されます。OpenAI、Anthropic、Googleのモデルと同じモデルセレクターに並んでおり、Retellのドキュメントによればプロンプトを書き直さずに後からモデルを切り替えることができるため、Tell-1を選んでもほかの選択肢が閉ざされることはありません。
- カバー範囲。通話向けに作られたモデルは、設計上カバー範囲が狭くなります。Tell-1に頼る前に自社の言語と通話タイプで実行し、Tell-1が2番手となる通話タイプには汎用モデルを使い続けましょう。
- 評価。上記の6つのチェックはそのまま適用されます。Tell-1はRetellが管理するモデルのため、シミュレーションテストとバッチテストが使え、A/B分割では、モデルだけが異なる2つのエージェントのコピーに同じトラフィックを送ることができます。
公平にまとめると、Retellを利用しているなら、Tell-1は候補に加えるべき特化型の選択肢であり、その隣にある汎用モデルが比較対照(コントロール)となります。製品の詳細はTell-1をご覧ください。
よくある質問
特化型LLMとは何ですか?
特化型LLMとは、汎用的な用途ではなく、コンタクトセンターの通話対応など1つの業務向けに学習・調整された言語モデルです。ドメイン特化型LLMやバーティカルLLMとも呼ばれます。汎用の大規模言語モデルは、プロンプトとツールによって業務に適応させます。
特化型LLMは汎用LLMよりも精度が高いのですか?
学習対象の業務では、そうなる場合があります。それ以外では、多くの場合そうではありません。公開されている比較の多くはモデルを開発したベンダーによるものなので、自社のシナリオで両方を実行してください。
コンタクトセンターは独自のLLMを学習させる必要がありますか?
通常は必要ありません。OpenAIの最適化ガイドは評価とプロンプトエンジニアリングから始め、ファインチューニングは一部のユースケースでのみ追加するとしています。独自に学習させる場合、学習データとホールドアウトセットも自社で管理することになります。
カスタムLLMとファインチューニング済みモデルは同じものですか?
必ずしも同じではありません。ほとんどの音声プラットフォームでは、カスタムLLMとは自分でホストして接続するあらゆるモデルを指し、ファインチューニングされている場合もそうでない場合もあります。RetellのカスタムLLMオプションでは、WebSocket経由で独自のモデルを接続し、テレフォニー、文字起こし、ターンテイキングはRetellが処理します。
コンタクトセンターで複数のLLMを使うことはできますか?
はい。Retellでは各エージェントが独自のモデル設定を持ち、LLM設定のドキュメントでは、プライマリモデルと並行してバックアップモデルを実行する高速fallbackについて説明しています。
Tell-1は特化型LLMですか?
はい。Tell-1は、コンタクトセンターの通話向けに構築されたRetell独自のLLMです。Retell vCX Benchmarkでは平均94.45で総合1位にランクされています(2026年11月13日時点)。Retellのモデルセレクターでは、OpenAI、Anthropic、Googleの汎用モデルと並ぶ選択肢の1つとして提供されています。
導入を決める前に、自社の通話でモデルを比較する
Retellは、コンタクトセンター向けのAI音声エージェントプラットフォームです。各エージェントにはモデルセレクターがあり、料金ページではOpenAI、Anthropic、Googleのモデルに加え、自社でホストするモデル用のカスタムオプションが掲載されています。Retell独自のLLMであるTell-1も同じセレクターにあります。顧客に最も近いメンバーが、自らモデルを変更し、テストスイートを再実行し、トラフィックを分割できます。マネージド型のAIベンダーと取引する場合とは異なり、その変更がチケットや順番待ち、追加のSOWになることはありません。料金は従量課金で、料金ページに記載のとおり1分あたり$0.07からです。1つの通話タイプと自社の合格基準を用意し、契約前に実際の通話でパイロットを実施しましょう。
AI搭載の音声エージェントに切り替えることで、あなたのビジネスがどれだけ節約できるかをご確認ください。
ROI結果
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost


Retellで、電話業務に革命を


