音声エージェントのためのAIエージェントベンチマーク解説





AIエージェントのベンチマークとは、採点ルールを伴う固定のタスク群であり、同じ作業でモデルを比較するために使われます。AI音声エージェントについて知っておくべきベンチマークは4つあります。ポリシーに従ったツール使用を測るτ²-bench(tau2-bench)、複数ターンにわたる指示追従を測るMulti-IF、高度な推論を測るGPQA Diamond、そしてコンタクトセンターの通話を対象とするRetell vCX Benchmarkです。いずれも、電話の通話で起きることの一部分だけを測定しています。
本ガイドでは、各ベンチマークが何をテストし、どのように採点され、そのスコアから何がわからないのかを解説します。Retell AI は本ガイドを公開しているだけでなく、4つのベンチマークのうちの1つであるvCX Benchmarkも公開しています。スコアはモデルがリリースされるたびに変わるため、各セクションには最新の結果を掲載している情報源へのリンクを記載しています。
AIエージェントのベンチマークとは?
AIエージェントのベンチマークでは、すべてのモデルに同じタスクと同じ採点者を与え、モデルがタスクを正しくこなせた頻度を報告します。スコアの意味は、タスクの内容、会話の相手側を誰(または何)が担うか、そして合格がどのように判定されるかによって変わります。
採点方法には3種類あります。状態チェックは、エージェントの操作結果を既知の正しい結果(返金処理後のデータベースなど)と比較します。ルールチェックは、応答に対してスクリプトを実行します。ジャッジモデルは、評価基準(ルーブリック)に照らして応答を採点します。状態チェックとルールチェックは再現性がある一方で、対象範囲が限られます。ジャッジモデルはトーンや意味を採点できますが、独自の死角を抱えています。
4つのベンチマークは何を測定するのか?比較一覧
4つのベンチマークはそれぞれ異なるスキルを対象としており、電話の通話から構築されているのはvCX Benchmarkだけです。以下の表は、2026年11月13日時点で各ベンチマークの論文、リポジトリ、またはリーダーボードを参照してまとめたものです。
| ベンチマーク | 公開元 | タスクの内容 | 採点方法 | 音声エージェント導入者にとって抜け落ちている点 |
|---|---|---|---|---|
| τ²-bench(航空・小売) | Sierra | ツールを使い、文書化されたポリシーに従いながら、テキスト会話でシミュレートされた顧客に対応する | 会話ごとに0または1:最終的なデータベースが目標と一致し、かつ必要な情報が伝えられている必要がある | 音声、応答時間、自社のポリシーとツール |
| Multi-IF | Meta | 検証可能な文章作成の指示に、8言語・3ターンにわたって従う | 4つの正確度指標の平均(指示単位と会話単位、それぞれstrictとloose) | ツール、長いスクリプト、音声での発話 |
| GPQA Diamond | NYU、Cohere、Anthropicの研究者 | 専門家が作成した198問の多肢選択式の科学問題に解答する | 正答率(偶然による正答率は25%) | 会話、ツール、指示、速度 |
| Retell vCX Benchmark | Retell AI | 4つのスイートにわたり、コンタクトセンターの通話のターンを処理する | スイートごとの合格率を平均して1つのスコアにする | 音声、自社の通話タイプ、通話全体での結果 |
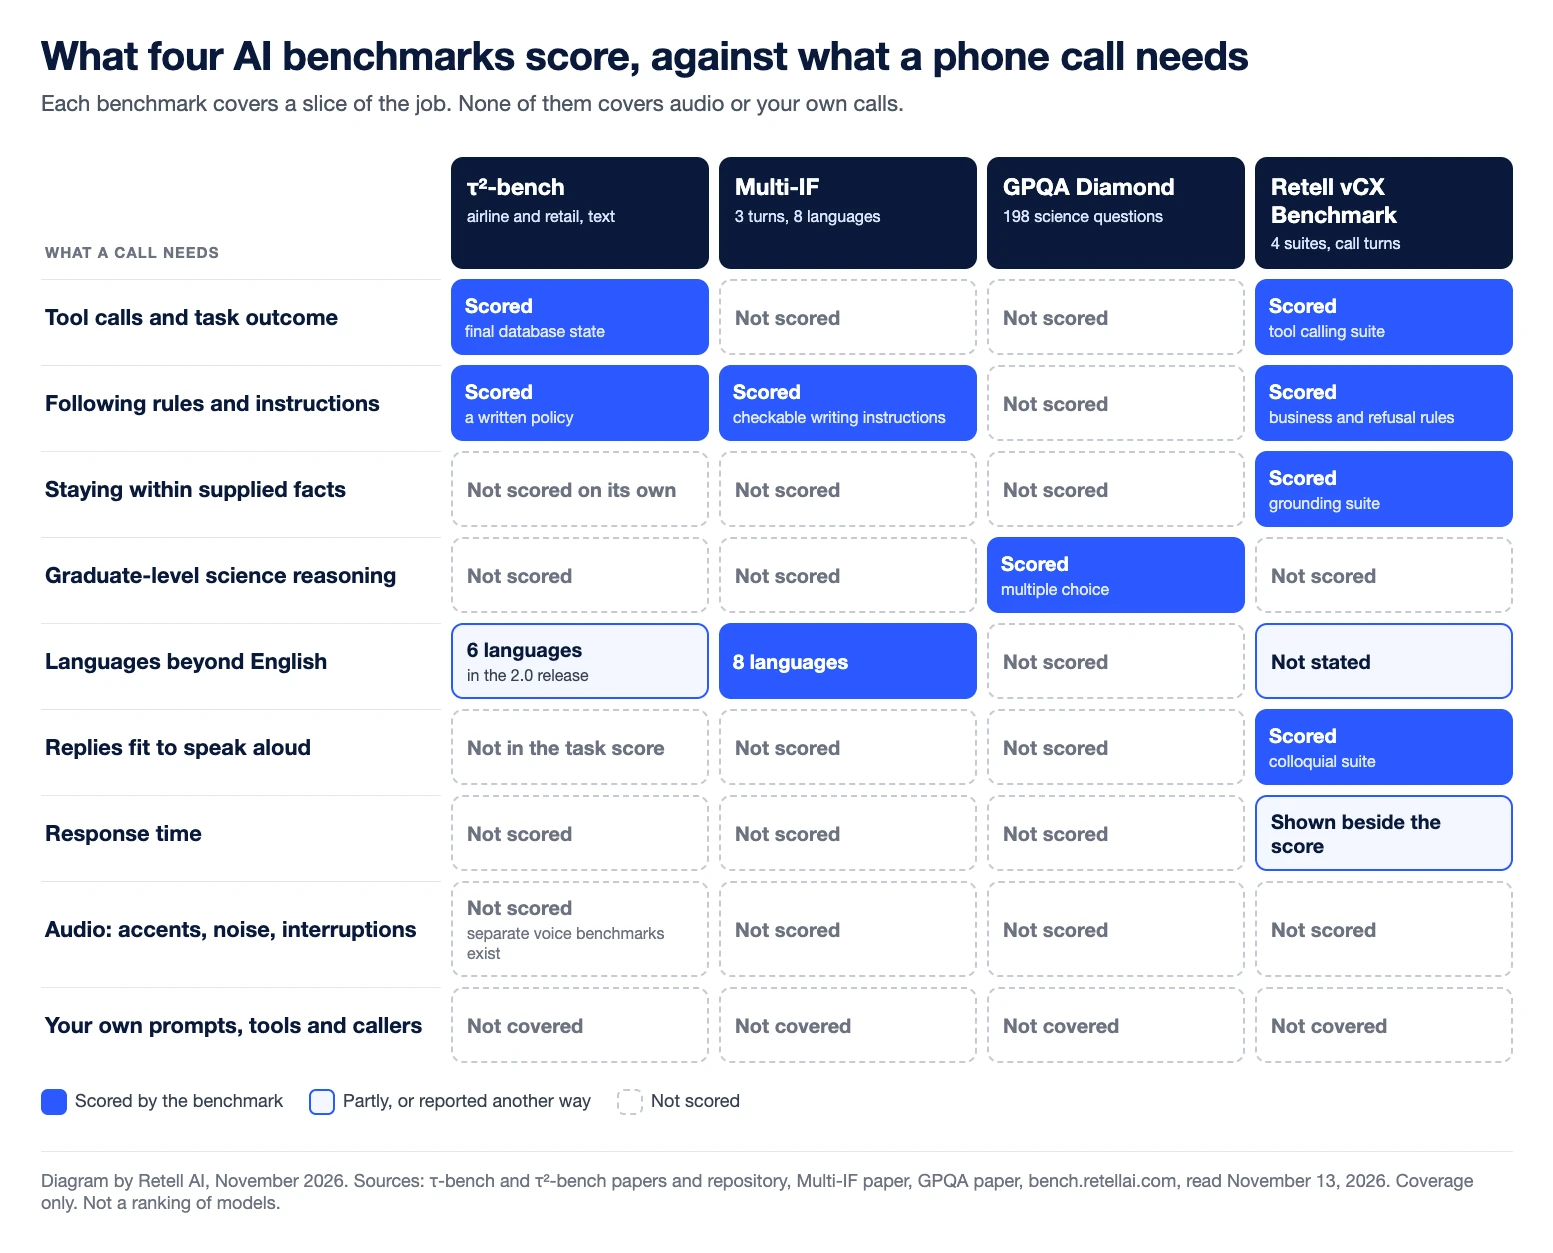
τ²-benchは航空・小売ドメインで何を測定するのか?
τ²-benchは、エージェントが文書化されたポリシーに従い、適切なツールを呼び出しながら、会話を通じてカスタマーサービスのタスクを完了できるかを測定します。言語モデルが顧客役を担い、エージェントは注文や予約の模擬データベースを操作します。オリジナルのτ-bench論文では、小売タスク115件と航空タスク50件で2つのドメインが構築されました。τ²-bench論文は両ドメインの検証済みバージョンを再利用し、通信(テレコム)ドメインを追加しています。
採点は厳格です。リポジトリの評価に関する注記によると、各タスクの報酬は各チェック結果の積です。デフォルトでは、最終的なデータベースを目標状態と比較するデータベースチェックと、エージェントが顧客に必要な情報を伝えたことを確認するコミュニケーションチェックの2つです。正しい最終状態に到達するツール呼び出しであれば、その順序を問わず合格となります。
重要な指標は2つあります。Pass^1は、1回の試行で解決できたタスクの割合です。Pass^kは、k回の繰り返し試行のすべてで解決できたタスクの割合で、一貫性を捉えるためにオリジナルの論文で導入された指標です。2024年のこの論文では、当時の主要な関数呼び出しエージェントでさえ成功したタスクは半分未満で、小売ではpass^8が25%未満だったと報告されています。
音声エージェント導入者にとってわからないこと:航空・小売のテキストスコアは、音声も割り込みも時間制限もない、タイピングによる会話から得られたものです。ポリシーとツールはベンチマーク独自のものです。シミュレートされた顧客もモデルであり、τ²-benchの著者らはシミュレーターのエラー率を小売で40%、航空で47%と測定しています。そのうちタスクの遂行を妨げるほど深刻なものは、それぞれ12%と13%でした。同じリポジトリでは現在、別途音声ベンチマークも提供されており、2.0リリースでは6言語が追加され、そのスコアは1.xのリーダーボードとは比較できないとされています。引用されているスコアがどのバージョンのものかを確認してください。
Multi-IFは何を測定するのか?
Multi-IFは、会話が進んでもモデルが指示に従い続けられるか、そしてそれが英語以外でも維持されるかを測定します。MetaのMulti-IF論文は、以前のシングルターンのテストであるIFEvalを拡張し、英語、フランス語、ロシア語、ヒンディー語、イタリア語、ポルトガル語、スペイン語、中国語の8言語で、各3ターンの会話4,501件を構成しています。
指示は、カンマの使用禁止や大文字での回答ルールなど、検証可能な形で記述されています。代表スコアは4つの正確度指標の平均です。指示単位の正確度は、各指示を個別にカウントします。会話単位の正確度は、そのターンまでのすべての指示が守られた場合にのみ会話をカウントします。それぞれ、strict(厳格)とloose(緩和)の2つの基準で報告されます。
この論文の主な発見こそが、このベンチマークが電話エージェントにとって重要な理由です。テストされた14モデルすべてで、ターンが増えるごとに失敗が増えました。あるモデルは、1ターン目の0.877から3ターン目には0.707に低下しました。通話の冒頭ではルールに従っていたのに、数回のやり取りの後にそれを守らなくなるエージェントも、同じ形で失敗しているのです。
音声エージェント導入者にとってわからないこと:指示は、長さ、句読点、キーワードなど、テキストに対する書式や文章作成上の制約であり、ビジネスルールではありません。ツールはなく、3ターンは実際の通話と比べて短く、音声で発話されるものもありません。
GPQA Diamondは何を測定するのか?
GPQA Diamondは、Web検索では解けない非常に難しい科学の問題にモデルが答えられるかを測定します。GPQA論文では、生物学、物理学、化学の448問の多肢選択式問題について説明しており、これらは博士号を持つ、または取得を目指している人々によって作成・検証されました。Diamondは、専門家の検証者2名がともに正解し、非専門家の大半が不正解だった198問のサブセットです。
採点は単純な正答率です。各問題には4つの選択肢があるため、ランダムに推測した場合のスコアは25%になります。全問題セットでは、専門家の正答率は65%、Webへの無制限アクセスが可能な熟練した非専門家の正答率は34%でした。
音声エージェント導入者にとってわからないこと:通話に関するほぼすべてです。会話も、従うべき指示も、ツールも、時間制限もありません。これは推論の深さを示す代替指標です。また、198問という規模では、モデル間のわずかな差は弱い根拠にしかならず、著者らもデータセットの規模の小ささを限界として挙げています。
Retell vCX Benchmarkは何を測定するのか?
Retell vCX Benchmarkは、4つのスイートにわたり、モデルがコンタクトセンターの通話のターンをどのように処理するかを測定します。2026年11月13日時点のライブリーダーボードでは、各スイートを次のように説明しています。
- 指示追従:モデルが役割の制約、ビジネスルール、拒否ルールを守るかどうか。
- グラウンディング:回答がプロンプト、ツール、取得したコンテキストの範囲内にとどまるかどうか。
- ツール呼び出し:モデルが適切なアクションを選択し、有効な引数を渡すかどうか。
- 口語性:応答が自然かつ簡潔で、読み上げても問題ないかどうか。
各スイートは約1,000件以上のケースに対する合格率を報告し、総合スコアは4つの平均です。同日時点でリーダーボードには45モデルにわたる62件のエントリーが掲載されており、各スコアの横にはレイテンシの中央値と1分あたりのコストが表示されています。
公開されている手法の解説はvCX-Hardの記事で、最初の2つのテストセットであるグラウンディングとツール呼び出しを扱っています。ケースは本番環境の通話から抽出され、特定の顧客に偏らないよう複数の組織にわたってサンプリングされています。複数のジャッジモデルからなるパネルが、ルーブリックと参照解答に照らして各ケースを採点します。この記事では、正確な数値よりも順位をシグナルとして扱っています。
音声エージェント導入者にとってわからないこと:これはベンダーによるベンチマークであり、そのベンダー自身もエントリーしています。Retell独自のモデルであるTell-1は、Retell vCX Benchmarkで総合1位にランクされています(2026年11月時点)。ケースはRetellのトラフィックから取得されているため、自社の通話タイプが少ない、あるいは含まれていない可能性があります。4つのスイートは応答とツール呼び出しを採点するため、音声認識のエラー、割り込み、通話全体が解決して終わるかどうかは対象外です。また、ジャッジモデルが誤る可能性もあります。
Tell-1はこの4つのベンチマークでどのようなスコアを出しているか?
Retell独自のLLMであるTell-1は、4つのベンチマークを組み合わせて読み解く一例です。以下の公開ベンチマークのスコアは、RetellがRetell LLMに関する技術記事で報告しているもので、vCXの数値は2026年11月13日時点のライブリーダーボードによるものです。
| ベンチマーク | Tell-1のスコア | 実行規模 | 実施者 |
|---|---|---|---|
| τ²-bench 航空 | 72.0 | 50タスク | Retell |
| τ²-bench 小売 | 78.0 | 50タスク | Retell |
| Multi-IF | 82.1 | 504会話 | Retell |
| GPQA Diamond | 83.5 | 198問 × 3 | Retell |
| Retell vCX Benchmark | 平均94.45、62のモデル構成中で総合1位 | 4スイート、各約1,000ケース | Retell |
これらの数値は、上記のセクションで示した観点で読み解いてください。すべての行はRetell自身による実行結果で、毎回同じグリーディデコーディングを用いて100点満点で採点されており、Retellはいずれのベンチマークもトレーニングには使用していないとしています。Multi-IFの実行はベンチマーク全体の4,501会話のうち504会話を、τ²-benchの実行は各ドメイン50タスクを対象としているため、オリジナルの論文や他のリーダーボードの数値とは直接比較できません。
vCXではスイートごとにスコアが異なります。口語性が96.6%(1位)、グラウンディングが97.2%(2位)、指示追従が88.6%(2位)、ツール呼び出しが95.4%(5位)です。4つのスイートのうち3つでは、他のモデルが首位に立っています。どのモデルにも言えることですが、これらの数値はTell-1を候補リストに加える根拠となるものであり、最終的な判断は自社の通話での試用で行います。
AI音声エージェントの導入者にとって、ベンチマークのスコアから抜け落ちているものとは?
ベンチマークのスコアには、モデルを取り巻くプラットフォームと、自社の通話の条件が含まれていません。電話の通話では、音声認識、ターンテイキング、音声合成、テレフォニー、そしてあらゆる段階でのレイテンシが加わります。ここで説明した形式では、4つのベンチマークのいずれもこれらを採点していません。
エージェントが同一であっても、プラットフォームによって結果が異なる場合があります。テストベンダーであるCekuraの調査では、1つのエージェントを変更せずに6つの音声プラットフォームにデプロイしたところ、ワークフローのスコアは65.2%から95.7%まで幅がありました。RetellのMedicare調査のまとめでは、その手法と、調査に関する開示事項を紹介しています。
ベンチマークのスコアはどのように活用すべきか?
ベンチマークのスコアは候補リストの作成に使い、最終判断は自社の通話で行いましょう。推奨される手順は次のとおりです。
- リスクに合ったベンチマークを選ぶ:誤ったアクションが大きな損失につながるならツール使用の結果を、エージェントが長いスクリプトを守る必要があるなら指示追従を重視します。
- バージョン、日付、テストの実施者を確認する。
- 報告されている場合は、pass^kのような繰り返し試行の数値を優先する。
- 自社のシナリオでテストを再構築し、繰り返し実行がすべて合格した場合にのみ、そのシナリオを合格とみなす。
Retellでは、シミュレーションテストによってAIが通話相手を演じ、成功基準に基づいて各実行を合格・不合格で評価します。また、バッチテストにより、プロンプトを変更するたびに保存済みのケースを再実行できます。リリース後は、AI QAが実際の通話のサンプルをハルシネーションやツールの使用状況などの指標で採点し、A/Bテストによってライブトラフィックを2つのエージェントに振り分けられます。モデルの選び方については、音声AIエージェントにどのLLMを使うべきかをご覧ください。導入プロセスについては、AI音声エージェントプラットフォームの評価方法をご覧ください。
ベンチマークは、どのモデルを試す価値があるかを教えてくれます。実際の通話でのパイロットは、どのモデルを運用すべきかを教えてくれます。Retellはコンタクトセンター向けのAI音声エージェントプラットフォームで、料金は1分あたり$0.07からです。契約前に、自社の通話で効果を検証できます。
よくある質問
pass^1とpass^kの違いは何ですか?
Pass^1は、エージェントが1回の試行で解決できるタスクの割合です。Pass^kは、同じタスクに対するk回の繰り返し試行のすべてで解決できるタスクの割合です。Pass^kは常にpass^1以下であり、その差はエージェントの一貫性を示します。
τ-benchとτ²-benchは同じものですか?
いいえ。τ-benchは、航空・小売ドメインを備えた2024年のオリジナルのベンチマークです。τ²-benchは同じグループによる2025年の後継版で、これら2つのドメインの検証済みバージョンを維持しつつ、シミュレートされた顧客もツールを使用する通信ドメインを追加しています。
なぜGPQA Diamondのような科学テストが、顧客との会話向けのモデル比較に使われるのですか?
GPQA Diamondは、推論能力の一般的な指標として使われています。会話、ツール、音声については直接何も示しません。推論の深さを確認するものとして捉え、それ以外はタスク型のベンチマークで判断しましょう。
AI音声エージェントにとって最も重要なベンチマークはどれですか?
単独で十分なものはありません。ポリシーに従ったツール使用、ターンをまたいだ指示追従、グラウンディングがコンタクトセンター業務に最も近いため、τ²-bench、Multi-IF、vCX Benchmarkが最も適しています。ただし、自社の通話シナリオで採点したテストは、そのいずれよりも重要です。
Tell-1のτ²-bench、Multi-IF、GPQA Diamondのスコアは?
Retellは、Tell-1のスコアとしてτ²-bench航空で72.0、τ²-bench小売で78.0、Multi-IFで82.1、GPQA Diamondで83.5を報告しています(いずれも100点満点)。これらはRetell自身による実行結果で、τ²-benchは各ドメイン50タスク、Multi-IFは504会話、GPQA Diamondは198問を対象としています。
AI搭載の音声エージェントに切り替えることで、あなたのビジネスがどれだけ節約できるかをご確認ください。
ROI結果
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost


Retellで、電話業務に革命を


