الاستدلال المتداخل طريقة لتشغيل نموذج استدلال يتناوب فيها النموذج بين الاستدلال الخاص والإجراءات المرئية، مثل استدعاءات الأدوات أو أجزاء من إجابته، بدلًا من إنهاء استدلاله كاملًا قبل أن يردّ.
يُسمّى أيضًا التفكير المتداخل. تستخدم وثائق المزوّدين هذا المصطلح غالبًا للاستدلال بين استدعاءات الأدوات، بينما تستخدمه الأوراق البحثية لنموذج يتناوب بين التفكير وأجزاء من إجابته. ويصف الاستخدامان التغيير نفسه: لم يعد الاستدلال كتلة واحدة في بداية الدور.
ما نموذج الاستدلال؟
نموذج الاستدلال هو نموذج لغوي كبير يولّد استدلالًا وسيطًا قبل إجابته. يلخّص دليل الاستدلال من OpenAI ذلك في سطر واحد: «تستخدم نماذج الاستدلال tokens استدلال داخلية قبل إنتاج الرد». وتذكر وثائق Gemini من Google أن نموذج التفكير «يستدل داخليًا قبل الرد»، بينما تذكر وثائق DeepSeek أن وضع التفكير لديها ينتج استدلالًا بسلسلة الأفكار «لتحسين دقة الرد النهائي».
ما tokens الاستدلال؟
tokens الاستدلال، وتُسمّى أيضًا tokens التفكير، هي tokens يولّدها النموذج أثناء معالجته لمشكلة ما، وهي ليست جزءًا من الإجابة. وتهمّ فيها ثلاث خصائص:
- تُحتسب في الفوترة. تقول OpenAI إن tokens الاستدلال «تُفوتَر بوصفها tokens إخراج». وتقول وثائق التفكير من Anthropic الأمر نفسه عن Claude، «حتى عندما لا يُعاد إليك نص التفكير». وتسعّر Google الرد على أنه «مجموع tokens الإخراج وtokens التفكير».
- غالبًا ما تكون مخفية. tokens الاستدلال لدى OpenAI «غير مرئية عبر API». وتقول Anthropic إن ما تراه «ليس أبدًا سلسلة الأفكار الخام». ويمكن لكليهما إعادة ملخّص إذا طلبته.
- تستهلك وقتًا ومساحة. تقول OpenAI إن النموذج قد يولّد «ما بين بضع مئات وعشرات الآلاف من tokens الاستدلال» في طلب واحد، وهي تشغل نافذة السياق.
يتحكّم المطوّرون في الكمية عبر إعداد: reasoning effort لدى OpenAI، وeffort لدى Anthropic، وthinking level لدى Google.
ما الفرق بين الاستدلال المتداخل والاستدلال المسبق؟
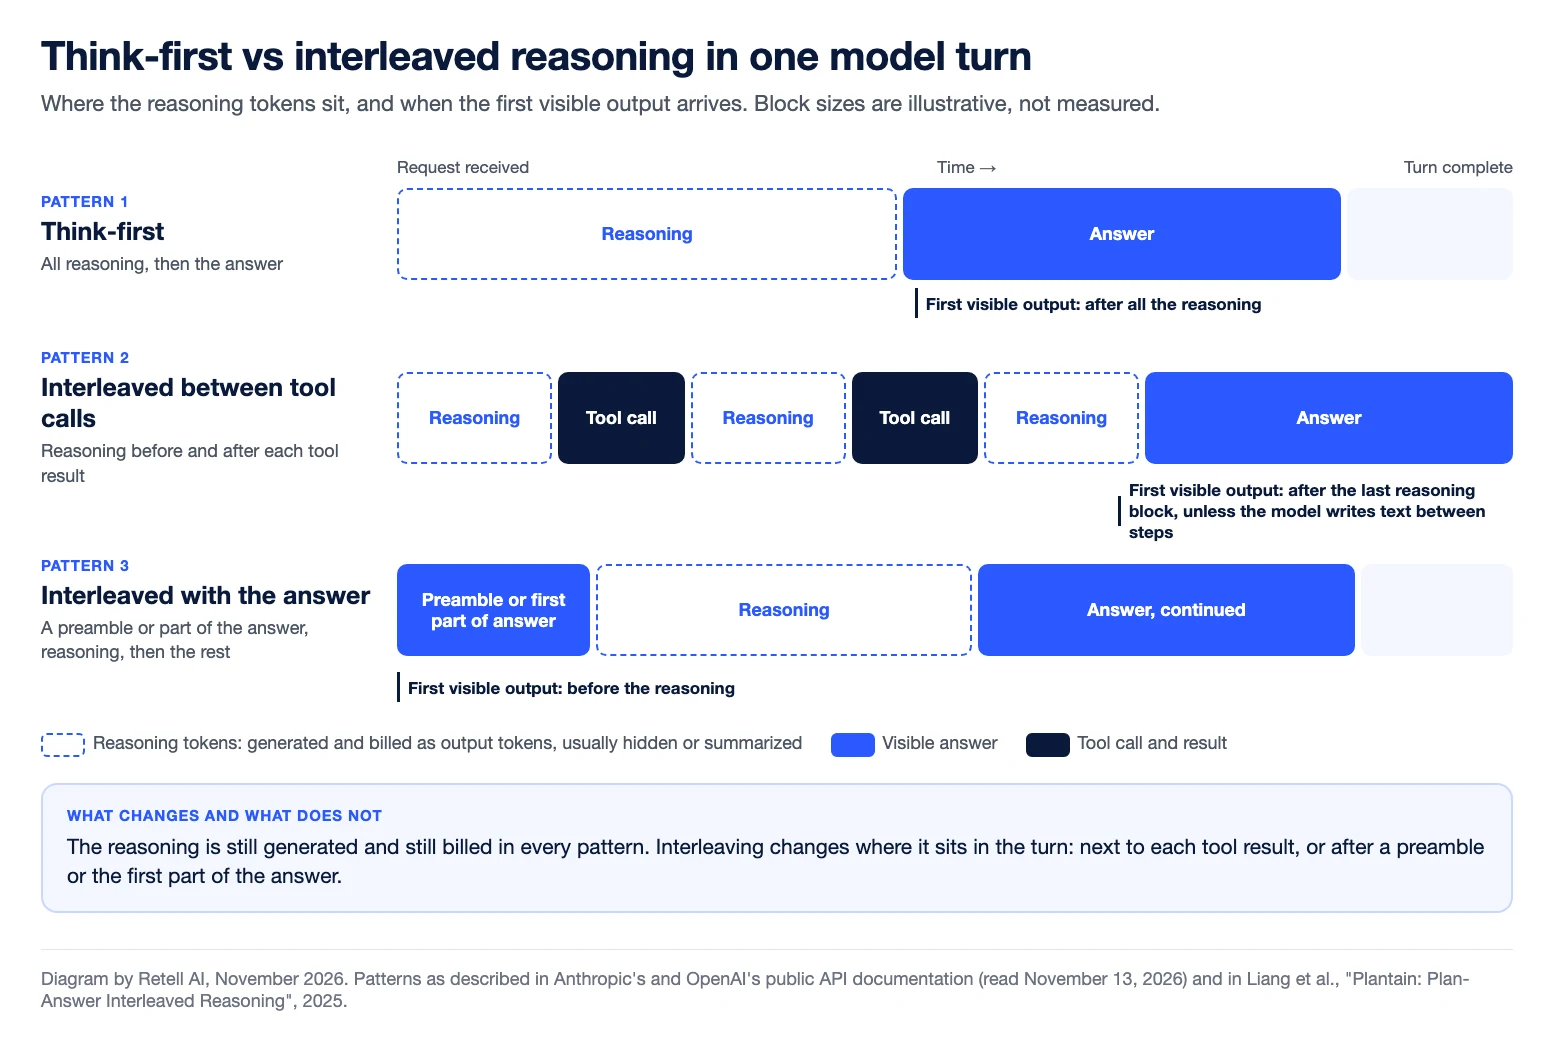
في الاستدلال المسبق، يحدث الاستدلال كله قبل أول token مرئي. تسمّي Anthropic ذلك التفكير المسبق: إذ «تصل كتل التفكير قبل كتل النص». أما الاستدلال المتداخل فيقسّم الاستدلال إلى كتل أصغر ويضعها حيث تكون الحاجة إليها.
| النمط | ترتيب العمل في دور واحد | أول ما يراه المستخدم | موصوف علنًا لدى |
|---|---|---|---|
| بلا استدلال | الإجابة | بداية الإجابة | أي نموذج مع إيقاف الاستدلال |
| الاستدلال المسبق | الاستدلال كله، ثم الإجابة | لا شيء حتى ينتهي الاستدلال | Anthropic (التفكير المسبق)، DeepSeek |
| متداخل بين استدعاءات الأدوات | الاستدلال، ثم استدعاء أداة، ثم قراءة النتيجة، ثم الاستدلال مجددًا، ثم الإجابة | لا شيء حتى تنتهي آخر كتلة استدلال، ما لم يكتب النموذج نصًا بين الخطوات | Anthropic، OpenAI، vLLM، DeepSeek (دون استخدام المصطلح) |
| متداخل مع الإجابة | مقدّمة أو جزء من الإجابة، ثم الاستدلال، ثم المزيد من الإجابة | مقدّمة أو جزء مبكر من الإجابة | OpenAI، الأوراق البحثية |
| متداخل مع الكلام | الجملة الأولى من الرد، ثم استدلال صامت أثناء تشغيلها، ثم بقية الرد | الجملة الأولى من الرد | Tell-1، نموذج LLM الخاص بـ Retell |
ما الذي يوثّقه المزوّدون اليوم؟
اطّلعنا عليه في 13 نوفمبر 2026:
- Anthropic. «يتيح التفكير المتداخل لـ Claude التفكير بين استدعاءات الأدوات، والاستدلال حول نتيجة كل أداة قبل التصرّف بناءً عليها». ويعمل تلقائيًا على النماذج التي تدعم التفكير التكيّفي، بينما تحتاج النماذج التي تعمل بالتفكير الموسّع اليدوي إلى ترويسة beta.
- OpenAI. نماذج مثل gpt-5.5 «تدعم التفكير المتداخل، حيث يستطيع النموذج توليد tokens إخراج مرئية قبل التفكير وفي أثنائه، ويستطيع التفكير بين استدعاءات الأدوات».
- Google. لا تستخدم صفحة التفكير في Gemini هذا المصطلح، لكنها تذكر أن خطوات التفكير «تظهر بترتيب زمني إلى جانب استدعاءات الدوال أو مدخلات المستخدم أو مخرجات النموذج»، وأن تواقيع التفكير «مطلوبة للحفاظ على استمرارية الاستدلال عبر التفاعلات متعددة الأدوار».
- vLLM. يقدّم خادم الاستدلال مفتوح المصدر دعمًا للتفكير المتداخل لسلسلتين من النماذج، ويحذّر من أنه «يزيد استهلاك tokens وزمن الاستجابة».
في مجال البحث، درّب Xie وآخرون (2025) نماذج «على المزاوجة بين التفكير والإجابة»، وأفادوا بانخفاض زمن الوصول إلى أول token بأكثر من 80% في المتوسط. ويعرّف Liang وآخرون (2025) الاستدلال المتداخل بأنه نموذج «يتناوب بين التفكير وإظهار ردود وسيطة»، وأفادوا بأن نسختهم القائمة على التخطيط أولًا، Plantain، خفّضت زمن الوصول إلى أول رد بأكثر من 60%. وقد تناولت الدراستان مهامّ نصية.
لماذا يكلّف الاستدلال المسبق صمتًا في المكالمة الهاتفية؟
في المكالمة الهاتفية، لا يمكن أن يبدأ تركيب الكلام حتى ينتج النموذج الكلمات الأولى من ردّه. وكل token استدلال يُولَّد قبل تلك الكلمات هو وقت لا يسمع فيه المتصل شيئًا. في نافذة الدردشة، يظهر الانتظار نفسه كمؤشر تقدّم، أما في المكالمة فهو صمت مطبق وزيادة في زمن الاستجابة.
تذكر وثائق استكشاف أخطاء زمن الاستجابة وإصلاحها من Retell أن النماذج الأكبر والموجّهة نحو الاستدلال «أبطأ في الوصول إلى أول token» و«تقايض زمن الاستجابة بالقدرة». وتُدرج OpenAI الصوت ضمن حالات الاستخدام الشائعة للتشغيل مع ضبط reasoning effort على none، وتقترح أن تطلب التطبيقات الحساسة لزمن الاستجابة من النموذج «توليد مقدّمة قصيرة قبل المتابعة باستدلال أعمق». ويتناول دليل أفضل نموذج LLM لوكلاء الذكاء الاصطناعي الصوتي مسألة اختيار النموذج.
ما الاستدلال المتداخل في الوكيل الصوتي؟
في الوكيل الصوتي، يعني الاستدلال المتداخل أن النموذج يكتب الجملة الأولى من ردّه فورًا، ثم يستدل بصمت أثناء نطق تلك الجملة، ثم يتابع الرد مستندًا إلى ذلك الاستدلال. يسمع المتصل إجابة واحدة متصلة، ولا يُنطَق الاستدلال أبدًا.
يعمل Tell-1 بهذه الطريقة. ويصف المقال التقني من Retell، Retell LLM: Interleaved Reasoning for Real-Time Voice Agents، هذا التنسيق بأنه «جملة افتتاحية منطوقة، ثم استدلال، ثم بقية الرد». ويفيد المقال بمتوسط 200 token استدلال في منتصف الرد، وبأن 99.98% من الأدوار يتوقف فيها الكلام أقل من 400 ms بعد الجملة الأولى.
مقارنةً بالاستدلال المسبق، لا ينتظر المتصل في صمت حتى ينتهي الاستدلال. ويوضّح المقال أيضًا المقايضة: «التحدّث مبكرًا يعني الالتزام بالجملة الافتتاحية قبل حدوث أي استدلال». ويحتل Tell-1 المرتبة الأولى إجمالًا في Retell vCX Benchmark (حتى نوفمبر 2026).
الأسئلة الشائعة حول الاستدلال المتداخل
هل الاستدلال المتداخل هو نفسه التفكير المتداخل؟
نعم، في معظم الاستخدامات. تستخدم Anthropic وOpenAI مصطلح التفكير المتداخل، بينما تميل الأوراق البحثية إلى استخدام مصطلح الاستدلال المتداخل.
هل تُحتسب tokens الاستدلال في الفوترة؟
نعم. تحتسبها OpenAI وAnthropic وGoogle جميعها ضمن الإخراج المفوتَر، وتفوترها OpenAI وAnthropic حتى عندما لا يُعاد نص الاستدلال.
هل يمكنك قراءة tokens الاستدلال الخاصة بالنموذج؟
عادةً لا. يمكن لـ OpenAI وAnthropic إعادة ملخّص إذا طلبته، لكن أيًّا منهما لا يعيد الاستدلال الخام.
هل يجعل الاستدلال المتداخل النموذج يستجيب أسرع؟
ليس بمفرده. فهو يضيف tokens بين استدعاءات الأدوات، وتحذّر وثائق vLLM من أنه يزيد زمن الاستجابة. ولا يصل أول إخراج مرئي أسرع إلا عندما يأتي الإخراج المرئي قبل الاستدلال، أو بين كتل أقصر منه.
ما الاستدلال المتداخل في الذكاء الاصطناعي الصوتي؟
هو نموذج يبدأ التحدّث فورًا، ويستدل بصمت أثناء تشغيل جملته الأولى، ثم يُكمل الرد مستخدمًا ذلك الاستدلال. وقد بُني Tell-1، نموذج LLM الخاص بـ Retell، بهذه الطريقة.
شغّل نماذج الاستدلال في المكالمات المباشرة
منصّة Retell AI هي منصّة وكلاء صوتيين بالذكاء الاصطناعي لمراكز التواصل، وتتيح لك اختيار النموذج الذي يقف خلف كل وكيل. وTell-1 أحد هذه النماذج. تواصل مع فريق Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


