فك الترميز التخميني (Speculative Decoding) تقنية لتسريع نموذج لغوي كبير: يخمّن نموذج مسودة صغير الـ tokens القليلة التالية، ثم يتحقق النموذج الكبير منها جميعًا في تمريرة واحدة، ويحتفظ بما كان سيُنتجه هو نفسه.
تعود هذه الطريقة إلى ورقتين بحثيتين. أطلقت Google Research عليها اسمها في ورقة Fast Inference from Transformers via Speculative Decoding (Leviathan وKalman وMatias، نُشرت أول مرة في نوفمبر 2022). ووصفت DeepMind نسختها الخاصة، التي طُوّرت بشكل مستقل، في ورقة Accelerating Large Language Model Decoding with Speculative Sampling (Chen وزملاؤه، فبراير 2023).
لماذا يكون فك الترميز القياسي بطيئًا؟
يكون فك الترميز القياسي بطيئًا لأن النموذج اللغوي الكبير يكتب token واحدًا في كل مرة، ويحتاج كل token إلى تشغيل كامل للنموذج. وتلخّص ورقة Google ذلك في سطر واحد: «فك ترميز K من الـ tokens يتطلب K من عمليات التشغيل المتتالية للنموذج».
كثير من هذه الـ tokens سهل التنبؤ. وتلاحظ الورقة نفسها أن «مهام النمذجة اللغوية الصعبة كثيرًا ما تتضمن مهام فرعية أسهل يمكن تقريبها جيدًا بنماذج أكثر كفاءة».
كيف يعمل نموذج المسودة والنموذج الكامل معًا؟
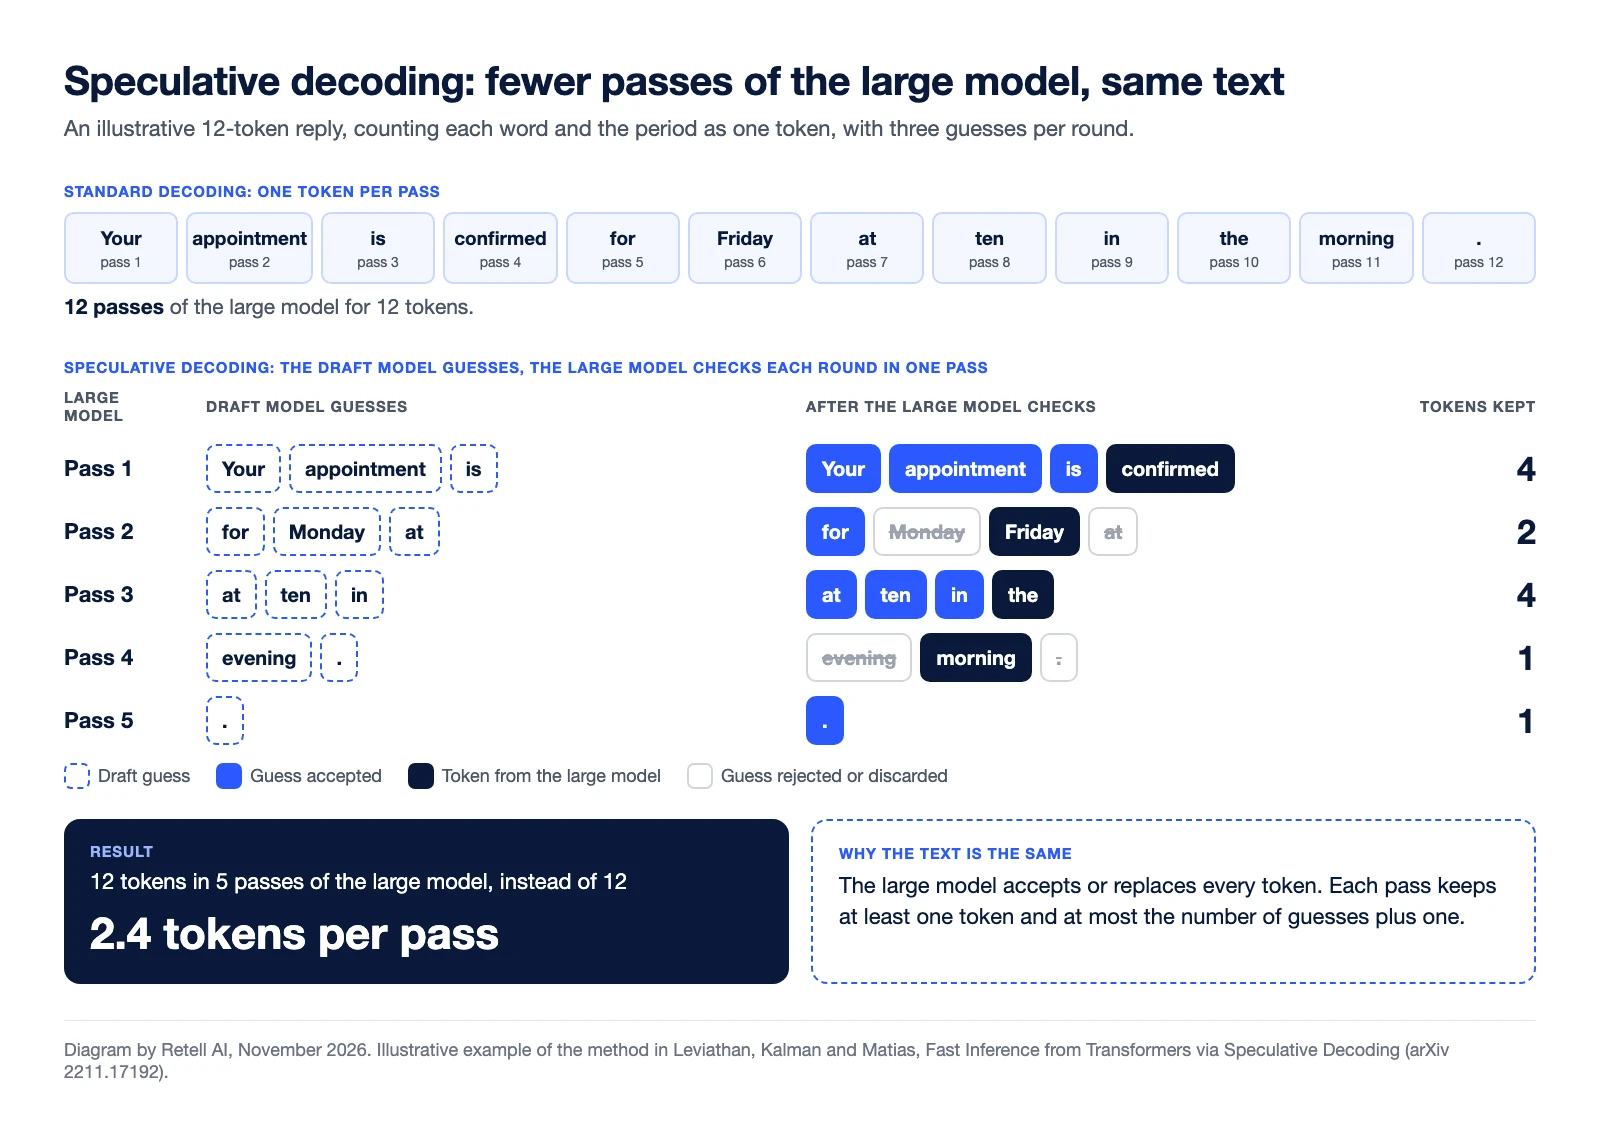
يعمل النموذجان على جولات، وتتألف كل جولة من ثلاثة أجزاء:
- المسودة. يكتب النموذج الصغير سلسلة قصيرة من التخمينات، token تلو الآخر. تسمّيه ورقة Google نموذج التقريب، بينما تسمّيه DeepMind نموذج المسودة.
- التحقق. يقيّم النموذج الكبير، المسمّى النموذج الهدف، كل موضع مُخمَّن بالتوازي في تمريرة واحدة.
- القبول أو التصحيح. تُقبل التخمينات من اليسار إلى اليمين. وعند أول تخمين مرفوض، يقدّم النموذج الكبير الـ token الخاص به وتُستبعد التخمينات اللاحقة. وإذا قُبلت كل التخمينات، يضيف النموذج الكبير token إضافيًا.
تُنتج كل تمريرة للنموذج الكبير token واحدًا على الأقل، وعلى الأكثر عدد التخمينات زائد واحد، لذا لا تحتاج أبدًا إلى تمريرات أكثر من فك الترميز القياسي.
مثال تطبيقي (توضيحي). ردّ باللغة الإنجليزية من 12 token، مع احتساب كل كلمة والنقطة كـ token واحد، وثلاثة تخمينات في كل جولة:
| تمريرة النموذج الكبير | تخمينات نموذج المسودة | حكم النموذج الكبير | الـ tokens المحتفَظ بها |
|---|---|---|---|
| 1 | Your appointment is | قُبلت التخمينات الثلاثة جميعها، ويضيف «confirmed» | 4 |
| 2 | for Monday at | قُبل «for». رُفض «Monday» واستُبدل بـ «Friday». استُبعد «at» | 2 |
| 3 | at ten in | قُبلت التخمينات الثلاثة جميعها، ويضيف «the» | 4 |
| 4 | evening . | رُفض «evening» واستُبدل بـ «morning». واستُبعدت النقطة | 1 |
| 5 | . | قُبل، وينتهي الرد | 1 |
| الإجمالي | 12 token في 5 تمريرات |
يحتاج فك الترميز القياسي إلى 12 تمريرة للنموذج الكبير لهذه الجملة. أما هنا فيعمل 5 مرات فقط، بمتوسط 2.4 token لكل تمريرة.
لماذا تبقى المخرجات دون تغيير؟
تبقى المخرجات دون تغيير لأن الكلمة الأخيرة في كل token تعود إلى النموذج الكبير. ففي فك الترميز الجشع (greedy decoding)، حيث يختار النموذج دائمًا خياره الأول، لا يُحتفظ بالتخمين إلا إذا كان هو الـ token الذي كان النموذج الكبير سيختاره. وتذكر وثائق vLLM اختبارًا لهذا تحديدًا: أخذ العينات الجشع مع فك الترميز التخميني «يطابق أخذ العينات الجشع من دونه».
أما في أخذ العينات العشوائي، فيُقبل التخمين باحتمال يحدّده تقييم النموذجين له، ويُعاد سحب التخمين المرفوض من توزيع مُعدَّل. وتثبت ورقة Google أن ذلك يُبقي توزيع المخرجات دون تغيير. وبصياغة DeepMind، فإن هذا الأسلوب «يحافظ على توزيع النموذج الهدف ضمن حدود الدقة العددية للعتاد».
بعض الأشكال الأحدث تخفّف عملية التحقق عمدًا لزيادة السرعة. وتشير vLLM إلى أن إحدى طرق التحقق لديها «لا تحافظ على التوزيع».
متى يفيد فك الترميز التخميني، ومتى لا يفيد؟
يفيد فك الترميز التخميني عندما يكون نموذج المسودة منخفض التكلفة ومصيبًا في الغالب، ويتوفر لدى الخادم فائض من القدرة الحاسوبية.
| الشرط | الأثر على السرعة | المصدر |
|---|---|---|
| التخمينات تُقبل عادةً | tokens أكثر لكل تمريرة. العدد المتوقع من الـ tokens لكل تمريرة = (1 − α^(γ+1)) ÷ (1 − α)، حيث α هو معدل القبول وγ عدد التخمينات في كل جولة | ورقة Google |
| نموذج المسودة أصغر بكثير من النموذج الهدف | تكلفة صياغة منخفضة. نموذج مسودة أصغر بنحو رتبتين عشريتين «حقق عادةً أفضل أداء» | ورقة Google |
| توفر فائض في القدرة الحاسوبية | شرط أساسي. تفترض الطريقة وجود «موارد حوسبة كافية لدعم التزامن المتزايد» | ورقة Google |
| حركة مرور كثيفة على الخادم | مكسب أقل. تصنّف vLLM نموذج المسودة بأنه «مكسب مرتفع» عند معدلات الطلب المنخفضة و«مكسب متوسط» عند المعدلات المرتفعة | وثائق vLLM |
| نموذج المسودة يخطئ كثيرًا مقارنةً بتكلفته | لا مكسب. لا يتحقق التسريع إلا عندما يكون معدل القبول أعلى من تكلفة نموذج المسودة نسبةً إلى النموذج الهدف | ورقة Google |
على سبيل التوضيح، يعطي معدل قبول قدره 0.6 مع ثلاثة تخمينات في كل جولة نحو 2.2 token لكل تمريرة.
التسريعات المنشورة: تذكر ورقة Google تسريعًا من 2X إلى 3X على نموذج T5-XXL ذي 11 مليار مُعامل. وتذكر DeepMind تسريعًا من 2 إلى 2.5 مرة على نموذج Chinchilla ذي 70 مليار مُعامل مع نموذج مسودة من 4 مليارات مُعامل. وتعتمد النتائج على النماذج والمهمة والعتاد.
مثال من بيئة الإنتاج في المجال الصوتي: يستخدم Tell-1، نموذج LLM الخاص بمنصّة Retell، فك الترميز التخميني للحصول على نحو أربعة tokens من كل تمريرة للنموذج الكامل، وفقًا لـ المقال التقني لمنصّة Retell حول Retell LLM.
لماذا يهمّ فك الترميز التخميني في الصوت الفوري؟
يهمّ فك الترميز التخميني في الصوت الفوري لأن المتصل يسمع وقت معالجة النموذج صمتًا. ففي المكالمة، يمثّل النموذج مرحلة واحدة من مسار تحويل الكلام إلى نص وLLM وتحويل النص إلى كلام، ويُضاف تأخيره إلى زمن الاستجابة في المكالمة.
توضّح أفضل الممارسات لنموذج LLM مخصّص من Retell أيّ جزء من وقت النموذج يُحتسب: تبدأ منصّة Retell «الحديث فور حصولها على أول جملة مكتملة منك»، لذا فالرقم الذي ينبغي مراقبته هو «الوقت حتى أول token مضافًا إليه الوقت اللازم لإنهاء تلك الجملة الأولى». ويعمل فك الترميز التخميني على الجزء الثاني: فبمجرد بدء التوليد، تصل الـ tokens على دفعات. لكنه لا يختصر قراءة الـ prompt التي تسبق أول token. ولهذا الغرض، يبدأ دليل استكشاف مشكلات زمن الاستجابة من Retell باختيار النموذج وطول الـ prompt.
السبب الآخر هو الدقة. فالانتقال إلى نموذج أصغر يقلّل التأخير أيضًا، لكن الدليل نفسه يحذّر من أن تبديل النماذج «يغيّر سلوك وكيلك، لا سرعته فحسب». أما فك الترميز التخميني الدقيق فيحافظ على مخرجات النموذج الكبير.
تطبّقه الجهة التي تقدّم النموذج، لذا يراه منشئ الوكيل في صورة سرعة النموذج. وعلى منصّة Retell، يُقدَّم Tell-1 بهذه الطريقة. ولمقارنة النماذج من حيث السرعة وجودة المكالمات، اطّلع على أفضل نماذج LLM لوكلاء الذكاء الاصطناعي الصوتي.
الأسئلة الشائعة حول فك الترميز التخميني
هل فك الترميز التخميني بلا فقد؟
في شكله الدقيق، نعم. تثبت الأوراق الأصلية أن توزيع المخرجات يطابق توزيع النموذج الكبير، وتصفه vLLM بأنه «بلا فقد نظريًا ضمن حدود الدقة العددية للعتاد». أما الأشكال التي تخفّف عملية التحقق فليست بلا فقد.
من ابتكر فك الترميز التخميني؟
نشر Yaniv Leviathan وMatan Kalman وYossi Matias من Google Research الورقة في نوفمبر 2022 وقدّموها في مؤتمر ICML 2023. ونشر فريق من DeepMind نسخته الخاصة، المسمّاة أخذ العينات التخميني، في فبراير 2023.
ما هو نموذج المسودة؟
نموذج المسودة هو النموذج الصغير والسريع الذي يكتب التخمينات. وتذكر وثائق Hugging Face أن الطريقة تعمل على أفضل وجه عندما يكون «أصغر بكثير من النموذج الرئيسي ويستخدم أداة الترميز (tokenizer) نفسها».
هل يقلّل فك الترميز التخميني التكلفة؟
قد يحدث هذا أو ذاك. تشير ورقة Google إلى أن العدد الإجمالي للعمليات الحسابية «قد يكون أعلى منه في خوارزمية فك الترميز القياسية»، لأن التخمينات المرفوضة جهد مُهدَر. وتضيف مراجعة Google لعام 2024 أن الحصول على نتائج أسرع على العتاد نفسه يعني أن «عددًا أقل من الأجهزة يلزم لخدمة الحجم نفسه من حركة المرور».
هل التنبؤ متعدد الـ tokens هو نفسه فك الترميز التخميني؟
لا. التنبؤ متعدد الـ tokens (MTP) هو إحدى طرق إنتاج التخمينات. وتدرج وثائق vLLM تقنية MTP إلى جانب نماذج المسودة كطريقة للتخمين.
اختبر سرعة النموذج على مكالماتك الخاصة
Retell AI منصّة لوكلاء صوتيين بالذكاء الاصطناعي مخصّصة لمراكز التواصل. تواصل مع فريق Retell بشأن تجربة تجريبية على مكالمات حقيقية.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


