التخزين المؤقت للـ prompt (Prompt Caching) تقنية تتيح لنموذج اللغة الكبير تخطّي العمل الذي أنجزه سابقًا: فعندما يبدأ طلب جديد بنفس الـ tokens التي بدأ بها طلب سابق، يعيد النموذج استخدام الحسابات المحفوظة لهذه البداية المشتركة ولا يعالج إلا الجديد. والنتيجة ظهور أول token بسرعة أكبر، وفي معظم واجهات API سعر أقل للـ tokens المُعاد استخدامها.
يُسمّى الجزء المُعاد استخدامه «البادئة» (prefix). ويعرّفها دليل OpenAI بأنها «الـ tokens غير المتغيّرة في بداية الـ prompt». وعادةً ما تقع هناك التعليمات وتعريفات الأدوات وأدوار المحادثة السابقة.
كيف يعمل التخزين المؤقت للـ prompt؟
تصف وثائق Anthropic التسلسل كالتالي: يتحقق النظام مما إذا كانت بادئة الـ prompt مخزّنة مؤقتًا من استعلام حديث، فإن كانت كذلك استخدم النسخة المخزّنة، وإلا عالج الـ prompt كاملًا وخزّن البادئة مؤقتًا.
تترتب على هذا التصميم ثلاث قواعد:
- التطابق يجب أن يكون تامًا. تنص Anthropic على أن إصابة ذاكرة التخزين المؤقت تتطلب «مقاطع prompt متطابقة بنسبة 100 بالمئة». فتغيير حرف واحد في بداية الـ prompt يعني إعادة معالجة كل ما يليه.
- الترتيب مهم. يأتي المحتوى الثابت أولًا والمحتوى المتغيّر أخيرًا.
- للإدخالات مدة صلاحية. مدة الصلاحية الافتراضية لدى Anthropic هي 5 دقائق، وتتجدد في كل مرة يُستخدم فيها المحتوى المخزّن. أما لدى OpenAI فتعتمد المدة على النموذج.
ما العلاقة بين التخزين المؤقت للـ prompt والتخزين المؤقت للبادئة وذاكرة KV المؤقتة؟
إنها ثلاث طبقات للفكرة نفسها. ذاكرة KV المؤقتة (KV cache) هي البيانات، والتخزين المؤقت للبادئة (Prefix Caching) هو إعادة استخدام تلك البيانات عبر الطلبات، والتخزين المؤقت للـ prompt هو الاسم الذي يطلقه مزوّدو API على هذه الميزة.
| المصطلح | ما هو | النطاق | أين يظهر المصطلح |
|---|---|---|---|
| ذاكرة KV المؤقتة | حالات المفاتيح والقيم (key/value) التي يحسبها النموذج لكل token قرأه، وتُحفظ كي لا يُعاد حسابها مع كل token جديد | داخل طلب واحد | البنية الداخلية للنماذج، ومحركات الاستدلال |
| التخزين المؤقت للبادئة | الاحتفاظ بذاكرة KV المؤقتة بعد انتهاء الطلب وإعادة استخدامها لطلب لاحق يبدأ بنفس الـ tokens | عبر الطلبات على الخادم نفسه | محركات الاستدلال مثل vLLM |
| التخزين المؤقت للـ prompt | التخزين المؤقت للبادئة مقدَّمًا كميزة API، مع قواعد لمدة الصلاحية والحد الأدنى للطول والسعر | عبر استدعاءات API | وثائق مزوّدي النماذج وصفحات الأسعار |
يشرح مقال توضيحي من Hugging Face ذاكرة KV المؤقتة ببساطة: «بدلًا من إعادة حساب كل شيء من الصفر، يعيد النموذج استخدام ما حسبه بالفعل». وتذكر وثائق vLLM أن التخزين المؤقت التلقائي للبادئة «يخزّن ذاكرة KV المؤقتة للاستعلامات الحالية، بحيث يمكن لاستعلام جديد إعادة استخدامها مباشرةً إذا كان يشترك في البادئة نفسها». وتؤكد OpenAI هذه الصلة من جهة API: «تخزّن ذاكرة الـ prompt المؤقتة موترات المفاتيح والقيم (KV)، لا الـ tokens نفسها».
لماذا يهم التخزين المؤقت للـ prompt في مكالمة هاتفية متعددة الأدوار؟
يستدعي الوكيل الصوتي النموذج مرة واحدة في كل دور، ويحمل كل طلب التعليمات وتعريفات الأدوات والمحادثة حتى تلك اللحظة. وفي المحادثة متعددة الأدوار يكون كل ذلك تقريبًا مطابقًا لطلب الدور السابق، ولا يكون جديدًا إلا التبادل الأخير. ومن دون التخزين المؤقت، يقرأ النموذج التعليمات نفسها مجددًا في كل دور.
مثال تطبيقي (أرقام توضيحية). لدى وكيل 2,500 token من التعليمات والأدوات، ويضيف كل دور 100 token من المحادثة، ويجد كل دور بعد الأول بادئته في ذاكرة التخزين المؤقت:
| الدور | tokens الـ prompt | المُعاد استخدامها من الذاكرة المؤقتة | tokens جديدة للقراءة |
|---|---|---|---|
| 1 | 2,600 | 0 | 2,600 |
| 2 | 2,700 | 2,600 | 100 |
| 5 | 3,000 | 2,900 | 100 |
| 10 | 3,500 | 3,400 | 100 |
| جميع الأدوار العشرة | 30,500 | 27,000 | 3,500 |
على امتداد المكالمة، يأتي 27,000 من أصل 30,500 token من tokens الـ prompt (نحو 89%) من ذاكرة التخزين المؤقت. وبدءًا من الدور الثاني، يقرأ النموذج 100 token جديدة بدلًا من أكثر من 2,600.
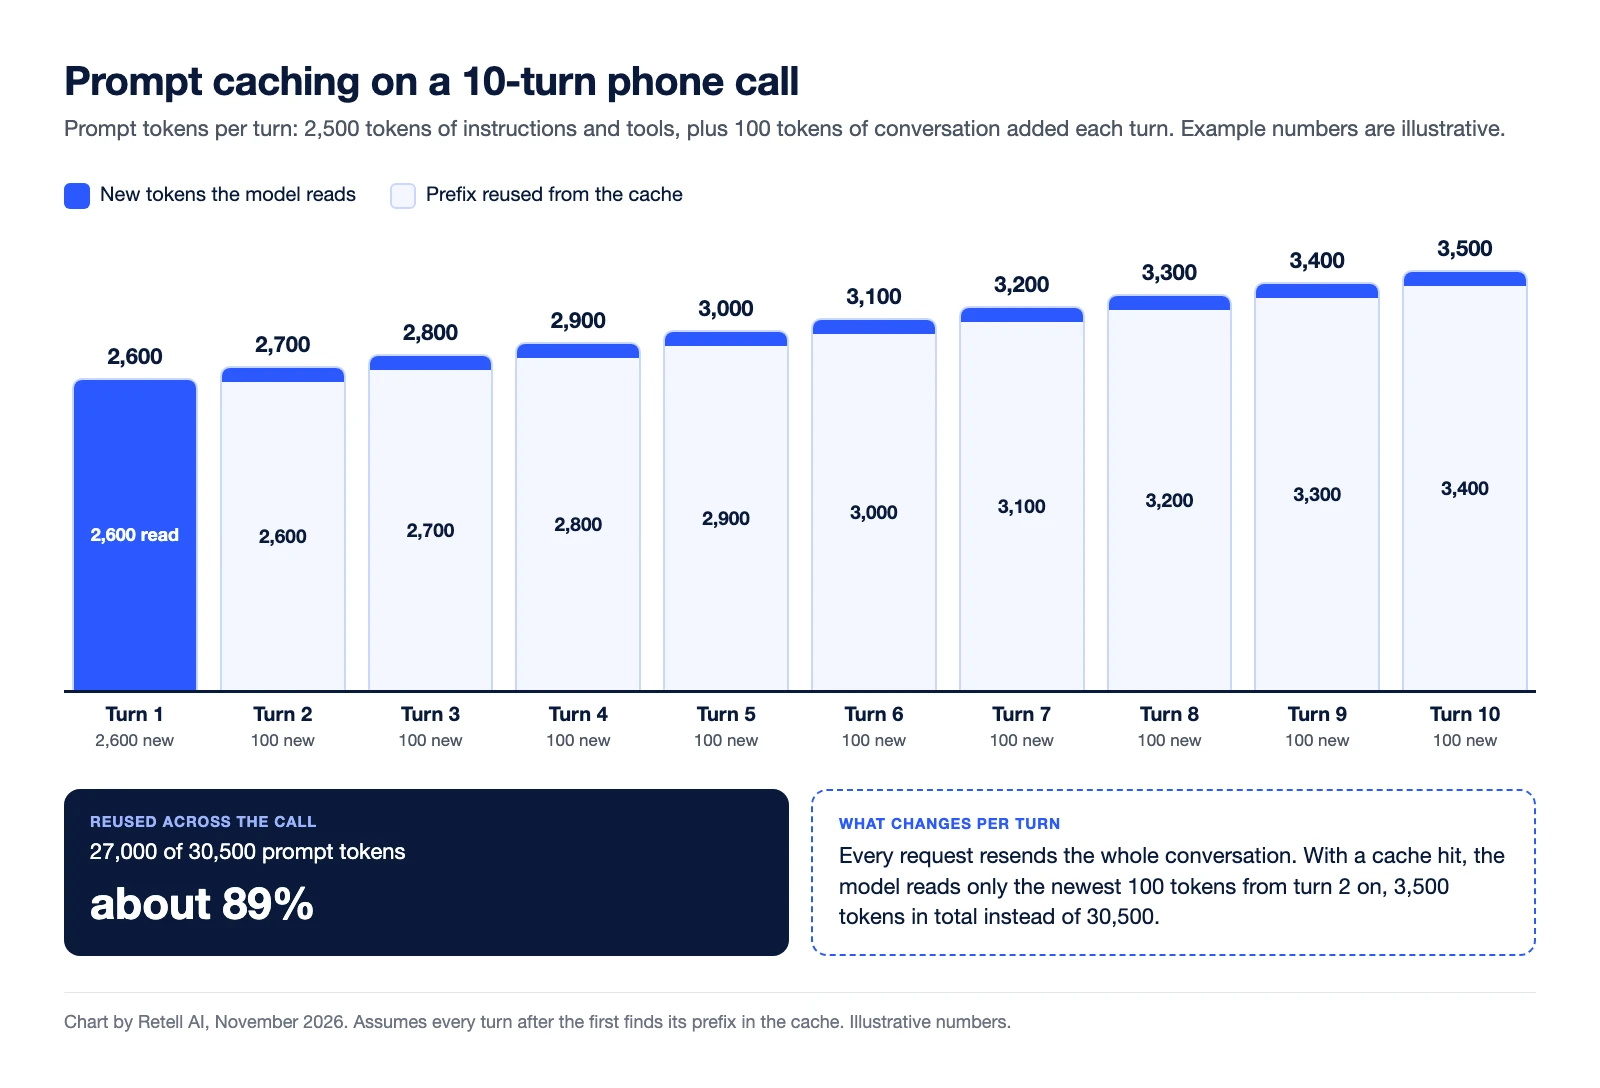
لهذا أهمية لسببين. أولًا، الوقت حتى أول token جزء من زمن الاستجابة الذي يسمعه المتصل صمتًا، وقراءة prompt طويل تستغرق وقتًا. وثانيًا التكلفة: تسعّر Anthropic القراءة من الذاكرة المؤقتة بـ 0.1 ضعف السعر الأساسي لـ token الإدخال، والكتابة إليها بـ 1.25 ضعف لمدة الصلاحية البالغة 5 دقائق.
ما الذي يمنع إصابة الذاكرة المؤقتة؟
- تغيّر البادئة. فطابع زمني، أو اسم المتصل، أو إعادة ترتيب قائمة الأدوات قرب بداية الـ prompt يغيّر كل token يليه.
- فاصل زمني أطول من مدة صلاحية الذاكرة المؤقتة.
- وصول الطلب إلى جهاز مختلف. يشير دليل OpenAI إلى أن «الحالات المخزّنة مؤقتًا توجد على أجهزة منفردة»، وأن الطلب يمكنه إعادة استخدام البادئة «فقط إذا وصل إلى جهاز يحتفظ بإدخال مطابق لم تنتهِ صلاحيته».
يمكن للتوجيه سدّ هذه الثغرة الأخيرة. فنموذج Tell-1، وهو نموذج LLM الخاص بـ Retell، يُبقي كل مكالمة على وحدات GPU التي تحتفظ بها بالفعل في الذاكرة المؤقتة، باستخدام تقارب الجلسة (session affinity). ووفقًا للمقال التقني حول نموذج LLM من Retell، يضاعف ذلك تقريبًا نسبة tokens الـ prompt المقدَّمة من الذاكرة المؤقتة، من 36% إلى 69%، فيقلّ ما يجب قراءته في كل دور وتبدأ الردود أسرع.
لا يغيّر التخزين المؤقت الإجابة. إذ تذكر ملاحظات تصميم vLLM أن التخزين المؤقت للبادئة «لن يغيّر مخرجات النموذج».
أين تندرج الوكلاء الصوتيون بالذكاء الاصطناعي
يوضح دليل استكشاف أخطاء زمن الاستجابة من Retell تكلفة طول الـ prompt مباشرةً: «كل token في الـ prompt يضيف إلى الوقت حتى أول token، وتُدفع هذه التكلفة في كل دور من المحادثة».
إذا ربطت نموذجك الخاص عبر LLM WebSocket من Retell، فإن كل طلب استجابة يصل مع «النص المباشر الكامل الذي جُمع في المكالمة حتى الآن». يبني خادمك الـ prompt، لذا يعتمد سلوك الذاكرة المؤقتة على طريقة بنائه وعلى مزوّد النموذج لديك: ضع التعليمات والأدوات أولًا دون تغيير، وألحِق النص بعدها. وللاطلاع على المسار الكامل الذي يسلكه الدور، راجع كيف يعمل الذكاء الاصطناعي الصوتي في الوقت الفعلي.
الأسئلة الشائعة حول التخزين المؤقت للـ prompt
ما الفرق بين التخزين المؤقت للـ prompt وذاكرة KV المؤقتة؟
ذاكرة KV المؤقتة هي حالة الانتباه المخزّنة التي يبنيها النموذج أثناء قراءة الـ tokens. أما التخزين المؤقت للـ prompt فيحتفظ بتلك الحالة بعد انتهاء الطلب كي يتمكن طلب لاحق يبدأ بنفس الـ tokens من إعادة استخدامها.
هل التخزين المؤقت للبادئة هو نفسه التخزين المؤقت للـ prompt؟
إنهما الآلية نفسها. التخزين المؤقت للبادئة هو المصطلح الذي تستخدمه محركات الاستدلال، والتخزين المؤقت للـ prompt هو اسم المنتج الذي يستخدمه مزوّدو النماذج في واجهات API الخاصة بهم.
هل يغيّر التخزين المؤقت للـ prompt استجابة النموذج؟
لا. فهو يتخطّى فقط إعادة حساب البادئة المشتركة.
كم تدوم ذاكرة الـ prompt المؤقتة؟
يعتمد ذلك على المزوّد. فالمدة الافتراضية لدى Anthropic هي 5 دقائق تتجدد مع كل استخدام، مع خيار لمدة ساعة واحدة بسعر كتابة أعلى. أما لدى OpenAI فتعتمد المدة على النموذج.
لماذا يهم التخزين المؤقت للـ prompt للوكلاء الصوتيين؟
يعيد كل دور في المكالمة إرسال التعليمات والمحادثة حتى تلك اللحظة. ومع إصابة الذاكرة المؤقتة، لا يقرأ النموذج إلا أحدث تبادل.
اسمع الفرق في مكالماتك
Retell AI منصّة للوكلاء الصوتيين بالذكاء الاصطناعي مخصّصة لمراكز التواصل. ونموذج Tell-1 هو نموذج LLM الخاص بها، المصمَّم للمكالمات الهاتفية. وتوضح وثائقها كيفية التحقق من زمن الاستجابة لكل مكالمة حسب كل مكوّن، لتعرف مقدار الانتظار الذي يعود إلى النموذج. تواصل مع فريق Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


