الوقت حتى أول token (TTFT) هو المدة بين إرسال طلب إلى نموذج لغوي كبير (LLM) وتلقّي أول token من ردّه. ويقيس مدى سرعة بدء النموذج في الإجابة، لا المدة التي تستغرقها الإجابة كاملة.
يعرّفه دليل قياس الأداء من NVIDIA بأنه «الوقت من إرسال الاستعلام حتى تلقّي أول token». وفي المكالمة الهاتفية، يمثّل TTFT جزءًا واحدًا من زمن الاستجابة الذي يسمعه المتصل. ويُبنى فوقه مقياسان آخران: الوقت حتى أول جملة، وزمن الاستجابة الصوتية الشامل (من طرف إلى طرف).
ما الذي يشمله TTFT؟
يغطي TTFT كل ما يسبق بدء النموذج في بثّ أول token. وتُدرج IBM أربعة أجزاء: تأخير الانتظار في الطابور، ووقت المعالجة المسبقة (prefill) أي معالجة الـ prompt، وتوليد أول token، والحمل الإضافي للشبكة وAPI.
تصف IBM مرحلة prefill بأنها «غالبًا أكبر مساهم في TTFT، خاصةً مع الـ prompts الأطول». إذ يقرأ النموذج الـ prompt كاملًا قبل أن يكتب أي شيء، لذا فإن الـ prompt الأطول يعني انتظارًا أطول. ويؤثر الحمل أيضًا، إذ تشير وثائق Anyscale إلى أن الخادم الواقع تحت استخدام كثيف قد يضع الطلبات الواردة في طابور انتظار، وهذا الانتظار يُضاف إلى TTFT.
كيف تقيس TTFT؟
- TTFT = وقت تلقّي أول token مطروحًا منه وقت إرسال الطلب
ثلاثة اختيارات تغيّر النتيجة. اذكرها مع أي رقم لـ TTFT:
- موضع الساعة. عند القياس من جهة العميل، يشمل TTFT وقت الشبكة. وعند القياس داخل خادم النموذج، لا يشمله.
- المئين المستخدم. يُظهر الوسيط (P50) الطلب المعتاد، بينما يُظهر P90 وP99 الطلبات البطيئة.
- مقدار الحمل. طلب واحد على خادم خامل هو أفضل الحالات. أما في بيئة الإنتاج، فكما تشير NVIDIA، قد تتداخل مرحلة prefill لطلب ما مع مرحلة التوليد لطلب آخر.
ما الفرق بين TTFT والوقت حتى أول جملة وزمن الاستجابة الشامل في المكالمة الهاتفية؟
يتوقف TTFT عند أول token. ويتوقف الوقت حتى أول جملة عند وصول جملة كاملة. أما زمن الاستجابة الصوتية الشامل فيغطي الفجوة الكاملة التي يسمعها المتصل.
المتصل لا يسمع token أبدًا. وتنص أفضل ممارسات نموذج LLM المخصّص من Retell على ما يلي: «تبدأ منصّة Retell بالتحدث بمجرد حصولها على أول جملة كاملة منك». والرقم المهم هنا هو «الوقت حتى أول token مضافًا إليه الوقت اللازم لإكمال تلك الجملة الأولى».
تقيس وثائق زمن الاستجابة من Retell زمن الاستجابة الشامل «من لحظة توقّف المستخدم عن الكلام حتى لحظة بدء الوكيل في الكلام».
| المقياس | بداية التوقيت | نهاية التوقيت | ما يُستبعد |
|---|---|---|---|
| الوقت حتى أول token (TTFT) | إرسال الطلب إلى LLM | تلقّي أول token | بقية الجملة الأولى، والتعرّف على الكلام، وتوليف الكلام |
| الوقت حتى أول جملة | إرسال الطلب إلى LLM | تلقّي أول جملة كاملة | التعرّف على الكلام، وتوليف الكلام، والاتصالات الهاتفية |
| زمن الاستجابة الصوتية الشامل | توقّف المتصل عن الكلام | بدء الوكيل في الكلام | لا شيء في المسار. تحقّق مما إذا كان الرقم يحتسب مقطع الشبكة الواصل إلى المتصل |
فخ في التسمية: في قياس أداء LLM، يمتد زمن الاستجابة الشامل حتى آخر token. وتعرّفه NVIDIA بأنه «المدة المستغرقة من إرسال الاستعلام حتى تلقّي الاستجابة الكاملة».
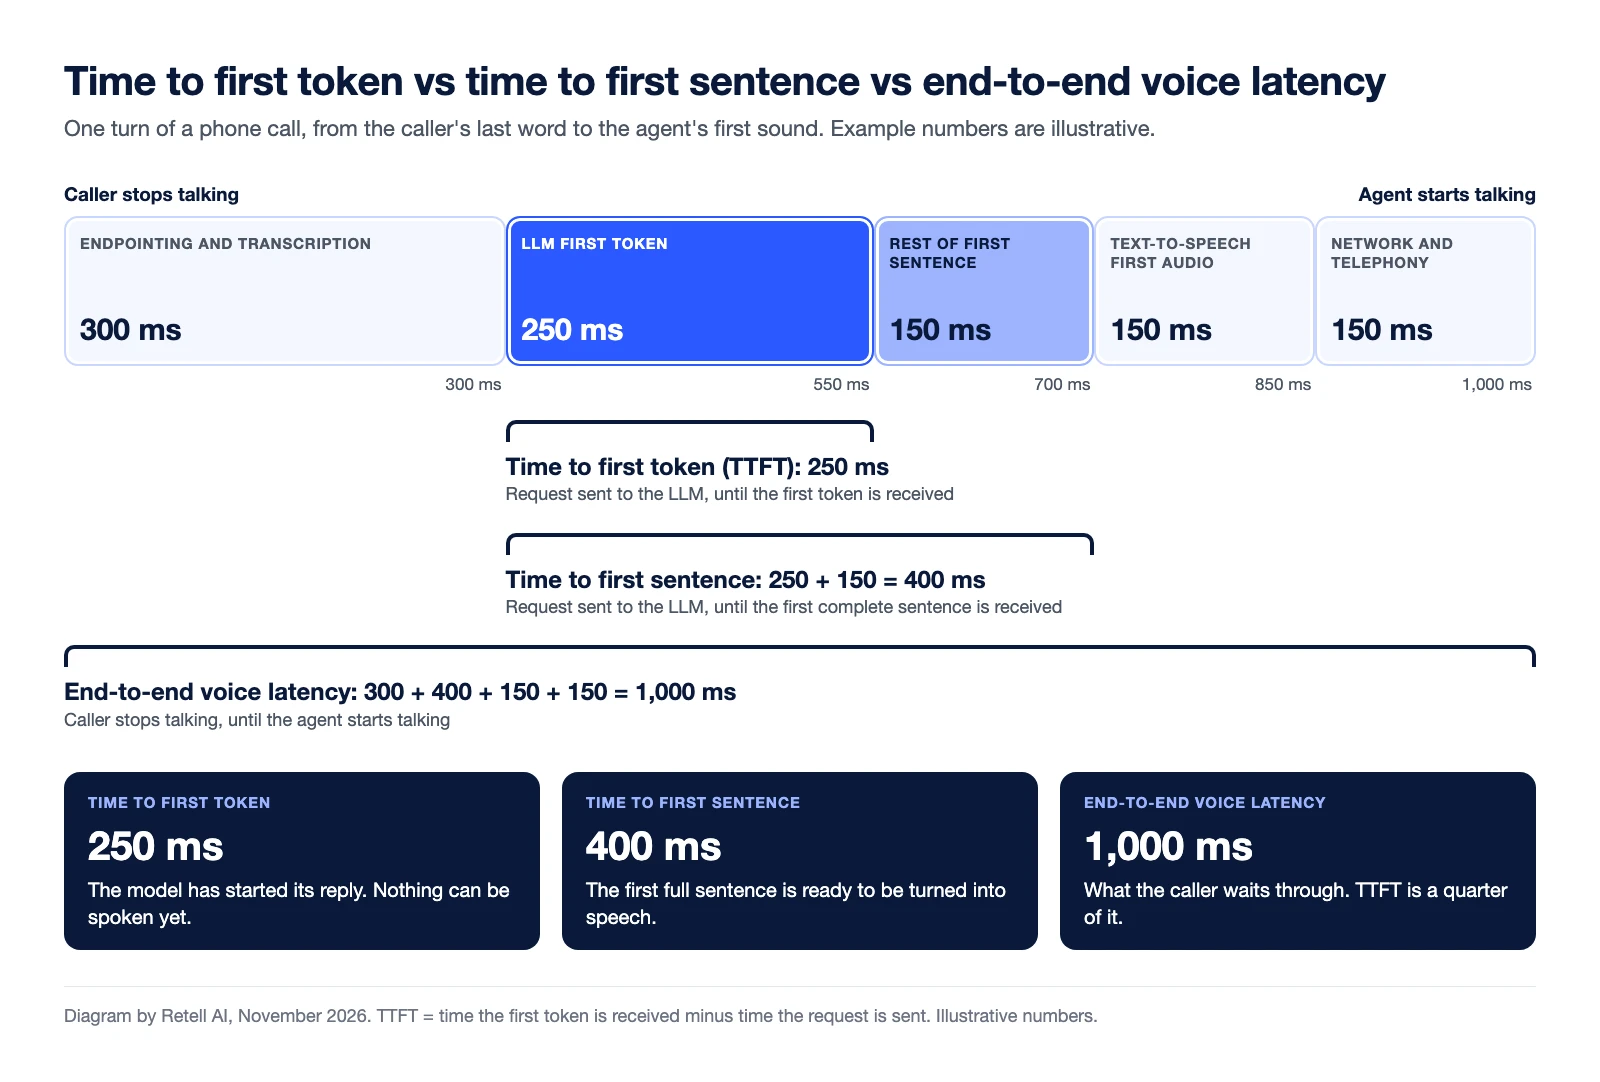
مثال تطبيقي (أرقام توضيحية). دورة واحدة من مكالمة:
- رصد نهاية الكلام والتفريغ النصي: 300 ms
- أول token من LLM: 250 ms
- بقية الجملة الأولى: 150 ms (15 token إضافيًا بمعدل 10 ms لكل منها)
- أول صوت من تحويل النص إلى كلام: 150 ms
- الشبكة والاتصالات الهاتفية: 150 ms
يبلغ TTFT 250 ms. والوقت حتى أول جملة هو 250 + 150 = 400 ms. أما زمن الاستجابة الصوتية الشامل فهو 300 + 400 + 150 + 150 = 1,000 ms، أي أن TTFT يمثّل ربع مدة انتظار المتصل. ويستخدم دليلنا حول معايير زمن استجابة الذكاء الاصطناعي الصوتي الميزانية نفسها.
لماذا قد يكون TTFT مضلِّلًا عند مقارنة النماذج؟
لا يُقارَن رقم TTFT إلا برقم TTFT آخر مأخوذ بالطريقة نفسها. فإذا وضعت TTFT لنموذج ما مقابل الوقت حتى أول جملة لنموذج آخر، فسيبدو الأول دائمًا أسرع. وينطبق الأمر نفسه على مقارنة وقت النموذج وحده بوقت مقيس في مكالمة حيّة، وعلى مقارنة الوسيط بـ P99.
وقد يرسل النموذج أيضًا أول token بسرعة ثم يبثّ ببطء، مما يُبقي المتصل في صمت.
كيف تخفّض TTFT في الوكيل الصوتي؟
يحدد دليل استكشاف مشكلات زمن الاستجابة وإصلاحها من Retell اختيارَ النموذج وطولَ الـ prompt بوصفهما السببين الأكثر شيوعًا لارتفاع زمن الاستجابة.
- اختر نموذجًا أسرع. يُعدّ Tell-1 أحد الخيارات المصممة للمكالمات. ووفقًا للدليل، فإن النماذج الأكبر الموجّهة نحو الاستدلال «أبطأ في الوصول إلى أول token».
- اختصر الـ prompt. «كل token في الـ prompt يُضاف إلى الوقت حتى أول token»، وذلك في كل دورة. وتصبح الـ prompts التي تتجاوز نحو 8k token أبطأ بشكل ملحوظ.
- ابثّ الرد. مع نموذج LLM مخصّص، فإن إرسال الاستجابة كاملة في حدث واحد «يضع عملية التوليد بأكملها في صمت المتصل».
تُرجع Get Call API من Retell زمن الاستجابة الشامل وزمن استجابة LLM وزمن استجابة تحويل النص إلى كلام لكل مكالمة عند P50 وP90 وP95 وP99. ويمتد رقم LLM «حتى تلقّي أول جزء قابل للنطق»، لذا فهو يقيس النص القابل للنطق، لا أول token خام.
بعض النماذج مبنية حول هذا المقياس. إذ يبدأ Tell-1، نموذج LLM الخاص بـ Retell، ردَّه ويواصل الاستدلال أثناء تشغيل العبارة الأولى. ويحقق أدنى زمن استجابة وسيط على Retell vCX Benchmark بواقع 76 ms، وهو وسيط متجدد على مدى 24 ساعة للوقت حتى أول جملة (تمت قراءته في 13 نوفمبر 2026). ويشرح المنشور التقني حول Retell LLM آلية عمله، علمًا بأن وقت النموذج ليس سوى جزء واحد من زمن الاستجابة الصوتية الشامل.
الأسئلة الشائعة حول الوقت حتى أول token
ما القيمة الجيدة للوقت حتى أول token؟
لا يوجد معيار واحد، فهو يعتمد على النموذج وطول الـ prompt وحمل الخادم. وبالنسبة إلى الوكيل الصوتي، قيّمه ضمن رقم زمن الاستجابة الشامل. وتقترح وثائق Retell إبقاء زمن الاستجابة المقدَّر للوكيل أقل من 1.5 ثانية.
هل TTFT هو نفسه زمن الاستجابة؟
لا. TTFT هو تأخير LLM حتى أول token. أما زمن الاستجابة في المكالمة فهو الفجوة الكاملة بين انتهاء المتصل من الكلام وبدء الوكيل في التحدث.
هل يشمل TTFT وقت الشبكة؟
يعتمد ذلك على موضع القياس. تقول NVIDIA إن TTFT «يشمل عمومًا وقت انتظار الطلب في الطابور، ووقت prefill، وزمن استجابة الشبكة». أما الرقم الخاص بالنموذج وحده المأخوذ داخل الخادم فيستبعد الشبكة.
ما الفرق بين TTFT والوقت حتى أول جملة؟
يتوقف TTFT عند أول token. أما الوقت حتى أول جملة فيتوقف عند وصول أول جملة كاملة، وهي اللحظة التي يمكن فيها للوكيل الصوتي أن يبدأ الكلام.
قِس زمن الاستجابة في مكالماتك
منصّة Retell AI هي منصّة وكلاء صوتيين بالذكاء الاصطناعي لمراكز التواصل. تعرض Call History زمن الاستجابة لكل مكالمة، مع تفصيله حسب المكوّن في Get Call API. تواصل مع فريق Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


