نموذج LLM كحَكَم (LLM as a judge) هو أسلوب تقييم يتولّى فيه نموذج لغوي كبير منح درجات لمخرجات نظام ذكاء اصطناعي آخر أو ترتيبها وفق معايير مكتوبة، بدلًا من المراجع البشري. وتستخدمه الفرق لتقييم الأعمال المفتوحة، مثل المكالمة الهاتفية، التي لا توجد لها إجابة صحيحة واحدة.
يعود الاسم إلى ورقة بحثية صدرت عام 2023 بعنوان Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. وأفاد مؤلفوها بأن الحكّام الأقوياء مثل GPT-4 توافقوا مع التفضيلات البشرية «بنسبة اتفاق تتجاوز 80%، وهو مستوى الاتفاق نفسه بين البشر». كما سردوا حدوده: تحيّز الموضع، وتحيّز الإسهاب، وتحيّز تفضيل الذات.
كيف يقيّم حَكَم LLM المحادثة؟
يقرأ حَكَم LLM المحادثة ومجموعة من التعليمات، ثم يُصدر حكمه بإحدى ثلاث صيغ.
| الأسلوب | ما يفعله الحَكَم | النتيجة المُعادة | مجال الاستخدام |
|---|---|---|---|
| التقييم وفق سُلّم معايير | يقرأ نصًا مفرّغًا واحدًا ويقارنه بمعايير مكتوبة | نجاح أو إخفاق، أو درجة، مع التعليل | QA في بيئة الإنتاج واختبارات الانحدار |
| الترتيب الثنائي | يقارن بين ردّين أو أكثر على الدور نفسه في المحادثة | ردّ فائز أو ترتيب تفاضلي | المفاضلة بين صيغ prompt أو بين النماذج |
| لجنة الحكّام | تقيّم عدة نماذج حَكَم العنصر نفسه وتُجمَع أحكامها | درجة مجمّعة واحدة | الدرجات التي قد يُحرّفها تحيّز نموذج واحد |
التقييم وفق سُلّم معايير. في ورقة G-Eval، طُلب من الحَكَم أن يستدلّ عبر المعايير ثم يملأ نموذج تقييم. وفي مهام التلخيص، جاءت درجاته أكثر ارتباطًا بتقييمات البشر مقارنةً بالأساليب السابقة.
الترتيب الثنائي. يناسب السؤالُ عن أيّ الردّين أفضل سماتٍ مثل النبرة، حيث يكون رصد الفرق أسهل من منحه درجة.
لجان الحكّام. في ورقة Replacing Judges with Juries، تبيّن أن لجنة من نماذج أصغر تنتمي إلى عائلات نماذج مختلفة «تتفوّق على حَكَم كبير واحد، وتُظهر تحيّزًا أقل داخل النموذج»، وكانت «أقل تكلفة بأكثر من سبع مرات».
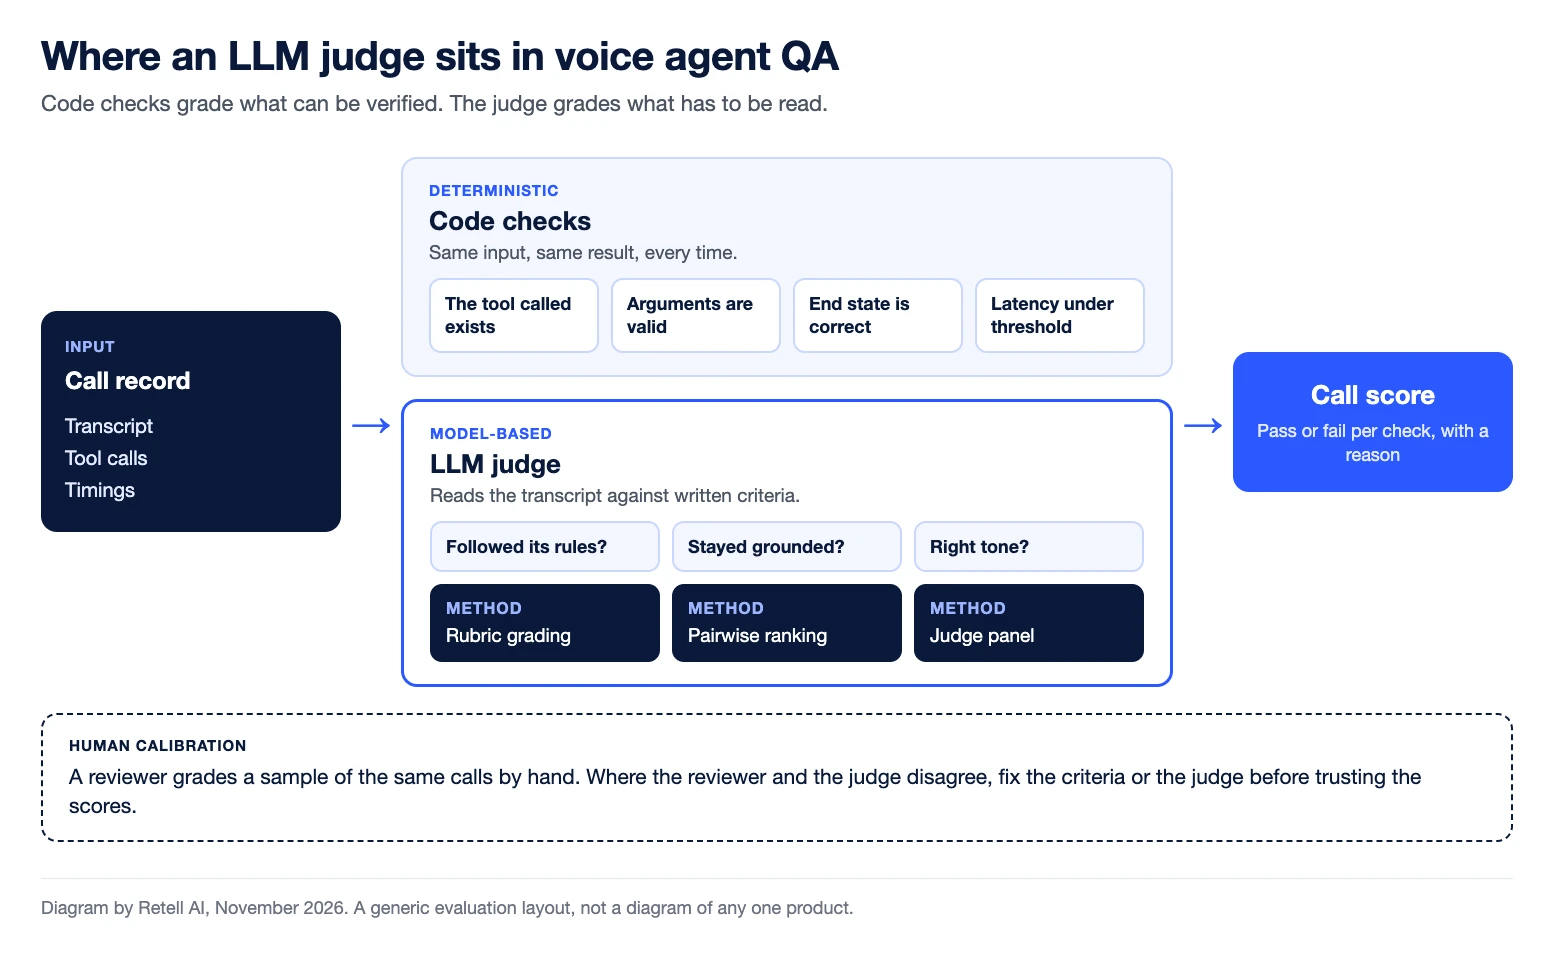
كيف يُستخدم نموذج LLM كحَكَم في QA الوكلاء الصوتيين وفي المقاييس المرجعية؟
تستخدم عمليات QA للوكلاء الصوتيين حَكَم LLM للجوانب التي لا يحسمها إلا قراءة النص المفرّغ للمكالمة: هل التزم الوكيل بقواعده، وبقي ضمن مصادره، وحلّ الطلب.
تعرض وثائق Retell كلا الإعدادين الشائعين. ففي AI QA، يُعدّ الشرط الذي يقيّمه الذكاء الاصطناعي «فحصًا نوعيًا يُجريه الذكاء الاصطناعي على النص المفرّغ لكل مكالمة وسياقها»، ويُكتب بوصفه «الـ prompt الذي يستخدمه الذكاء الاصطناعي للحكم على تحقّق الشرط». وفي اختبارات المحاكاة، يؤدّي الذكاء الاصطناعي دور المتصل و«تُقيَّم كل جولة بالنجاح أو الإخفاق مع شرح مكتوب».
وتعرض المقاييس المرجعية النوع نفسه من الأحكام على نطاق واسع. إذ ينشر Retell vCX Benchmark درجة كل مجموعة اختبارات في صورة معدّل نجاح، أي «النسبة المئوية للسيناريوهات المختبَرة التي تعامل معها بشكل صحيح»، وذلك عبر اتباع التعليمات، والاستناد إلى المصادر، واستدعاء الأدوات، والكلام العامّي (تمت القراءة في 13 نوفمبر 2026).
لتحويل الأحكام إلى مراجعة أسبوعية، اطّلع على بطاقة تقييم QA للوكلاء الصوتيين.
ما أنماط الإخفاق المعروفة لحَكَم LLM؟
يُخفق حَكَم LLM بأربع طرق موثّقة، ولكلٍّ منها فحص معروف.
- تحيّز الموضع. في ورقة Large Language Models are not Fair Evaluators، أتاح تبديل ترتيب إجابتين لنموذج واحد أن يفوز في «66 من أصل 80 استعلامًا مختبَرًا». لذا أجرِ كل مقارنة بالترتيبين كليهما.
- تفضيل الذات. وجدت دراسة صدرت عام 2024 أن المُقيِّم «يمنح مخرجاته درجات أعلى من مخرجات غيره، في حين يراها المعلّقون البشريون متساوية الجودة». استخدم حَكَمًا من عائلة نماذج مختلفة، أو لجنة حكّام.
- ضعف التوافق مع البشر. اختبرت ورقة Judging the Judges ثلاثة عشر نموذج حَكَم، ووجدت أن «النماذج الأفضل (والأكبر) وحدها تحقّق توافقًا معقولًا مع البشر»، مع «ميل إلى التساهل». قيّم عيّنة يدويًا وقارن النتائج.
- الانجراف. قد يتغيّر النموذج الذي يقف خلف API: فقد رصدت إحدى الدراسات تراجع دقة GPT-4 من 84% إلى 51% في المهمة نفسها خلال ثلاثة أشهر. والمعايير تتغيّر أيضًا؛ إذ تسمّي ورقة Who Validates the Validators? ذلك انجراف المعايير: «يحتاج المستخدمون إلى معايير لتقييم المخرجات، لكن تقييم المخرجات يساعدهم على تحديد المعايير». ثبّت إصدار الحَكَم وأعد تشغيل مجموعة ثابتة مصنّفة يدويًا بعد أي تغيير.
كما أن الحكّام ليسوا حتميّين. وتنصح وثائق المحاكاة في Retell: «احكم على السيناريو بمعدّل نجاحه عبر جولات متعددة، لا بجولة واحدة».
متى تتفوّق فحوصات الكود على حَكَم LLM؟
تتفوّق فحوصات الكود على حَكَم LLM كلما أمكن التحقق من الإجابة بدلًا من قراءتها. ويوصي دليل Anthropic لتقييم الوكلاء بـ«اختيار المُقيِّمات الحتمية حيثما أمكن، ومُقيِّمات LLM حيثما لزم». ويصف المُقيِّمات القائمة على الكود بأنها سريعة ورخيصة وموضوعية وقابلة لإعادة الإنتاج، والمُقيِّمات القائمة على النماذج بأنها غير حتمية.
في المكالمة، يمكن للكود التحقق من وجود الأداة التي استدعاها الوكيل، وصحة وسائطها، وبقاء زمن الاستجابة دون حدّ معيّن. ويقيّم tau-bench المحادثات كاملةً بهذه الطريقة، عبر مقارنة «حالة قاعدة البيانات في نهاية المحادثة بالحالة المستهدفة المُعلَّمة».
تفصل AI QA في منصّة Retell بين الاثنين: فمقاييس الأداء حدود كمّية، بينما تتضمّن الشروط التي يقيّمها الذكاء الاصطناعي الفحوصات النوعية. ويوضّح دليل كيفية اختبار تغييرات الوكيل الصوتي وإطلاقها أين يعمل كلٌّ منهما.
كيف تُستخدم لجان الحكّام في تدريب نموذج صوتي؟
استخدم Tell-1، نموذج LLM الخاص بـ Retell، حكّام LLM في مرحلتين من مراحل تدريبه الثلاث، وفقًا لـالمقال التقني عن نموذج Retell LLM. فقد تعلّمت مرحلة ضبط التفضيلات من «أزواج تفضيل رتّبتها لجنة من حكّام LLM».
وفي مرحلة التعلّم المعزّز، يقول المقال إن «النموذج يكتب ثمانية ردود وتُقيَّم جميعها». ويعمل الكود أولًا: فاستدعاءات الأدوات الواقعة خارج صندوق أدوات الوكيل، والمخرجات المشوّهة، وغيرها من الأخطاء الحرجة «تُرصد في الكود قبل أن يراها أي حَكَم». ولتقييم الصحة، «تقيّم عدة نماذج حَكَم صحة استدعاء الأدوات والهلوسة واتباع التعليمات، وتُجمَع أحكامها في إشارة مكافأة واحدة». أما الطبيعية، فيرتّب حَكَم واحد الردود الثمانية جنبًا إلى جنب وفق سُلّم معايير، لأن «مقارنة الطبيعية أسهل من منحها درجة».
وهذا هو النمط الذي تصفه هذه الصفحة: فحوصات الكود لما يمكن التحقق منه، ولجنة حكّام للصحة، والترتيب للنبرة.
الأسئلة الشائعة حول نموذج LLM كحَكَم
ماذا يفعل حَكَم LLM؟
يقرأ مُخرَجًا ما، مثل النص المفرّغ لمكالمة، إلى جانب تعليمات التقييم، ثم يُصدر حكمًا: نجاح أو إخفاق، أو درجة، أو تفضيل بين خيارين.
ما مدى موثوقية نموذج LLM كحَكَم؟
يتوقّف ذلك على نموذج الحَكَم والمهمة. فقد وجدت إحدى الدراسات اتفاقًا يتجاوز 80% مع التفضيلات البشرية، بينما وجدت أخرى أن أكبر الحكّام وحدها توافقت مع البشر بشكل معقول. تحقّق من الحَكَم أولًا بمقارنته بمكالمات مقيَّمة يدويًا.
ما لجنة الحكّام؟
لجنة الحكّام هي عدة نماذج حَكَم تقيّم المُخرَج نفسه، ثم تُجمَع أحكامها. وهي تقلّل أثر تحيّز أي نموذج منفرد.
ما الفرق بين التقييم وفق سُلّم معايير والترتيب الثنائي؟
يمنح التقييم وفق سُلّم معايير درجةً لمُخرَج واحد مقارنةً بمعايير مكتوبة. أما الترتيب الثنائي فيعرض على الحَكَم مُخرَجين ويسأله أيّهما أفضل.
هل يستطيع حَكَم LLM تقييم مكالمة صوتية؟
نعم، من خلال النص المفرّغ واستدعاءات الأدوات. أما السمات الكامنة في الصوت فتتطلّب الصوت أيضًا: إذ تذكر وثائق Retell أن Agent Naturalness «يُقيَّم باستخدام الصوت والنص المفرّغ معًا».
قيّم مكالماتك قبل التوسّع
Retell AI منصّة وكلاء صوتيين بالذكاء الاصطناعي لمراكز التواصل. وتقيّم AI QA عيّنة من مكالماتك وفق الشروط والحدود التي تضعها، مع أدلة من النص المفرّغ لكل نتيجة.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


