SSML (لغة ترميز تركيب الكلام، Speech Synthesis Markup Language) هي لغة ترميز قائمة على XML تُخبر محرك تحويل النص إلى كلام بكيفية نطق نص ما: أين يتوقف، وكيف ينطق كلمة، وكيف يقرأ رقمًا أو تاريخًا، وبأي سرعة وعلوّ وطبقة صوت يتحدث. يقرأ المحرك الوسوم بوصفها تعليمات ولا ينطقها.
SSML معيار صادر عن اتحاد شبكة الويب العالمية (W3C). وقد أصبح الإصدار الحالي، SSML 1.1، توصيةً رسمية من W3C في 7 سبتمبر 2010، وأعدّته مجموعة عمل Voice Browser التابعة لـ W3C. وتنص المواصفة على أن غرضها هو منح المؤلفين «طريقة قياسية للتحكم في جوانب الكلام مثل النطق ومستوى الصوت وطبقته والسرعة وغيرها عبر منصات مختلفة قادرة على تركيب الكلام».
كيف يبدو SSML؟
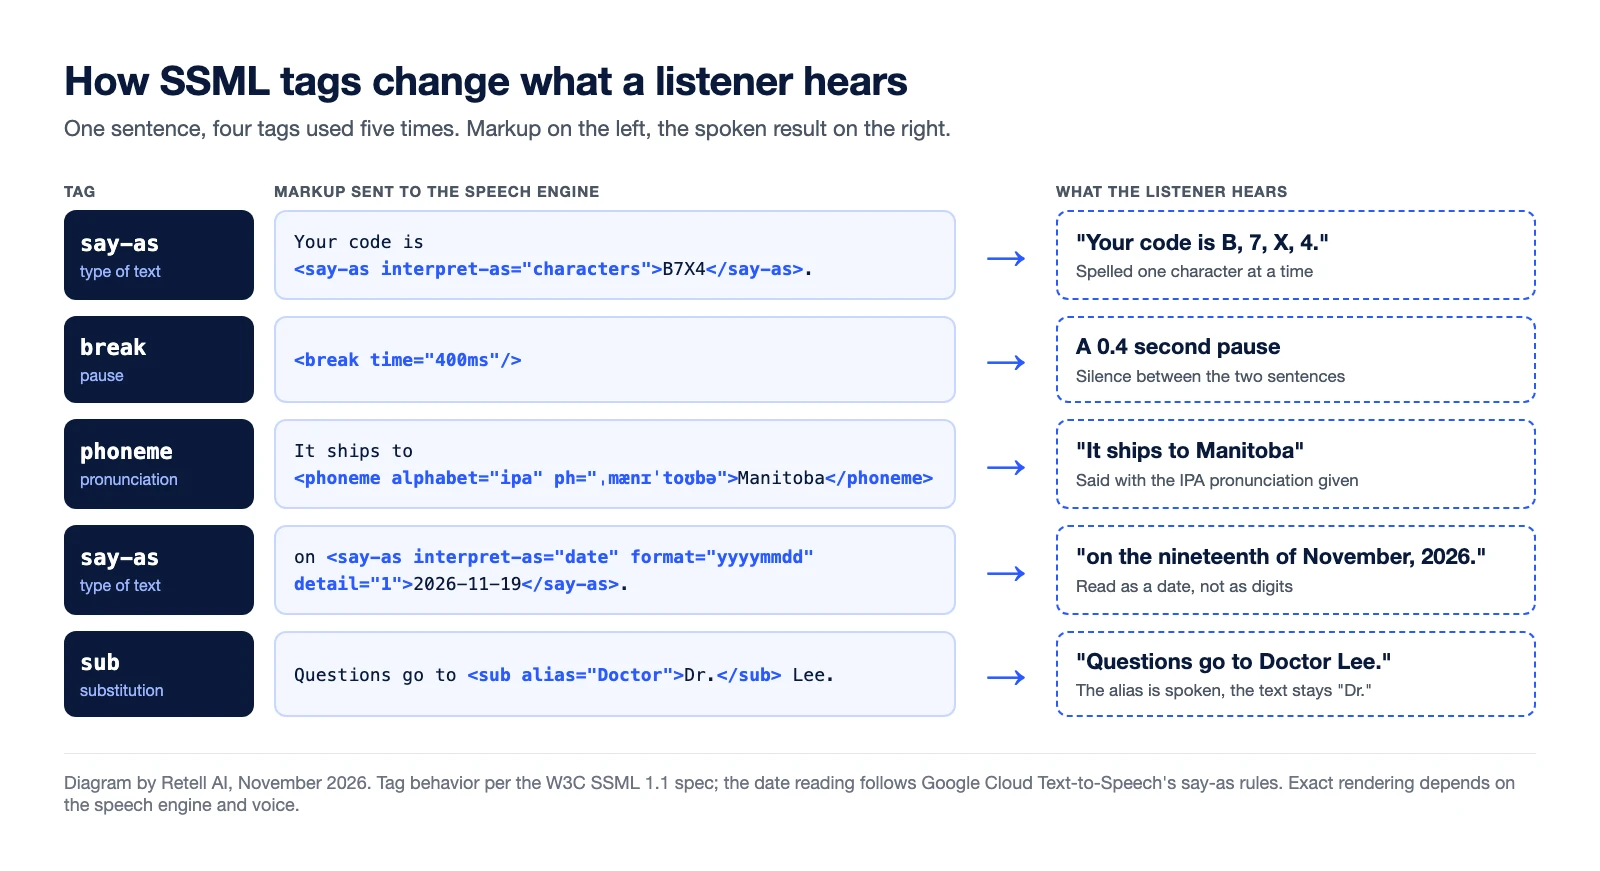
مستند SSML هو مستند XML بعنصر جذري واحد هو <speak>. هذا المثال القصير صالح وفق SSML 1.1:
<speak version="1.1" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="en-US">
  Your code is <say-as interpret-as="characters">B7X4</say-as>.
  <break time="400ms"/>
  It ships to <phoneme alphabet="ipa" ph="ˌmænɪˈtoʊbə">Manitoba</phoneme>
  on <say-as interpret-as="date" format="yyyymmdd" detail="1">2026-11-19</say-as>.
  Questions go to <sub alias="Doctor">Dr.</sub> Lee.
</speak>
يوضّح الشكل ما يسمعه المستمع عند كل وسم حين يدعمه المحرك.
ما أكثر وسوم SSML شيوعًا؟
الأوصاف مأخوذة من مواصفة W3C.
| الوسم | وظيفته | مثال |
|---|---|---|
<speak> | العنصر الجذري لكل مستند SSML. في SSML 1.1 تكون السمتان version وxml:lang إلزاميتين، إضافةً إلى نطاق أسماء SSML. | <speak version="1.1" xml:lang="en-US"> |
<break> | يضيف توقفًا أو حدًّا نغميًا، يُحدَّد عبر strength (من none إلى x-strong) أو عبر time. | <break time="400ms"/> |
<say-as> | يُخبر المحرك بنوع النص الذي يقرؤه، مثل تاريخ أو وقت أو رقم أو مبلغ مالي. | <say-as interpret-as="characters">B7X4</say-as> |
<phoneme> | يقدّم نطقًا صوتيًا للنص المحاط به. وتنص المواصفة على أنه ينبغي للمحركات دعم الأبجدية ipa. | <phoneme alphabet="ipa" ph="..."> |
<sub> | ينطق قيمة alias بدلًا من النص المكتوب. | <sub alias="Doctor">Dr.</sub> |
<prosody> | يغيّر طبقة الصوت وسرعة الكلام ومستوى الصوت للنص المحاط به. | <prosody rate="slow"> |
<emphasis> | يطلب التشديد على كلمة أو عبارة، بقيمة level هي strong أو moderate أو none أو reduced. | <emphasis level="strong"> |
تفسّر تفصيلتان في المواصفة سبب تفاوت النتائج. أولًا، تُعرّف المواصفة <say-as> لكنها «لا تُعدّد القيم الممكنة للسمات»، لذا فإن قائمة قيم interpret-as خاصة بكل مزوّد. ثانيًا، تصف قيم prosody بأنها «إرشادية» وتترك للمحرك تحديد طريقة أداء التشديد.
أين يختلف دعم SSML بين محركات الكلام؟
يطبّق كل محرك مجموعة فرعية خاصة به، وغالبًا ما تدعم نماذج الصوت الأحدث ترميزًا أقل من النماذج الأقدم. وفقًا لوثائق كل مزوّد كما اطُّلع عليها في 13 نوفمبر 2026:
- Google Cloud Text-to-Speech يدعم «مجموعة فرعية من وسوم SSML المتاحة». وتقبل أصوات Chirp 3: HD لديه عشرة وسوم من دون
<emphasis>، أما الوسوم الأخرى «فسيتم تجاهلها»، ولا تقبل طلبات البث أي SSML. - Amazon Polly يسرد دعم الوسوم حسب نوع الصوت. الوسم
<emphasis>غير متاح في الأصوات neural أو long-form أو generative، ويؤدي استخدام وسم غير مدعوم في الأصوات standard أو neural أو long-form إلى إرجاع خطأ. - Azure AI Speech يبني تطبيقه على SSML 1.0 ويذكر أن العناصر المدعومة لديه «قد تختلف عن معيار W3C». ويضيف عناصر
msttsخاصة به لأنماط التحدث، ويعمل التشديد على مستوى الكلمة مع ثلاثة أصوات إنجليزية محددة. - ElevenLabs يدعم وسمَين من وسوم SSML في بعض النماذج:
<break>للتوقفات حتى 3 ثوانٍ، و<phoneme>في Flash v2 فقط. ولا يدعم Eleven v3 وv4 وسوم break. - Cartesia Sonic يوثّق وسومًا «شبيهة بـ SSML» خاصة به: speed وvolume وemotion وbreak وspell.
قد يلتزم محرك ما بالمستند نفسه، ويتجاهله آخر بصمت، ويرفضه ثالث. اختبر الترميز على الصوت والنموذج نفسيهما اللذين ستشغّلهما.
لماذا يهم SSML للوكلاء الصوتيين؟
لا يستطيع المتصل رؤية النص. وفي الذكاء الاصطناعي الصوتي، تكلّف القراءة الخاطئة تكرارًا أو سجلًا خاطئًا:
- الأسماء. نطق أسماء العلامات التجارية والأدوية والعائلات الذي يخطئ الصوت في تخمينه.
- الأرقام. رمز تأكيد يُقرأ ككلمة واحدة، أو رقم حساب يُقرأ ككمية.
- التواريخ والأوقات. تاريخ مثل 11/19 يُقرأ كرقمين منفصلين.
- التوقفات. وقت كافٍ لتدوين كل مجموعة من أرقام الهاتف.
يناسب SSML عبارات prompt المُعدّة مسبقًا، حيث يضع المطوّر الوسوم على كل سطر مرة واحدة. وهذا يلائم قائمة IVR، لكنه أقل ملاءمة لـوكيل صوتي بالذكاء الاصطناعي يعمل مباشرة.
كيف يتعامل الوكلاء الصوتيون المعتمدون على LLM مع النطق دون SSML؟
في الوكيل المعتمد على LLM، يكتب نموذج لغوي كبير كل ردّ أثناء المكالمة، ويتدفق النص إلى محرك الكلام فور توليده (كيف يعمل مسار STT وLLM وTTS). لا أحد يضع الوسوم على الجمل يدويًا، ويضيف البث عقبة أخرى: إذ تحذّر وثائق Cartesia من أن وسم السرعة أو مستوى الصوت المقسّم عبر tokens متدفقة يُقرأ بصوت مسموع. لذا تستخدم الفرق بدلًا من ذلك أربع طرق:
- صياغة prompt لنص قابل للنطق. وجّه النموذج لكتابة «أربعة واحد خمسة» بدلًا من «415».
- تطبيع النص. خطوة تسبق التركيب تحوّل الأرقام والتواريخ والعملات إلى صيغة منطوقة.
- قاموس النطق. قائمة كلمات بتهجئات صوتية تُطبَّق على كل ردّ.
- عناصر التحكم في الكلام على مستوى المنصة. علامات مضمّنة تترجمها المنصة لكل مزوّد صوت.
كيف تتعامل منصّة Retell AI مع التوقفات والنطق؟
لا تصف وثائق Retell AI إدخال SSML الخام، بل توثّق عناصر التحكم التالية:
- التوقفات والتهجئة. وفقًا لـوثائق عناصر التحكم في الكلام، تضيف الشَّرطة المحاطة بمسافة على كل جانب توقفًا، وتقرأ وسوم
<spell>الرمز أو رقم الحساب حرفًا حرفًا. وتحوّل منصّة Retell الوسم «إلى الصيغة الأنسب لصوت وكيلك». - قاموس النطق. تتضمن الإدخالات كلمةً ونطقًا صوتيًا بصيغة IPA أو CMU أو Pinyin أو Jyutping. تقبل أصوات منصّة Retell صيغتي IPA وCMU، بينما لا تقبل بعض نماذج المزوّدين أيًّا منها.
- Speech Normalization (تطبيع الكلام). إعداد مسبق في Agent Handbook، معطّل افتراضيًا، يحوّل الأرقام والتواريخ والمبالغ المالية وأرقام الهواتف إلى صيغة منطوقة.
انظر أيضًا كيف يعمل الوكلاء الصوتيون بالذكاء الاصطناعي أثناء المكالمة.
الأسئلة الشائعة حول SSML
فيمَ يُستخدم SSML؟
يتحكم في كيفية قراءة محرك تحويل النص إلى كلام للنص بصوت مسموع: التوقفات، والنطق، وقراءة الأرقام والتواريخ، وطبقة الصوت وسرعته ومستواه.
هل SSML هو نفسه في كل محركات تحويل النص إلى كلام؟
لا. يدعم كل محرك مجموعة فرعية خاصة به من مواصفة W3C ويضيف وسومه الخاصة، لذا غالبًا ما يحتاج الترميز إلى تعديلات عند الانتقال بين المحركات.
هل يدعم ElevenLabs لغة SSML؟
جزئيًا. تصف وثائقه وسوم break للتوقفات حتى 3 ثوانٍ ووسوم phoneme في نموذج Flash v2. ولا يدعم Eleven v3 وv4 وسوم break (حتى نوفمبر 2026).
ما الفرق بين SSML وقاموس النطق؟
توضع وسوم SSML داخل نص بعينه ولا تُطبَّق إلا عليه. أما قاموس النطق فهو قائمة كلمات منفصلة يطبّقها المحرك أو المنصة على كل كلمة مطابقة.
هل يستخدم الوكلاء الصوتيون بالذكاء الاصطناعي SSML؟
بعضهم يستخدمه حيث يقبله محرك الكلام. ويعتمد كثيرون على صياغة prompt وتطبيع النص وقواميس النطق، لأن الردود تُولَّد مباشرةً وبعض نماذج الصوت الأحدث لا تقبل إلا القليل من SSML.
اجعل كل اسم ورقم يُنطق بشكل صحيح
تُعدّ Retell AI منصّةً للوكلاء الصوتيين بالذكاء الاصطناعي مخصّصة لمراكز التواصل. يمكنك التحكم في التوقفات والتهجئة والنطق لكل وكيل، والاستماع إلى النتيجة في اختبار مكالمة ويب. تواصل مع فريق Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


