Η διαπλεκόμενη συλλογιστική (interleaved reasoning) είναι ένας τρόπος λειτουργίας ενός μοντέλου συλλογιστικής, κατά τον οποίο το μοντέλο εναλλάσσει την ιδιωτική συλλογιστική με ορατές ενέργειες, όπως κλήσεις εργαλείων ή τμήματα της απάντησής του, αντί να ολοκληρώνει όλη τη συλλογιστική του πριν απαντήσει.
Ονομάζεται επίσης διαπλεκόμενη σκέψη (interleaved thinking). Η τεκμηρίωση των παρόχων χρησιμοποιεί τον όρο κυρίως για τη συλλογιστική ανάμεσα σε κλήσεις εργαλείων. Οι ερευνητικές δημοσιεύσεις τον χρησιμοποιούν για ένα μοντέλο που εναλλάσσει τη σκέψη με τμήματα της απάντησής του. Και οι δύο περιγράφουν την ίδια αλλαγή: η συλλογιστική παύει να είναι ένα ενιαίο μπλοκ στην αρχή του γύρου.
Τι είναι ένα μοντέλο συλλογιστικής;
Ένα μοντέλο συλλογιστικής είναι ένα μεγάλο γλωσσικό μοντέλο που παράγει ενδιάμεση συλλογιστική πριν από την απάντησή του. Ο οδηγός συλλογιστικής της OpenAI το συνοψίζει σε μία γραμμή: «Τα μοντέλα συλλογιστικής χρησιμοποιούν εσωτερικά tokens συλλογιστικής πριν παραγάγουν μια απόκριση.» Η τεκμηρίωση του Gemini της Google αναφέρει ότι ένα μοντέλο σκέψης «συλλογίζεται εσωτερικά πριν απαντήσει», ενώ η τεκμηρίωση της DeepSeek αναφέρει ότι η λειτουργία σκέψης της παράγει συλλογιστική αλυσίδας σκέψης (chain-of-thought) «για να βελτιώσει την ακρίβεια της τελικής απόκρισης».
Τι είναι τα tokens συλλογιστικής;
Τα tokens συλλογιστικής, που ονομάζονται επίσης tokens σκέψης, είναι τα tokens που παράγει ένα μοντέλο ενώ επεξεργάζεται ένα πρόβλημα. Δεν αποτελούν μέρος της απάντησης. Τρεις ιδιότητες έχουν σημασία:
- Χρεώνονται. Η OpenAI αναφέρει ότι τα tokens συλλογιστικής «χρεώνονται ως tokens εξόδου». Η τεκμηρίωση σκέψης της Anthropic αναφέρει το ίδιο για το Claude, «ακόμη και όταν το κείμενο σκέψης δεν σας επιστρέφεται». Η Google τιμολογεί μια απόκριση ως «το άθροισμα των tokens εξόδου και των tokens σκέψης».
- Συχνά είναι κρυφά. Τα tokens συλλογιστικής της OpenAI «δεν είναι ορατά μέσω του API». Η Anthropic αναφέρει ότι αυτό που βλέπετε «δεν είναι ποτέ η ακατέργαστη αλυσίδα σκέψης». Και οι δύο μπορούν να επιστρέψουν μια σύνοψη, εφόσον τη ζητήσετε.
- Απαιτούν χρόνο και χώρο. Η OpenAI αναφέρει ότι ένα μοντέλο μπορεί να παραγάγει «από μερικές εκατοντάδες έως δεκάδες χιλιάδες tokens συλλογιστικής» σε ένα μόνο αίτημα, και αυτά καταλαμβάνουν το παράθυρο περιβάλλοντος (context window).
Οι developers ελέγχουν την ποσότητα μέσω μιας ρύθμισης: reasoning effort στην OpenAI, effort στην Anthropic, thinking level στην Google.
Σε τι διαφέρει η διαπλεκόμενη συλλογιστική από τη συλλογιστική «πρώτα σκέψη»;
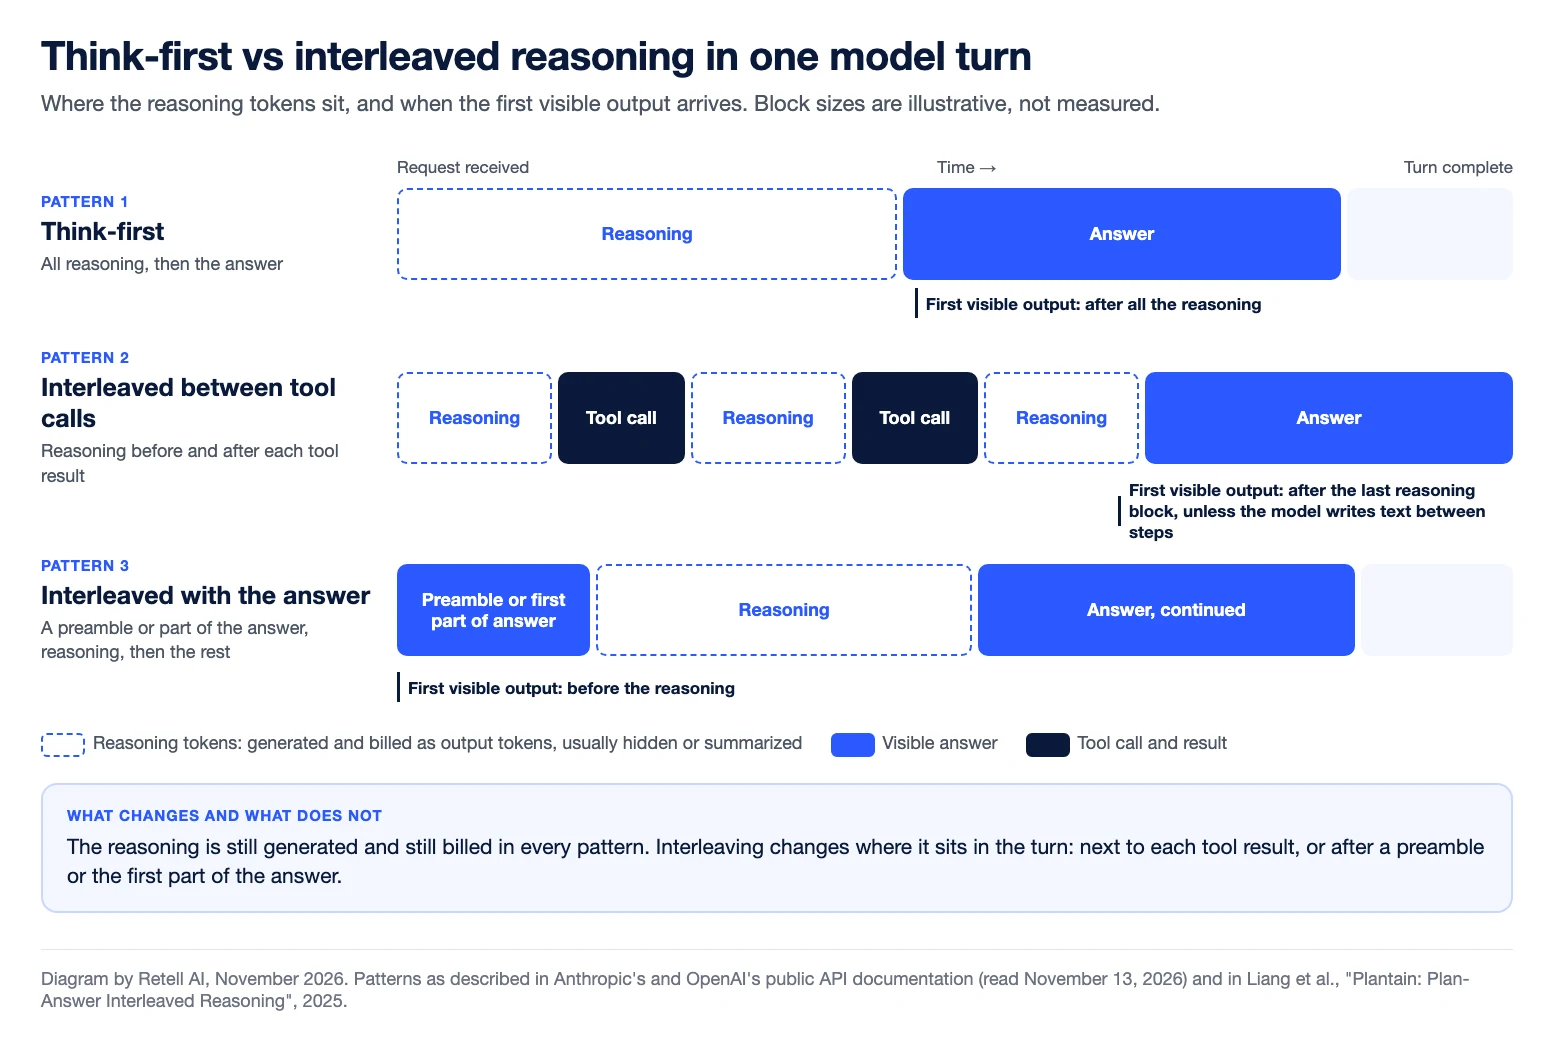
Στη συλλογιστική «πρώτα σκέψη» (think-first), όλη η συλλογιστική γίνεται πριν από το πρώτο ορατό token. Η Anthropic την ονομάζει εκ των προτέρων σκέψη (up-front thinking): τα μπλοκ σκέψης «φτάνουν πριν από τα μπλοκ κειμένου». Η διαπλεκόμενη συλλογιστική χωρίζει τη συλλογιστική σε μικρότερα μπλοκ και τα τοποθετεί εκεί όπου χρειάζονται.
| Μοτίβο | Σειρά εργασιών σε έναν γύρο | Τι βλέπει πρώτα ο χρήστης | Δημόσια περιγραφή από |
|---|---|---|---|
| Χωρίς συλλογιστική | Απάντηση | Η αρχή της απάντησης | Οποιοδήποτε μοντέλο με απενεργοποιημένη συλλογιστική |
| Πρώτα σκέψη | Όλη η συλλογιστική, μετά η απάντηση | Τίποτα μέχρι να ολοκληρωθεί η συλλογιστική | Anthropic (up-front thinking), DeepSeek |
| Διαπλεκόμενη ανάμεσα σε κλήσεις εργαλείων | Συλλογιστική, κλήση εργαλείου, ανάγνωση του αποτελέσματος, νέα συλλογιστική, μετά απάντηση | Τίποτα μέχρι να ολοκληρωθεί το τελευταίο μπλοκ συλλογιστικής, εκτός αν το μοντέλο γράψει κείμενο ανάμεσα στα βήματα | Anthropic, OpenAI, vLLM, DeepSeek (χωρίς τον όρο) |
| Διαπλεκόμενη με την απάντηση | Ένα προοίμιο ή τμήμα της απάντησης, συλλογιστική, συνέχεια της απάντησης | Ένα προοίμιο ή ένα πρώιμο τμήμα της απάντησης | OpenAI, ερευνητικές δημοσιεύσεις |
| Διαπλεκόμενη με την ομιλία | Πρώτη πρόταση της απάντησης, σιωπηλή συλλογιστική όσο αυτή ακούγεται, μετά το υπόλοιπο της απάντησης | Η πρώτη πρόταση της απάντησης | Tell-1, το δικό LLM της Retell |
Τι τεκμηριώνουν σήμερα οι πάροχοι;
Σύμφωνα με την τεκμηρίωση στις 13 Νοεμβρίου 2026:
- Anthropic. «Η διαπλεκόμενη σκέψη επιτρέπει στο Claude να σκέφτεται ανάμεσα σε κλήσεις εργαλείων, συλλογιζόμενο κάθε αποτέλεσμα εργαλείου πριν ενεργήσει με βάση αυτό.» Ενεργοποιείται αυτόματα στα μοντέλα που υποστηρίζουν adaptive thinking. Τα μοντέλα με χειροκίνητο extended thinking χρειάζονται ένα beta header.
- OpenAI. Μοντέλα όπως το gpt-5.5 «υποστηρίζουν διαπλεκόμενη σκέψη, όπου το μοντέλο μπορεί να παραγάγει ορατά tokens εξόδου πριν από τη σκέψη και ανάμεσά της, καθώς και να σκέφτεται ανάμεσα σε κλήσεις εργαλείων».
- Google. Η σελίδα σκέψης του Gemini δεν χρησιμοποιεί τον όρο. Αναφέρει ότι τα βήματα σκέψης «εμφανίζονται χρονολογικά μαζί με κλήσεις συναρτήσεων, εισόδους χρήστη ή εξόδους του μοντέλου» και ότι οι υπογραφές σκέψης (thought signatures) «απαιτούνται για τη διατήρηση της συνέχειας της συλλογιστικής σε αλληλεπιδράσεις πολλών γύρων».
- vLLM. Ο server συμπερασμού ανοιχτού κώδικα υποστηρίζει διαπλεκόμενη σκέψη για δύο σειρές μοντέλων και προειδοποιεί ότι «αυξάνει τη χρήση tokens και την καθυστέρηση απόκρισης».
Στην έρευνα, οι Xie et al. (2025) εκπαίδευσαν μοντέλα «να εναλλάσσουν τη σκέψη με την απάντηση» και αναφέρουν μείωση του χρόνου μέχρι το πρώτο token κατά περισσότερο από 80% κατά μέσο όρο. Οι Liang et al. (2025) ορίζουν τη διαπλεκόμενη συλλογιστική ως ένα μοντέλο που «εναλλάσσει τη σκέψη με την εμφάνιση ενδιάμεσων αποκρίσεων» και αναφέρουν ότι η παραλλαγή τους με προτεραιότητα στον σχεδιασμό, το Plantain, μείωσε τον χρόνο μέχρι την πρώτη απόκριση κατά περισσότερο από 60%. Και οι δύο μελέτες αφορούσαν εργασίες κειμένου.
Γιατί η συλλογιστική «πρώτα σκέψη» προκαλεί σιωπή σε μια τηλεφωνική κλήση;
Σε μια τηλεφωνική κλήση, η σύνθεση ομιλίας δεν μπορεί να ξεκινήσει μέχρι το μοντέλο να παραγάγει τις πρώτες λέξεις της απάντησής του. Κάθε token συλλογιστικής που παράγεται πριν από αυτές τις λέξεις είναι χρόνος κατά τον οποίο ο καλών δεν ακούει τίποτα. Σε ένα παράθυρο συνομιλίας, η ίδια αναμονή εμφανίζεται ως ένδειξη προόδου. Σε μια κλήση, είναι νεκρός χρόνος και πρόσθετη καθυστέρηση (latency).
Η τεκμηρίωση αντιμετώπισης προβλημάτων καθυστέρησης της Retell αναφέρει ότι τα μεγαλύτερα μοντέλα, προσανατολισμένα στη συλλογιστική, «είναι πιο αργά μέχρι το πρώτο token» και «ανταλλάσσουν καθυστέρηση με δυνατότητες». Η OpenAI αναφέρει τη φωνή ως συνήθη περίπτωση χρήσης για λειτουργία με το reasoning effort ρυθμισμένο σε none και προτείνει οι εφαρμογές που είναι ευαίσθητες στην καθυστέρηση να «ζητούν από το μοντέλο να παραγάγει ένα σύντομο προοίμιο πριν συνεχίσει με βαθύτερη συλλογιστική». Ο οδηγός για το καλύτερο LLM για φωνητικούς πράκτορες AI καλύπτει την επιλογή μοντέλου.
Τι είναι η διαπλεκόμενη συλλογιστική σε έναν φωνητικό πράκτορα;
Σε έναν φωνητικό πράκτορα, η διαπλεκόμενη συλλογιστική σημαίνει ότι το μοντέλο γράφει αμέσως την πρώτη πρόταση της απάντησής του, συλλογίζεται σιωπηλά όσο αυτή η πρόταση εκφωνείται και στη συνέχεια ολοκληρώνει την απάντηση με βάση αυτή τη συλλογιστική. Ο καλών ακούει μία αδιάσπαστη απάντηση και η συλλογιστική δεν εκφωνείται ποτέ.
Το Tell-1 λειτουργεί με αυτόν τον τρόπο. Η τεχνική δημοσίευση της Retell, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, περιγράφει τη μορφή ως «μια εκφωνούμενη εισαγωγή, μετά συλλογιστική, μετά το υπόλοιπο της απάντησης». Η δημοσίευση αναφέρει κατά μέσο όρο 200 tokens συλλογιστικής στη μέση της απάντησης και ότι στο 99,98% των γύρων η παύση μετά την πρώτη πρόταση είναι μικρότερη από 400 ms.
Σε σύγκριση με τη συλλογιστική «πρώτα σκέψη», ο καλών δεν περιμένει σιωπηλά να ολοκληρωθεί η συλλογιστική. Η δημοσίευση αναφέρει επίσης το αντιστάθμισμα: «το να μιλάς νωρίτερα σημαίνει ότι δεσμεύεσαι στην εισαγωγή πριν γίνει οποιαδήποτε συλλογιστική». Το Tell-1 κατατάσσεται #1 συνολικά στο Retell vCX Benchmark (στοιχεία Νοεμβρίου 2026).
Συχνές ερωτήσεις για τη διαπλεκόμενη συλλογιστική
Είναι η διαπλεκόμενη συλλογιστική το ίδιο με τη διαπλεκόμενη σκέψη;
Ναι, στις περισσότερες χρήσεις. Η Anthropic και η OpenAI μιλούν για interleaved thinking (διαπλεκόμενη σκέψη)· οι ερευνητικές δημοσιεύσεις τείνουν να χρησιμοποιούν τον όρο interleaved reasoning (διαπλεκόμενη συλλογιστική).
Χρεώνονται τα tokens συλλογιστικής;
Ναι. Η OpenAI, η Anthropic και η Google τα προσμετρούν στα χρεούμενα tokens εξόδου. Η OpenAI και η Anthropic τα χρεώνουν ακόμη και όταν το κείμενο της συλλογιστικής δεν επιστρέφεται.
Μπορείτε να διαβάσετε τα tokens συλλογιστικής ενός μοντέλου;
Συνήθως όχι. Η OpenAI και η Anthropic μπορούν να επιστρέψουν μια σύνοψη, εφόσον τη ζητήσετε. Καμία δεν επιστρέφει την ακατέργαστη συλλογιστική.
Κάνει η διαπλεκόμενη συλλογιστική ένα μοντέλο να απαντά πιο γρήγορα;
Όχι από μόνη της. Ανάμεσα σε κλήσεις εργαλείων προσθέτει tokens, και η τεκμηρίωση του vLLM προειδοποιεί ότι αυξάνει την καθυστέρηση απόκρισης. Η πρώτη ορατή έξοδος φτάνει νωρίτερα μόνο όταν η ορατή έξοδος προηγείται της συλλογιστικής ή παρεμβάλλεται ανάμεσα σε μικρότερα μπλοκ της.
Τι είναι η διαπλεκόμενη συλλογιστική στο φωνητικό AI;
Είναι ένα μοντέλο που αρχίζει να μιλά αμέσως, συλλογίζεται σιωπηλά όσο ακούγεται η πρώτη του πρόταση και στη συνέχεια ολοκληρώνει την απάντηση αξιοποιώντας αυτή τη συλλογιστική. Το Tell-1, το δικό LLM της Retell, είναι κατασκευασμένο με αυτόν τον τρόπο.
Χρησιμοποιήστε μοντέλα συλλογιστικής σε ζωντανές κλήσεις
Η Retell AI είναι μια πλατφόρμα φωνητικών πρακτόρων AI για κέντρα επικοινωνίας. Εσείς επιλέγετε το μοντέλο πίσω από κάθε πράκτορα. Το Tell-1 είναι ένα από αυτά. Μιλήστε με την ομάδα της Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


