Ο χρόνος έως το πρώτο token (TTFT) είναι ο χρόνος που μεσολαβεί από την αποστολή ενός αιτήματος σε ένα μεγάλο γλωσσικό μοντέλο (LLM) έως τη λήψη του πρώτου token της απάντησής του. Μετρά πόσο γρήγορα ένα μοντέλο αρχίζει να απαντά, όχι πόση ώρα διαρκεί η απάντηση.
Ο οδηγός benchmarking της NVIDIA τον ορίζει ως «τον χρόνο από την υποβολή του ερωτήματος έως το πρώτο token που λαμβάνεται». Σε μια τηλεφωνική κλήση, το TTFT είναι ένα μέρος της καθυστέρησης (latency) που ακούει ο καλών. Πάνω σε αυτό βασίζονται δύο ακόμη μετρικές: ο χρόνος έως την πρώτη πρόταση και η συνολική (end-to-end) φωνητική καθυστέρηση.
Τι περιλαμβάνει το TTFT;
Το TTFT καλύπτει όλα όσα συμβαίνουν πριν το μοντέλο στείλει (stream) το πρώτο του token. Η IBM απαριθμεί τέσσερα σκέλη: καθυστέρηση αναμονής στην ουρά, χρόνο prefill (επεξεργασία του prompt), παραγωγή του πρώτου token και επιβάρυνση δικτύου και API.
Η IBM χαρακτηρίζει το prefill «συχνά τον μεγαλύτερο παράγοντα του TTFT, ειδικά για μεγαλύτερα prompts». Το μοντέλο διαβάζει ολόκληρο το prompt πριν γράψει οτιδήποτε, οπότε μεγαλύτερο prompt σημαίνει μεγαλύτερη αναμονή. Σημασία έχει και το φορτίο. Η τεκμηρίωση της Anyscale σημειώνει ότι ένας server υπό έντονη χρήση μπορεί να βάζει τα εισερχόμενα αιτήματα σε ουρά, και αυτή η αναμονή προστίθεται στο TTFT.
Πώς μετράτε το TTFT;
- TTFT = χρονική στιγμή λήψης του πρώτου token μείον χρονική στιγμή αποστολής του αιτήματος
Τρεις επιλογές αλλάζουν το αποτέλεσμα. Αναφέρετέ τες μαζί με κάθε τιμή TTFT:
- Πού βρίσκεται το χρονόμετρο. Όταν μετράται στον client, το TTFT περιλαμβάνει τον χρόνο δικτύου. Όταν μετράται μέσα στον server του μοντέλου, δεν τον περιλαμβάνει.
- Ποιο εκατοστημόριο. Η διάμεσος (P50) δείχνει το τυπικό αίτημα. Τα P90 και P99 δείχνουν τα αργά.
- Πόσο φορτίο. Ένα μεμονωμένο αίτημα σε αδρανή server είναι η καλύτερη περίπτωση. Σε παραγωγή, όπως σημειώνει η NVIDIA, το prefill ενός αιτήματος μπορεί να επικαλύπτεται με την παραγωγή ενός άλλου.
Πώς διαφέρουν το TTFT, ο χρόνος έως την πρώτη πρόταση και η συνολική καθυστέρηση σε μια τηλεφωνική κλήση;
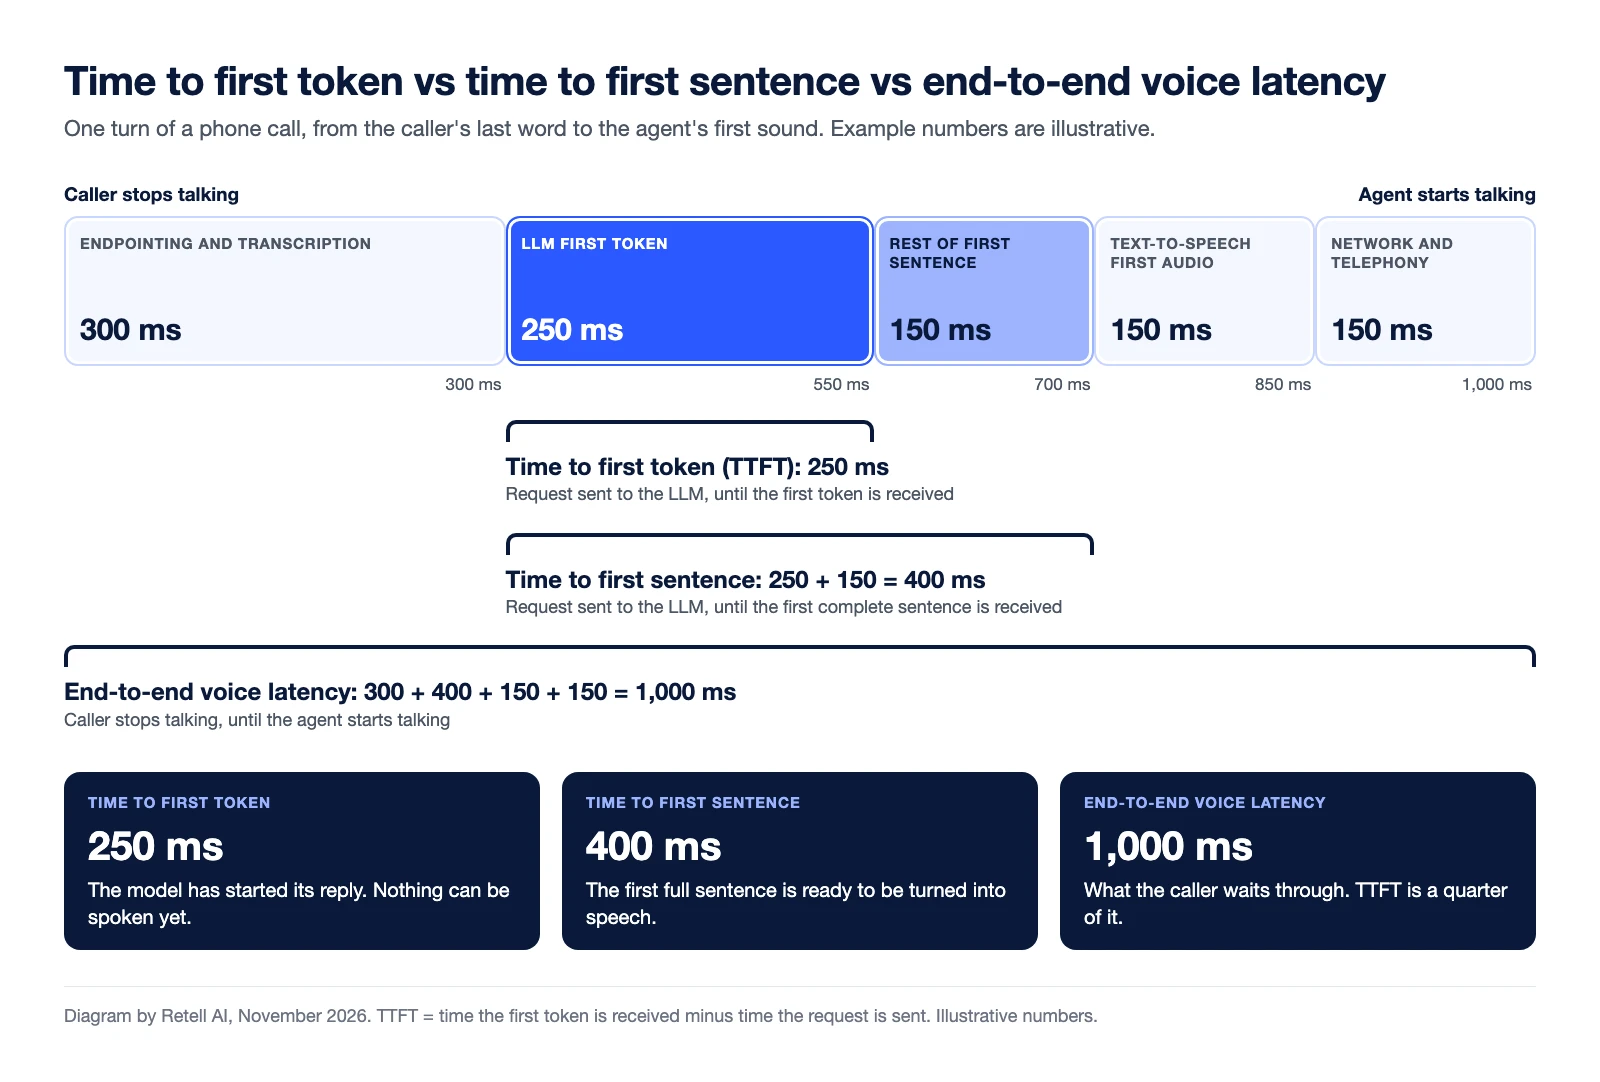
Το TTFT σταματά στο πρώτο token. Ο χρόνος έως την πρώτη πρόταση σταματά όταν έχει φτάσει μια ολοκληρωμένη πρόταση. Η συνολική φωνητική καθυστέρηση καλύπτει ολόκληρο το κενό που ακούει ο καλών.
Ο καλών δεν ακούει ποτέ ένα token. Οι βέλτιστες πρακτικές της Retell για προσαρμοσμένο LLM αναφέρουν: «Η Retell αρχίζει να μιλά μόλις λάβει την πρώτη σας ολοκληρωμένη πρόταση». Ο αριθμός που μετρά εκεί είναι «ο χρόνος έως το πρώτο token συν τον χρόνο ολοκλήρωσης αυτής της πρώτης πρότασης».
Η τεκμηρίωση της Retell για την καθυστέρηση μετρά τη συνολική καθυστέρηση «από τη στιγμή που ο χρήστης σταματά να μιλά έως τη στιγμή που ο πράκτορας αρχίζει να μιλά».
| Μετρική | Το χρονόμετρο ξεκινά | Το χρονόμετρο σταματά | Δεν περιλαμβάνει |
|---|---|---|---|
| Χρόνος έως το πρώτο token (TTFT) | Αποστολή αιτήματος στο LLM | Λήψη πρώτου token | Το υπόλοιπο της πρώτης πρότασης, αναγνώριση ομιλίας, σύνθεση ομιλίας |
| Χρόνος έως την πρώτη πρόταση | Αποστολή αιτήματος στο LLM | Λήψη πρώτης ολοκληρωμένης πρότασης | Αναγνώριση ομιλίας, σύνθεση ομιλίας, τηλεφωνία |
| Συνολική φωνητική καθυστέρηση | Ο καλών σταματά να μιλά | Ο πράκτορας αρχίζει να μιλά | Τίποτα από τη ροή επεξεργασίας. Ελέγξτε αν η τιμή περιλαμβάνει το σκέλος δικτύου προς τον καλούντα |
Μια παγίδα ορολογίας: στο benchmarking των LLM, η συνολική καθυστέρηση (end-to-end latency) φτάνει έως το τελευταίο token. Η NVIDIA την ορίζει ως «πόσο χρόνο χρειάζεται από την υποβολή ενός ερωτήματος έως τη λήψη της πλήρους απάντησης».
Παράδειγμα (ενδεικτικοί αριθμοί). Ένας γύρος μιας κλήσης:
- Endpointing και μεταγραφή: 300 ms
- Πρώτο token του LLM: 250 ms
- Υπόλοιπο της πρώτης πρότασης: 150 ms (15 ακόμη tokens στα 10 ms το καθένα)
- Πρώτος ήχος από τη μετατροπή κειμένου σε ομιλία: 150 ms
- Δίκτυο και τηλεφωνία: 150 ms
Το TTFT είναι 250 ms. Ο χρόνος έως την πρώτη πρόταση είναι 250 + 150 = 400 ms. Η συνολική φωνητική καθυστέρηση είναι 300 + 400 + 150 + 150 = 1.000 ms, άρα το TTFT αντιστοιχεί στο ένα τέταρτο της αναμονής του καλούντα. Ο οδηγός μας για τα benchmarks καθυστέρησης του φωνητικού AI χρησιμοποιεί τον ίδιο προϋπολογισμό χρόνου.
Γιατί το TTFT μπορεί να είναι παραπλανητικό όταν συγκρίνετε μοντέλα;
Μια τιμή TTFT συγκρίνεται μόνο με μια άλλη τιμή TTFT που μετρήθηκε με τον ίδιο τρόπο. Αν βάλετε το TTFT ενός μοντέλου απέναντι στον χρόνο έως την πρώτη πρόταση ενός άλλου, το πρώτο θα φαίνεται πάντα ταχύτερο. Το ίδιο ισχύει για τον χρόνο μόνο του μοντέλου σε σύγκριση με τον χρόνο που μετρήθηκε σε ζωντανή κλήση, καθώς και για τη διάμεσο σε σύγκριση με το P99.
Ένα μοντέλο μπορεί επίσης να στείλει γρήγορα το πρώτο του token και μετά να συνεχίσει αργά, αφήνοντας και πάλι τον καλούντα σε σιωπή.
Πώς μειώνετε το TTFT σε έναν φωνητικό πράκτορα;
Ο οδηγός αντιμετώπισης προβλημάτων καθυστέρησης της Retell αναφέρει την επιλογή μοντέλου και το μήκος του prompt ως τις δύο πιο συνηθισμένες αιτίες υψηλής καθυστέρησης.
- Επιλέξτε ένα ταχύτερο μοντέλο. Το Tell-1 είναι μια επιλογή σχεδιασμένη για κλήσεις. Σύμφωνα με τον οδηγό, τα μεγαλύτερα μοντέλα με έμφαση στη συλλογιστική «είναι πιο αργά έως το πρώτο token».
- Συντομεύστε το prompt. «Κάθε token στο prompt σας προσθέτει χρόνο στο time-to-first-token», σε κάθε γύρο. Τα prompts πάνω από περίπου 8k tokens γίνονται αισθητά πιο αργά.
- Μεταδώστε την απάντηση σε ροή (streaming). Με ένα προσαρμοσμένο LLM, η αποστολή ολόκληρης της απάντησης σε ένα μόνο event «τοποθετεί ολόκληρη την παραγωγή μέσα στη σιωπή του καλούντα».
Το Get Call API της Retell επιστρέφει τη συνολική καθυστέρηση, την καθυστέρηση του LLM και της μετατροπής κειμένου σε ομιλία για κάθε κλήση στα P50, P90, P95 και P99. Η τιμή του LLM φτάνει «έως τη λήψη του πρώτου εκφωνήσιμου τμήματος», άρα μετρά εκφωνήσιμο κείμενο και όχι το πρώτο ακατέργαστο token.
Ορισμένα μοντέλα είναι σχεδιασμένα γύρω από αυτή τη μετρική. Το Tell-1, το δικό της LLM της Retell, ξεκινά την απάντησή του και συνεχίζει τη συλλογιστική ενώ παίζει η πρώτη φράση. Έχει τη χαμηλότερη διάμεση καθυστέρηση στο Retell vCX Benchmark με 76 ms, μια κυλιόμενη 24ωρη διάμεσο του χρόνου έως την πρώτη πρόταση (ανάγνωση 13 Νοεμβρίου 2026). Η τεχνική ανάρτηση για το Retell LLM εξηγεί πώς λειτουργεί, ενώ ο χρόνος του μοντέλου είναι μόνο ένα μέρος της συνολικής φωνητικής καθυστέρησης.
Συχνές ερωτήσεις για τον χρόνο έως το πρώτο token
Ποιος είναι ένας καλός χρόνος έως το πρώτο token;
Δεν υπάρχει ενιαίο πρότυπο. Εξαρτάται από το μοντέλο, το μήκος του prompt και το φορτίο του server. Για έναν φωνητικό πράκτορα, αξιολογήστε τον μέσα στη συνολική τιμή. Η τεκμηρίωση της Retell προτείνει να διατηρείτε την εκτιμώμενη καθυστέρηση ενός πράκτορα κάτω από 1,5 δευτερόλεπτα.
Είναι το TTFT το ίδιο με την καθυστέρηση;
Όχι. Το TTFT είναι η καθυστέρηση του LLM έως το πρώτο του token. Η καθυστέρηση σε μια κλήση είναι ολόκληρο το κενό από τη στιγμή που ο καλών ολοκληρώνει έως τη στιγμή που ο πράκτορας αρχίζει να μιλά.
Περιλαμβάνει το TTFT τον χρόνο δικτύου;
Εξαρτάται από το πού μετράται. Η NVIDIA αναφέρει ότι το TTFT «γενικά περιλαμβάνει τον χρόνο αναμονής του αιτήματος στην ουρά, τον χρόνο prefill και την καθυστέρηση δικτύου». Μια τιμή μόνο του μοντέλου που μετράται μέσα στον server δεν περιλαμβάνει το δίκτυο.
Ποια είναι η διαφορά ανάμεσα στο TTFT και τον χρόνο έως την πρώτη πρόταση;
Το TTFT σταματά στο πρώτο token. Ο χρόνος έως την πρώτη πρόταση σταματά όταν έχει φτάσει η πρώτη ολοκληρωμένη πρόταση, δηλαδή όταν ένας φωνητικός πράκτορας μπορεί να αρχίσει να μιλά.
Μετρήστε την καθυστέρηση στις δικές σας κλήσεις
Η Retell AI είναι μια πλατφόρμα φωνητικών πρακτόρων AI για κέντρα επικοινωνίας. Το Call History εμφανίζει την καθυστέρηση για κάθε κλήση, με ανάλυση ανά στοιχείο στο Get Call API. Μιλήστε με την ομάδα της Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


