Το prompt caching (προσωρινή αποθήκευση prompt) είναι μια τεχνική που επιτρέπει σε ένα μεγάλο γλωσσικό μοντέλο να παραλείπει εργασία που έχει ήδη κάνει: όταν ένα νέο αίτημα ξεκινά με τα ίδια tokens με ένα προηγούμενο, το μοντέλο επαναχρησιμοποιεί τον αποθηκευμένο υπολογισμό για αυτό το κοινό αρχικό τμήμα και επεξεργάζεται μόνο ό,τι είναι νέο. Το αποτέλεσμα είναι ταχύτερο πρώτο token και, στα περισσότερα API, χαμηλότερη τιμή για τα tokens που επαναχρησιμοποιούνται.
Το τμήμα που επαναχρησιμοποιείται ονομάζεται πρόθεμα (prefix). Ο οδηγός της OpenAI το ορίζει ως «τα αμετάβλητα tokens στην αρχή ενός prompt». Εκεί βρίσκονται συνήθως οι οδηγίες, οι ορισμοί εργαλείων και οι προηγούμενοι γύροι της συνομιλίας.
Πώς λειτουργεί το prompt caching;
Η τεκμηρίωση της Anthropic περιγράφει τη διαδικασία: το σύστημα ελέγχει αν ένα πρόθεμα prompt είναι ήδη αποθηκευμένο στην cache από πρόσφατο ερώτημα, χρησιμοποιεί την αποθηκευμένη εκδοχή αν υπάρχει και, διαφορετικά, επεξεργάζεται ολόκληρο το prompt και αποθηκεύει το πρόθεμα στην cache.
Από αυτόν τον σχεδιασμό προκύπτουν τρεις κανόνες:
- Η αντιστοίχιση είναι ακριβής. Η Anthropic αναφέρει ότι τα cache hits απαιτούν «100 τοις εκατό πανομοιότυπα τμήματα prompt». Ένας μόνο αλλαγμένος χαρακτήρας νωρίς στο prompt σημαίνει ότι όλα όσα ακολουθούν επεξεργάζονται ξανά.
- Η σειρά μετράει. Το σταθερό περιεχόμενο μπαίνει πρώτο και το μεταβαλλόμενο περιεχόμενο τελευταίο.
- Οι εγγραφές λήγουν. Η προεπιλεγμένη διάρκεια ζωής της cache στην Anthropic είναι 5 λεπτά και ανανεώνεται κάθε φορά που χρησιμοποιείται το αποθηκευμένο περιεχόμενο. Στην OpenAI η διάρκεια εξαρτάται από το μοντέλο.
Πώς σχετίζονται το prompt caching, το prefix caching και το KV cache;
Είναι τρία επίπεδα της ίδιας ιδέας. Το KV cache είναι τα δεδομένα, το prefix caching είναι η επαναχρησιμοποίηση αυτών των δεδομένων μεταξύ αιτημάτων και το prompt caching είναι το όνομα που δίνουν στη λειτουργία οι πάροχοι API.
| Όρος | Τι είναι | Εμβέλεια | Πού συναντάτε τον όρο |
|---|---|---|---|
| KV cache | Οι καταστάσεις key και value που υπολογίζει ένα μοντέλο για κάθε token που έχει διαβάσει, οι οποίες διατηρούνται ώστε να μην υπολογίζονται ξανά για κάθε νέο token | Μέσα σε ένα αίτημα | Εσωτερική λειτουργία μοντέλων, μηχανές inference |
| Prefix caching | Η διατήρηση του KV cache μετά το τέλος ενός αιτήματος και η επαναχρησιμοποίησή του σε μεταγενέστερο αίτημα που ξεκινά με τα ίδια tokens | Μεταξύ αιτημάτων στον ίδιο server | Μηχανές inference όπως το vLLM |
| Prompt caching | Prefix caching που προσφέρεται ως λειτουργία API, με κανόνες για διάρκεια ζωής, ελάχιστο μήκος και τιμή | Μεταξύ κλήσεων API | Τεκμηρίωση και σελίδες τιμολόγησης παρόχων μοντέλων |
Ένα επεξηγηματικό άρθρο του Hugging Face περιγράφει απλά το KV cache: «Αντί να υπολογίζει τα πάντα ξανά από την αρχή, το μοντέλο επαναχρησιμοποιεί ό,τι έχει ήδη υπολογίσει». Η τεκμηρίωση του vLLM αναφέρει ότι το αυτόματο prefix caching «αποθηκεύει το KV cache των υπαρχόντων ερωτημάτων, ώστε ένα νέο ερώτημα να μπορεί να επαναχρησιμοποιήσει απευθείας το KV cache αν μοιράζεται το ίδιο πρόθεμα». Η OpenAI επιβεβαιώνει τη σύνδεση από την πλευρά του API: «Η prompt cache αποθηκεύει tensors key-value (KV), όχι τα ίδια τα tokens.»
Γιατί το prompt caching έχει σημασία σε μια τηλεφωνική κλήση πολλαπλών γύρων;
Ένας φωνητικός πράκτορας καλεί το μοντέλο μία φορά ανά γύρο και κάθε αίτημα μεταφέρει τις οδηγίες, τους ορισμούς εργαλείων και τη συνομιλία μέχρι εκείνη τη στιγμή. Σε μια συνομιλία πολλαπλών γύρων σχεδόν όλα αυτά είναι πανομοιότυπα με το αίτημα του προηγούμενου γύρου. Μόνο η τελευταία ανταλλαγή είναι νέα. Χωρίς caching, το μοντέλο διαβάζει ξανά τις ίδιες οδηγίες σε κάθε γύρο.
Παράδειγμα (ενδεικτικοί αριθμοί). Ένας πράκτορας έχει 2.500 tokens οδηγιών και εργαλείων, κάθε γύρος προσθέτει 100 tokens συνομιλίας και κάθε γύρος μετά τον πρώτο βρίσκει το πρόθεμά του στην cache:
| Γύρος | Tokens του prompt | Επαναχρησιμοποίηση από cache | Νέα tokens προς ανάγνωση |
|---|---|---|---|
| 1 | 2.600 | 0 | 2.600 |
| 2 | 2.700 | 2.600 | 100 |
| 5 | 3.000 | 2.900 | 100 |
| 10 | 3.500 | 3.400 | 100 |
| Και οι 10 γύροι | 30.500 | 27.000 | 3.500 |
Σε όλη την κλήση, 27.000 από τα 30.500 tokens του prompt (περίπου 89%) προέρχονται από την cache. Από τον δεύτερο γύρο και μετά, το μοντέλο διαβάζει 100 νέα tokens αντί για περισσότερα από 2.600.
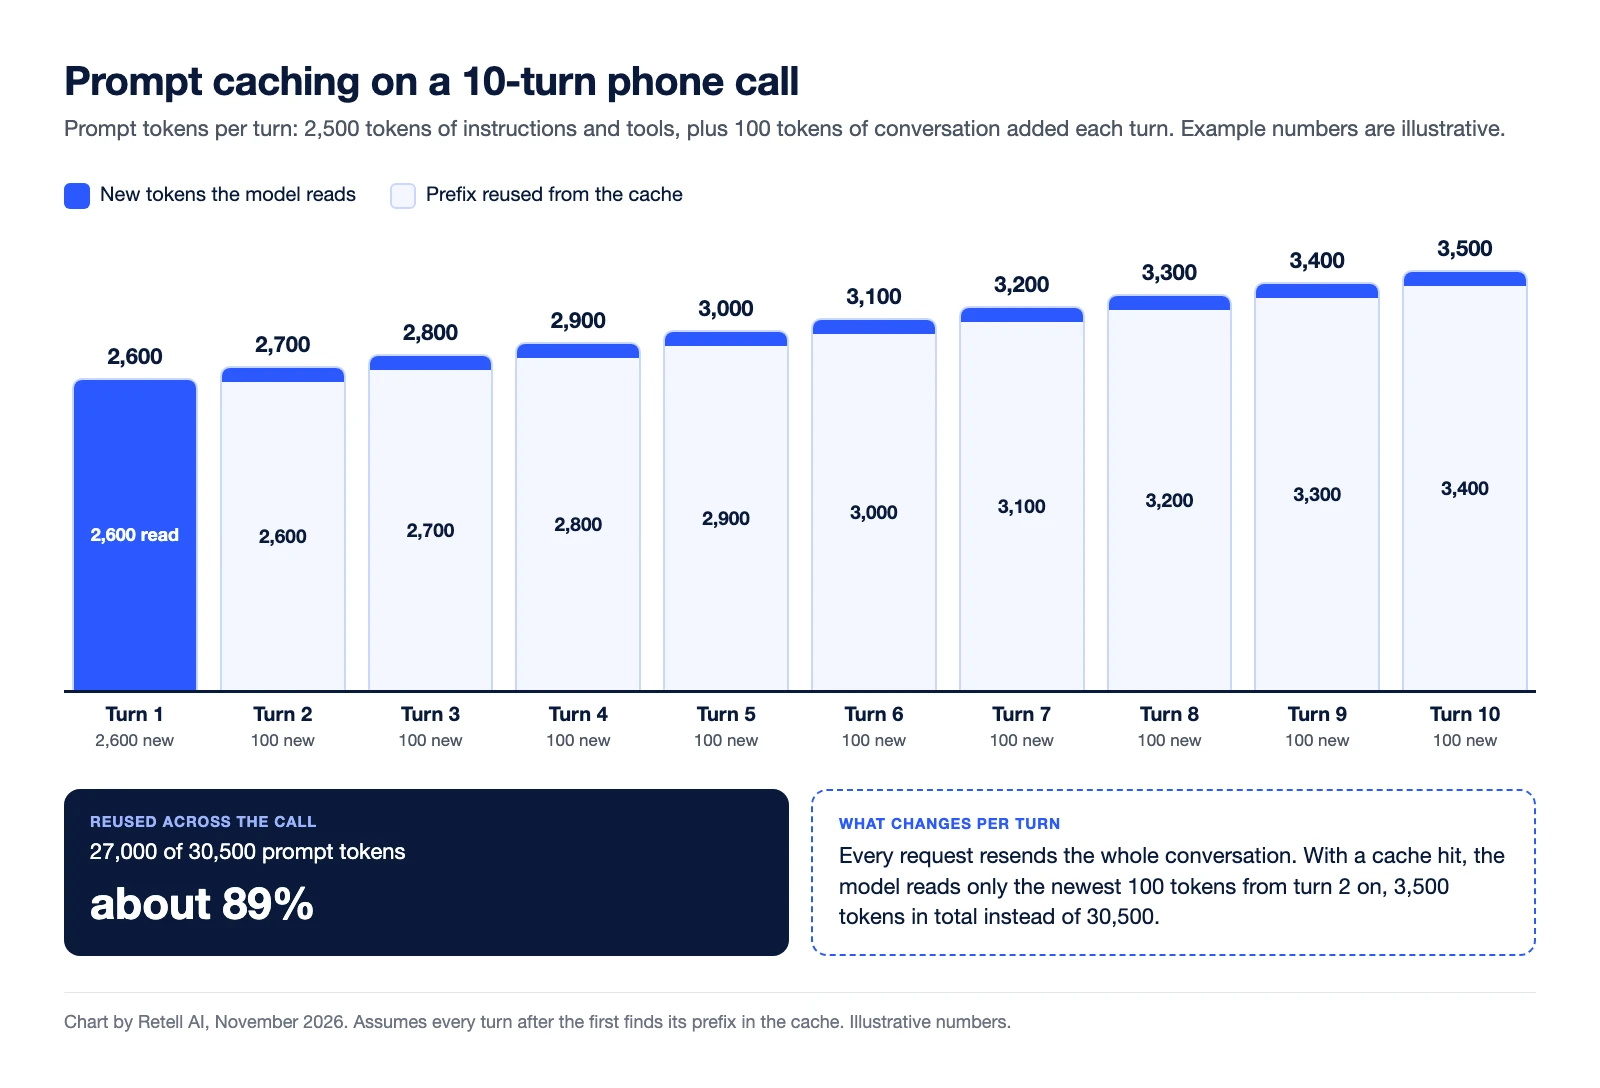
Αυτό έχει σημασία για δύο λόγους. Ο χρόνος έως το πρώτο token αποτελεί μέρος της καθυστέρησης (latency) που ο καλών ακούει ως σιωπή, και η ανάγνωση ενός μεγάλου prompt απαιτεί χρόνο. Ο δεύτερος λόγος είναι το κόστος: η Anthropic χρεώνει τις αναγνώσεις από την cache στο 0,1 της βασικής τιμής των input tokens, ενώ τις εγγραφές στην cache στο 1,25 για διάρκεια ζωής 5 λεπτών.
Τι εμποδίζει ένα cache hit;
- Ένα αλλαγμένο πρόθεμα. Μια χρονοσφραγίδα, το όνομα του καλούντος ή μια αναδιατεταγμένη λίστα εργαλείων κοντά στην αρχή του prompt αλλάζει κάθε token που ακολουθεί.
- Ένα διάστημα μεγαλύτερο από τη διάρκεια ζωής της cache.
- Η άφιξη του αιτήματος σε διαφορετικό μηχάνημα. Ο οδηγός της OpenAI σημειώνει ότι «οι αποθηκευμένες καταστάσεις βρίσκονται σε μεμονωμένα μηχανήματα» και ότι ένα αίτημα μπορεί να επαναχρησιμοποιήσει ένα πρόθεμα «μόνο αν φτάσει σε μηχάνημα που διαθέτει αντίστοιχη εγγραφή η οποία δεν έχει λήξει».
Η δρομολόγηση μπορεί να καλύψει αυτό το τελευταίο κενό. Το Tell-1, το δικό LLM της Retell, κρατά κάθε κλήση στις GPU που την έχουν ήδη στην cache, χρησιμοποιώντας session affinity. Σύμφωνα με το τεχνικό άρθρο για το LLM της Retell, αυτό σχεδόν διπλασιάζει το ποσοστό των tokens του prompt που εξυπηρετούνται από την cache, από 36% σε 69%, οπότε κάθε γύρος έχει λιγότερα να διαβάσει και οι απαντήσεις ξεκινούν νωρίτερα.
Το caching δεν αλλάζει την απάντηση. Οι σημειώσεις σχεδιασμού του vLLM αναφέρουν ότι το prefix caching «δεν θα αλλάξει τις εξόδους του μοντέλου».
Πού εντάσσονται οι φωνητικοί πράκτορες AI
Ο οδηγός αντιμετώπισης προβλημάτων καθυστέρησης της Retell περιγράφει ευθέως το κόστος του μήκους του prompt: «Κάθε token στο prompt σας προσθέτει στον χρόνο έως το πρώτο token, και αυτό το κόστος πληρώνεται σε κάθε γύρο της συνομιλίας.»
Αν συνδέσετε το δικό σας μοντέλο μέσω του LLM WebSocket της Retell, κάθε αίτημα απάντησης φτάνει με την «πλήρη ζωντανή απομαγνητοφώνηση που έχει συλλεχθεί στην κλήση μέχρι στιγμής». Ο server σας δημιουργεί το prompt, επομένως η συμπεριφορά της cache εξαρτάται από τον τρόπο που το δημιουργείτε και από τον πάροχο του μοντέλου σας: διατηρήστε τις οδηγίες και τα εργαλεία πρώτα και αμετάβλητα, και προσθέστε την απομαγνητοφώνηση μετά από αυτά. Για την πλήρη διαδρομή ενός γύρου, δείτε πώς λειτουργεί το φωνητικό AI σε πραγματικό χρόνο.
Συχνές ερωτήσεις για το prompt caching
Ποια είναι η διαφορά μεταξύ prompt caching και KV cache;
Το KV cache είναι η αποθηκευμένη κατάσταση attention που δημιουργεί ένα μοντέλο καθώς διαβάζει tokens. Το prompt caching διατηρεί αυτή την κατάσταση μετά το τέλος ενός αιτήματος, ώστε ένα μεταγενέστερο αίτημα με τα ίδια αρχικά tokens να μπορεί να την επαναχρησιμοποιήσει.
Είναι το prefix caching το ίδιο με το prompt caching;
Πρόκειται για τον ίδιο μηχανισμό. Prefix caching είναι ο όρος που χρησιμοποιούν οι μηχανές inference. Prompt caching είναι το όνομα προϊόντος που χρησιμοποιούν οι πάροχοι μοντέλων στα API τους.
Αλλάζει το prompt caching την απάντηση του μοντέλου;
Όχι. Απλώς παραλείπει τον επανυπολογισμό του κοινού προθέματος.
Πόσο διαρκεί μια prompt cache;
Εξαρτάται από τον πάροχο. Στην Anthropic η προεπιλογή είναι 5 λεπτά, με ανανέωση σε κάθε χρήση, και υπάρχει επιλογή 1 ώρας με υψηλότερη τιμή εγγραφής. Στην OpenAI η διάρκεια εξαρτάται από το μοντέλο.
Γιατί το prompt caching έχει σημασία για τους φωνητικούς πράκτορες;
Σε κάθε γύρο μιας κλήσης αποστέλλονται ξανά οι οδηγίες και η συνομιλία μέχρι εκείνη τη στιγμή. Με cache hit, το μοντέλο διαβάζει μόνο την πιο πρόσφατη ανταλλαγή.
Ακούστε τη διαφορά στις δικές σας κλήσεις
Η Retell AI είναι μια πλατφόρμα φωνητικών πρακτόρων AI για κέντρα επικοινωνίας. Το Tell-1 είναι το δικό της LLM, σχεδιασμένο για τηλεφωνικές κλήσεις. Η τεκμηρίωσή της δείχνει πώς να ελέγξετε την καθυστέρηση κάθε κλήσης ανά στοιχείο, ώστε να δείτε πόσο μέρος της αναμονής οφείλεται στο μοντέλο. Μιλήστε με την ομάδα της Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


