Η speculative decoding (κερδοσκοπική αποκωδικοποίηση) είναι μια τεχνική επιτάχυνσης ενός μεγάλου γλωσσικού μοντέλου: ένα μικρό μοντέλο προσχεδίου (draft model) μαντεύει τα επόμενα λίγα tokens και το μεγάλο μοντέλο τα ελέγχει όλα σε ένα μόνο πέρασμα, κρατώντας όσα θα είχε παραγάγει το ίδιο.
Η μέθοδος προέρχεται από δύο ερευνητικές δημοσιεύσεις. Η Google Research της έδωσε το όνομά της στο Fast Inference from Transformers via Speculative Decoding (Leviathan, Kalman και Matias, πρώτη δημοσίευση τον Νοέμβριο του 2022). Η DeepMind περιέγραψε τη δική της εκδοχή, που αναπτύχθηκε ανεξάρτητα, στο Accelerating Large Language Model Decoding with Speculative Sampling (Chen και συνεργάτες, Φεβρουάριος 2023).
Γιατί η τυπική αποκωδικοποίηση είναι αργή;
Η τυπική αποκωδικοποίηση είναι αργή επειδή ένα μεγάλο γλωσσικό μοντέλο γράφει ένα token τη φορά και κάθε token απαιτεί μια πλήρη εκτέλεση του μοντέλου. Η δημοσίευση της Google το διατυπώνει σε μία γραμμή: «η αποκωδικοποίηση K tokens απαιτεί K διαδοχικές εκτελέσεις του μοντέλου».
Πολλά από αυτά τα tokens προβλέπονται εύκολα. Η ίδια δημοσίευση παρατηρεί ότι «οι δύσκολες εργασίες γλωσσικής μοντελοποίησης συχνά περιλαμβάνουν ευκολότερες υποεργασίες που μπορούν να προσεγγιστούν καλά από πιο αποδοτικά μοντέλα».
Πώς συνεργάζονται το μοντέλο προσχεδίου και το πλήρες μοντέλο;
Τα δύο μοντέλα λειτουργούν σε γύρους και κάθε γύρος έχει τρία μέρη:
- Προσχέδιο. Το μικρό μοντέλο γράφει μια σύντομη σειρά από εικασίες, το ένα token μετά το άλλο. Η δημοσίευση της Google το ονομάζει μοντέλο προσέγγισης· η DeepMind το ονομάζει μοντέλο προσχεδίου.
- Επαλήθευση. Το μεγάλο μοντέλο, που ονομάζεται μοντέλο-στόχος, βαθμολογεί παράλληλα κάθε θέση εικασίας, σε ένα πέρασμα.
- Αποδοχή ή διόρθωση. Οι εικασίες γίνονται αποδεκτές από αριστερά προς τα δεξιά. Στην πρώτη απορριφθείσα εικασία, το μεγάλο μοντέλο δίνει το δικό του token και οι επόμενες εικασίες απορρίπτονται. Αν γίνουν αποδεκτές όλες οι εικασίες, το μεγάλο μοντέλο προσθέτει ένα ακόμη token.
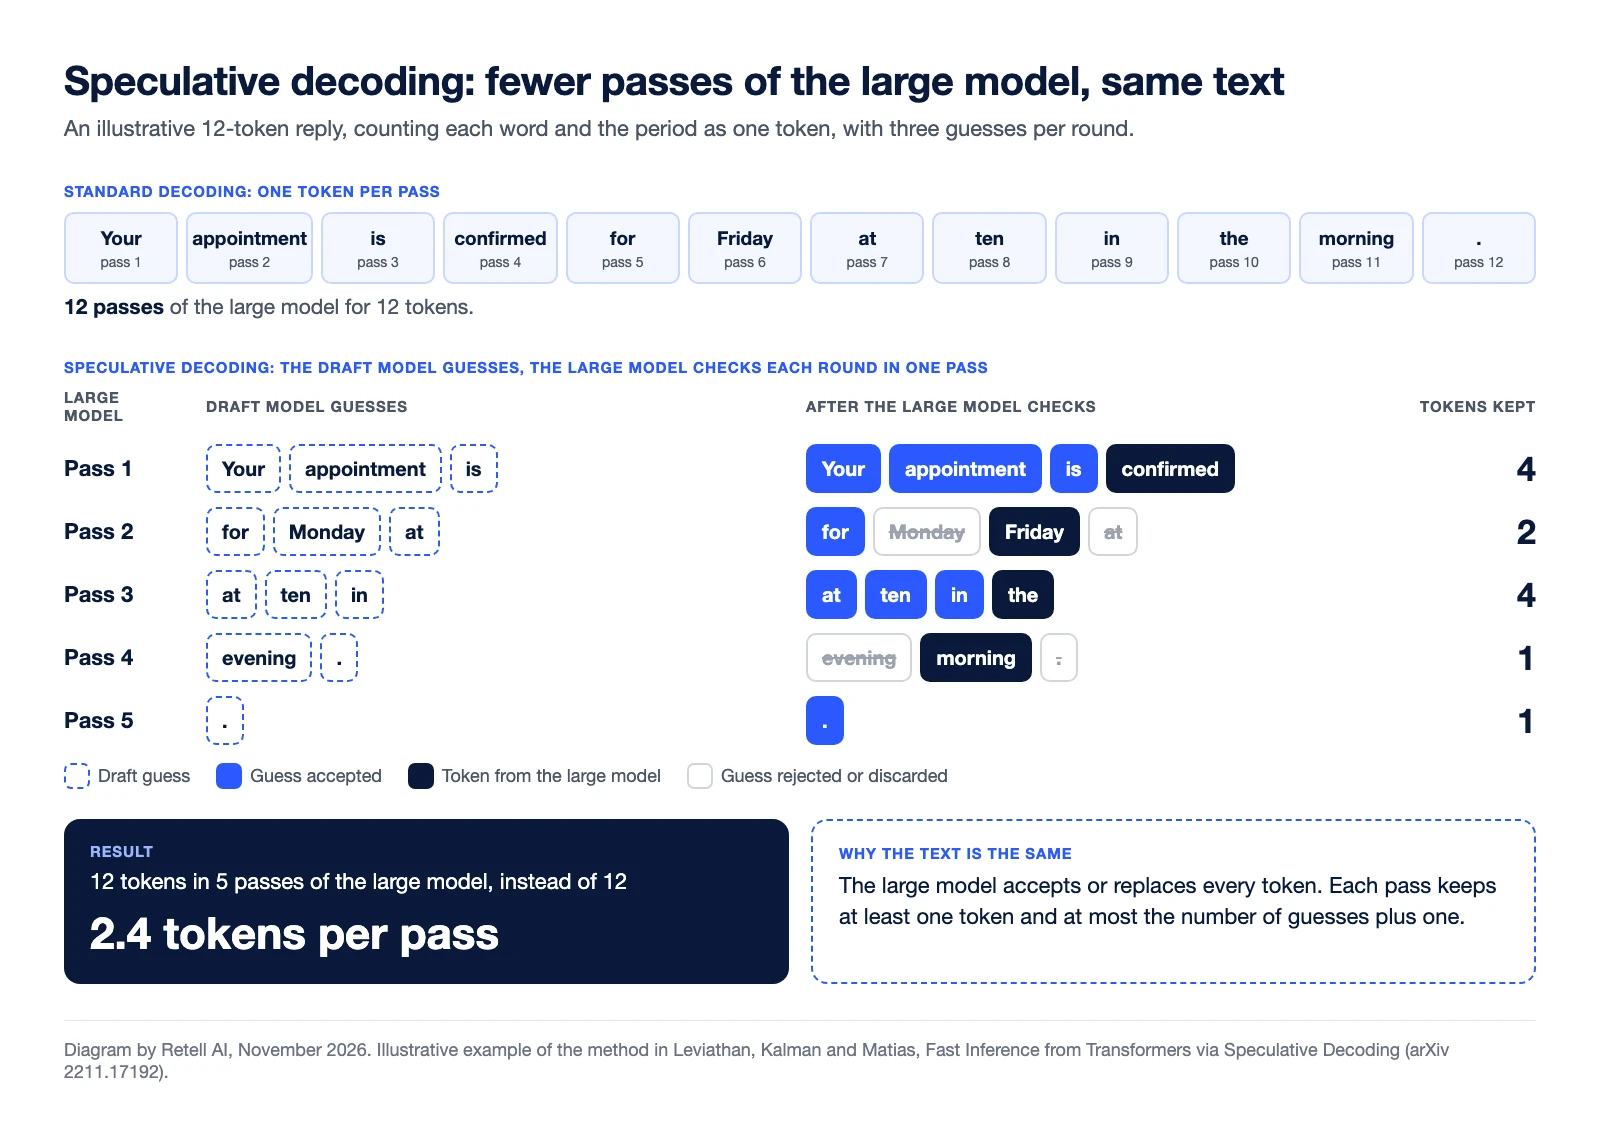
Κάθε πέρασμα του μεγάλου μοντέλου αποδίδει τουλάχιστον ένα token και το πολύ όσες είναι οι εικασίες συν ένα, άρα δεν χρειάζεται ποτέ περισσότερα περάσματα από την τυπική αποκωδικοποίηση.
Παράδειγμα (ενδεικτικό). Μια απάντηση 12 tokens, όπου κάθε λέξη και η τελεία μετρούν ως ένα token, με τρεις εικασίες ανά γύρο:
| Πέρασμα του μεγάλου μοντέλου | Εικασίες του μοντέλου προσχεδίου | Ετυμηγορία του μεγάλου μοντέλου | Tokens που διατηρούνται |
|---|---|---|---|
| 1 | Your appointment is | Γίνονται αποδεκτές και οι τρεις, προστίθεται το «confirmed» | 4 |
| 2 | for Monday at | Το «for» γίνεται αποδεκτό. Το «Monday» απορρίπτεται και αντικαθίσταται από το «Friday». Το «at» απορρίπτεται | 2 |
| 3 | at ten in | Γίνονται αποδεκτές και οι τρεις, προστίθεται το «the» | 4 |
| 4 | evening . | Το «evening» απορρίπτεται και αντικαθίσταται από το «morning». Η τελεία απορρίπτεται | 1 |
| 5 | . | Γίνεται αποδεκτή και η απάντηση ολοκληρώνεται | 1 |
| Σύνολο | 12 tokens σε 5 περάσματα |
Η τυπική αποκωδικοποίηση χρειάζεται 12 περάσματα του μεγάλου μοντέλου για αυτή την πρόταση. Εδώ εκτελείται 5 φορές, με μέσο όρο 2,4 tokens ανά πέρασμα.
Γιατί η έξοδος παραμένει αμετάβλητη;
Η έξοδος παραμένει αμετάβλητη επειδή το μεγάλο μοντέλο έχει τον τελευταίο λόγο για κάθε token. Με την άπληστη αποκωδικοποίηση (greedy decoding), όπου το μοντέλο επιλέγει πάντα την κορυφαία επιλογή του, μια εικασία διατηρείται μόνο αν είναι το token που θα είχε επιλέξει το μεγάλο μοντέλο. Η τεκμηρίωση του vLLM αναφέρει έναν έλεγχο ακριβώς γι’ αυτό: η άπληστη δειγματοληψία με speculative decoding «ταυτίζεται με την άπληστη δειγματοληψία χωρίς αυτήν».
Με τυχαία δειγματοληψία, μια εικασία γίνεται αποδεκτή με πιθανότητα που καθορίζεται από το πώς την αξιολογούν τα δύο μοντέλα, ενώ μια απορριφθείσα εικασία επαναλαμβάνεται από μια προσαρμοσμένη κατανομή. Η δημοσίευση της Google αποδεικνύει ότι έτσι η κατανομή εξόδου μένει αμετάβλητη. Κατά τη διατύπωση της DeepMind, το σχήμα «διατηρεί την κατανομή του μοντέλου-στόχου εντός των ορίων αριθμητικής ακρίβειας του υλικού».
Ορισμένες νεότερες παραλλαγές χαλαρώνουν σκόπιμα τον έλεγχο για να κερδίσουν ταχύτητα. Το vLLM σημειώνει ότι μία από τις μεθόδους επαλήθευσής του «δεν διατηρεί την κατανομή».
Πότε βοηθά η speculative decoding και πότε όχι;
Η speculative decoding βοηθά όταν το μοντέλο προσχεδίου είναι φθηνό και συνήθως σωστό και ο διακομιστής διαθέτει πλεονάζουσα υπολογιστική ισχύ.
| Συνθήκη | Επίδραση στην ταχύτητα | Πηγή |
|---|---|---|
| Οι εικασίες συνήθως γίνονται αποδεκτές | Περισσότερα tokens ανά πέρασμα. Αναμενόμενα tokens ανά πέρασμα = (1 − α^(γ+1)) ÷ (1 − α), όπου α ο ρυθμός αποδοχής και γ οι εικασίες ανά γύρο | Δημοσίευση της Google |
| Το μοντέλο προσχεδίου είναι πολύ μικρότερο από το μοντέλο-στόχο | Χαμηλό κόστος προσχεδίου. Ένα προσχέδιο περίπου δύο τάξεις μεγέθους μικρότερο «συνήθως είχε την καλύτερη απόδοση» | Δημοσίευση της Google |
| Υπάρχει διαθέσιμη πλεονάζουσα υπολογιστική ισχύς | Απαραίτητη. Η μέθοδος προϋποθέτει «επαρκείς υπολογιστικούς πόρους για την υποστήριξη του αυξημένου παραλληλισμού» | Δημοσίευση της Google |
| Μεγάλος φόρτος στον διακομιστή | Μικρότερο όφελος. Το vLLM χαρακτηρίζει ένα μοντέλο προσχεδίου «Υψηλό όφελος» σε χαμηλούς ρυθμούς αιτημάτων και «Μέτριο όφελος» σε υψηλούς | Τεκμηρίωση του vLLM |
| Το προσχέδιο κάνει λάθος πολύ συχνά σε σχέση με το κόστος του | Κανένα όφελος. Επιτάχυνση υπάρχει μόνο όταν ο ρυθμός αποδοχής είναι υψηλότερος από το κόστος του προσχεδίου σε σχέση με το μοντέλο-στόχο | Δημοσίευση της Google |
Ενδεικτικά, ένας ρυθμός αποδοχής 0,6 με τρεις εικασίες ανά γύρο δίνει περίπου 2,2 tokens ανά πέρασμα.
Δημοσιευμένες επιταχύνσεις: η δημοσίευση της Google αναφέρει 2X έως 3X σε ένα μοντέλο T5-XXL 11 δισεκατομμυρίων παραμέτρων. Η DeepMind αναφέρει 2 έως 2,5 φορές στο Chinchilla 70 δισεκατομμυρίων παραμέτρων με προσχέδιο 4 δισεκατομμυρίων παραμέτρων. Τα αποτελέσματα εξαρτώνται από τα μοντέλα, την εργασία και το υλικό.
Ένα παράδειγμα παραγωγής από τον χώρο της φωνής: το Tell-1, το δικό LLM της Retell, χρησιμοποιεί speculative decoding για να παράγει περίπου τέσσερα tokens από κάθε πέρασμα του πλήρους μοντέλου, σύμφωνα με την τεχνική ανάρτηση της Retell για το Retell LLM.
Γιατί έχει σημασία η speculative decoding για τη φωνή σε πραγματικό χρόνο;
Η speculative decoding έχει σημασία για τη φωνή σε πραγματικό χρόνο επειδή ο καλών ακούει τον χρόνο του μοντέλου ως σιωπή. Σε μια κλήση, το μοντέλο είναι ένα στάδιο της αλυσίδας μετατροπής ομιλίας σε κείμενο, LLM και μετατροπής κειμένου σε ομιλία και η καθυστέρησή του προστίθεται στην καθυστέρηση (latency) της κλήσης.
Οι βέλτιστες πρακτικές της Retell για προσαρμοσμένο LLM εξηγούν ποιο μέρος του χρόνου του μοντέλου μετράει: η Retell «αρχίζει να μιλά μόλις έχει την πρώτη σας ολοκληρωμένη πρόταση», οπότε ο αριθμός που πρέπει να παρακολουθείτε είναι «ο χρόνος έως το πρώτο token συν τον χρόνο ολοκλήρωσης αυτής της πρώτης πρότασης». Η speculative decoding επιδρά στο δεύτερο μέρος: μόλις ξεκινήσει η παραγωγή, τα tokens φτάνουν σε ομάδες. Δεν συντομεύει την ανάγνωση του prompt που προηγείται του πρώτου token. Γι’ αυτό, ο οδηγός αντιμετώπισης προβλημάτων καθυστέρησης της Retell ξεκινά με την επιλογή μοντέλου και το μήκος του prompt.
Ο άλλος λόγος είναι η ακρίβεια. Η μετάβαση σε ένα μικρότερο μοντέλο μειώνει επίσης την καθυστέρηση, αλλά ο ίδιος οδηγός προειδοποιεί ότι η αλλαγή μοντέλου «αλλάζει τη συμπεριφορά του πράκτορά σας, όχι μόνο την ταχύτητά του». Η ακριβής speculative decoding διατηρεί την έξοδο του μεγάλου μοντέλου.
Την εφαρμόζει όποιος εξυπηρετεί το μοντέλο, οπότε όποιος δημιουργεί έναν πράκτορα την αντιλαμβάνεται ως ταχύτητα του μοντέλου. Στη Retell, το Tell-1 εξυπηρετείται με αυτόν τον τρόπο. Για να συγκρίνετε μοντέλα ως προς την ταχύτητα και την ποιότητα των κλήσεων, δείτε τα καλύτερα LLM για φωνητικούς πράκτορες AI.
Συχνές ερωτήσεις για τη speculative decoding
Είναι η speculative decoding χωρίς απώλειες;
Στην ακριβή της μορφή, ναι. Οι αρχικές δημοσιεύσεις αποδεικνύουν ότι η κατανομή εξόδου ταυτίζεται με αυτή του μεγάλου μοντέλου και το vLLM την περιγράφει ως «θεωρητικά χωρίς απώλειες έως τα όρια ακρίβειας της αριθμητικής του υλικού». Οι παραλλαγές που χαλαρώνουν την επαλήθευση δεν είναι χωρίς απώλειες.
Ποιος δημιούργησε τη speculative decoding;
Οι Yaniv Leviathan, Matan Kalman και Yossi Matias της Google Research δημοσίευσαν την εργασία τον Νοέμβριο του 2022 και την παρουσίασαν στο ICML 2023. Μια ομάδα της DeepMind δημοσίευσε τη δική της εκδοχή, με το όνομα speculative sampling, τον Φεβρουάριο του 2023.
Τι είναι ένα μοντέλο προσχεδίου;
Ένα μοντέλο προσχεδίου είναι το μικρό, γρήγορο μοντέλο που γράφει τις εικασίες. Η τεκμηρίωση του Hugging Face αναφέρει ότι η μέθοδος λειτουργεί καλύτερα όταν το μοντέλο αυτό «είναι σημαντικά μικρότερο από το κύριο μοντέλο και χρησιμοποιεί τον ίδιο tokenizer».
Μειώνει η speculative decoding το κόστος;
Μπορεί να συμβεί και το ένα και το άλλο. Η δημοσίευση της Google σημειώνει ότι ο συνολικός αριθμός αριθμητικών πράξεων «μπορεί να είναι υψηλότερος από αυτόν του τυπικού αλγορίθμου αποκωδικοποίησης», αφού οι απορριφθείσες εικασίες είναι χαμένη εργασία. Η αναδρομή της Google του 2024 προσθέτει ότι ταχύτερα αποτελέσματα στο ίδιο υλικό σημαίνουν ότι «χρειάζονται λιγότερα μηχανήματα για την εξυπηρέτηση του ίδιου όγκου κίνησης».
Είναι η πρόβλεψη πολλαπλών tokens το ίδιο με τη speculative decoding;
Όχι. Η πρόβλεψη πολλαπλών tokens (MTP) είναι ένας τρόπος παραγωγής των εικασιών. Η τεκμηρίωση του vLLM αναφέρει το MTP δίπλα στα μοντέλα προσχεδίου ως μέθοδο speculation.
Δοκιμάστε την ταχύτητα του μοντέλου στις δικές σας κλήσεις
Η Retell AI είναι μια πλατφόρμα φωνητικών πρακτόρων AI για κέντρα επικοινωνίας. Μιλήστε με την ομάδα της Retell για ένα πιλοτικό πρόγραμμα σε πραγματικές κλήσεις.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


