Το LLM ως κριτής (LLM as a judge) είναι μια μέθοδος αξιολόγησης κατά την οποία ένα μεγάλο γλωσσικό μοντέλο βαθμολογεί ή κατατάσσει την έξοδο ενός άλλου συστήματος AI με βάση γραπτά κριτήρια, στη θέση ενός ανθρώπινου αξιολογητή. Οι ομάδες το χρησιμοποιούν για να βαθμολογούν εργασίες ανοιχτού τύπου, όπως μια τηλεφωνική συνομιλία, που δεν έχουν μία και μοναδική σωστή απάντηση.
Η ονομασία προέρχεται από μια δημοσίευση του 2023, το Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Οι συγγραφείς της ανέφεραν ότι ισχυροί κριτές όπως το GPT-4 συμφωνούσαν με τις ανθρώπινες προτιμήσεις με «πάνω από 80% συμφωνία, το ίδιο επίπεδο συμφωνίας με αυτό μεταξύ ανθρώπων». Κατέγραψαν επίσης τους περιορισμούς της μεθόδου: μεροληψία θέσης, μεροληψία πολυλογίας και μεροληψία αυτοπροτίμησης.
Πώς βαθμολογεί μια συνομιλία ένας κριτής LLM;
Ένας κριτής LLM διαβάζει τη συνομιλία και ένα σύνολο οδηγιών και στη συνέχεια επιστρέφει μια ετυμηγορία σε μία από τις εξής τρεις μορφές.
| Μέθοδος | Τι κάνει ο κριτής | Τι επιστρέφει | Πού ταιριάζει |
|---|---|---|---|
| Βαθμολόγηση με ρουμπρίκα | Διαβάζει μία απομαγνητοφώνηση με βάση γραπτά κριτήρια | Επιτυχία ή αποτυχία, ή βαθμολογία, μαζί με αιτιολόγηση | QA σε παραγωγή και έλεγχοι παλινδρόμησης |
| Κατάταξη ανά ζεύγη | Συγκρίνει δύο ή περισσότερες απαντήσεις στην ίδια σειρά ομιλίας | Έναν νικητή ή μια σειρά κατάταξης | Επιλογή μεταξύ prompts ή μοντέλων |
| Ομάδα κριτών | Πολλά μοντέλα-κριτές βαθμολογούν το ίδιο στοιχείο και οι ετυμηγορίες συγκεντρώνονται | Μία συγκεντρωτική βαθμολογία | Βαθμολογίες που θα μπορούσε να αλλοιώσει η μεροληψία ενός μόνο μοντέλου |
Βαθμολόγηση με ρουμπρίκα. Στη δημοσίευση G-Eval, ο κριτής συλλογιζόταν βήμα προς βήμα τα κριτήρια και στη συνέχεια συμπλήρωνε μια φόρμα βαθμολόγησης. Στη σύνοψη κειμένων, οι βαθμολογίες του συσχετίζονταν με τις ανθρώπινες αξιολογήσεις καλύτερα από προγενέστερες μεθόδους.
Κατάταξη ανά ζεύγη. Η ερώτηση ποια από δύο απαντήσεις είναι καλύτερη ταιριάζει σε ιδιότητες όπως ο τόνος, όπου μια διαφορά γίνεται πιο εύκολα αντιληπτή παρά βαθμολογείται.
Ομάδες κριτών. Στη δημοσίευση Replacing Judges with Juries, μια ομάδα μικρότερων μοντέλων από διαφορετικές οικογένειες μοντέλων «υπερέχει ενός μεμονωμένου μεγάλου κριτή, παρουσιάζει μικρότερη μεροληψία εντός του μοντέλου» και ήταν «πάνω από επτά φορές φθηνότερη».
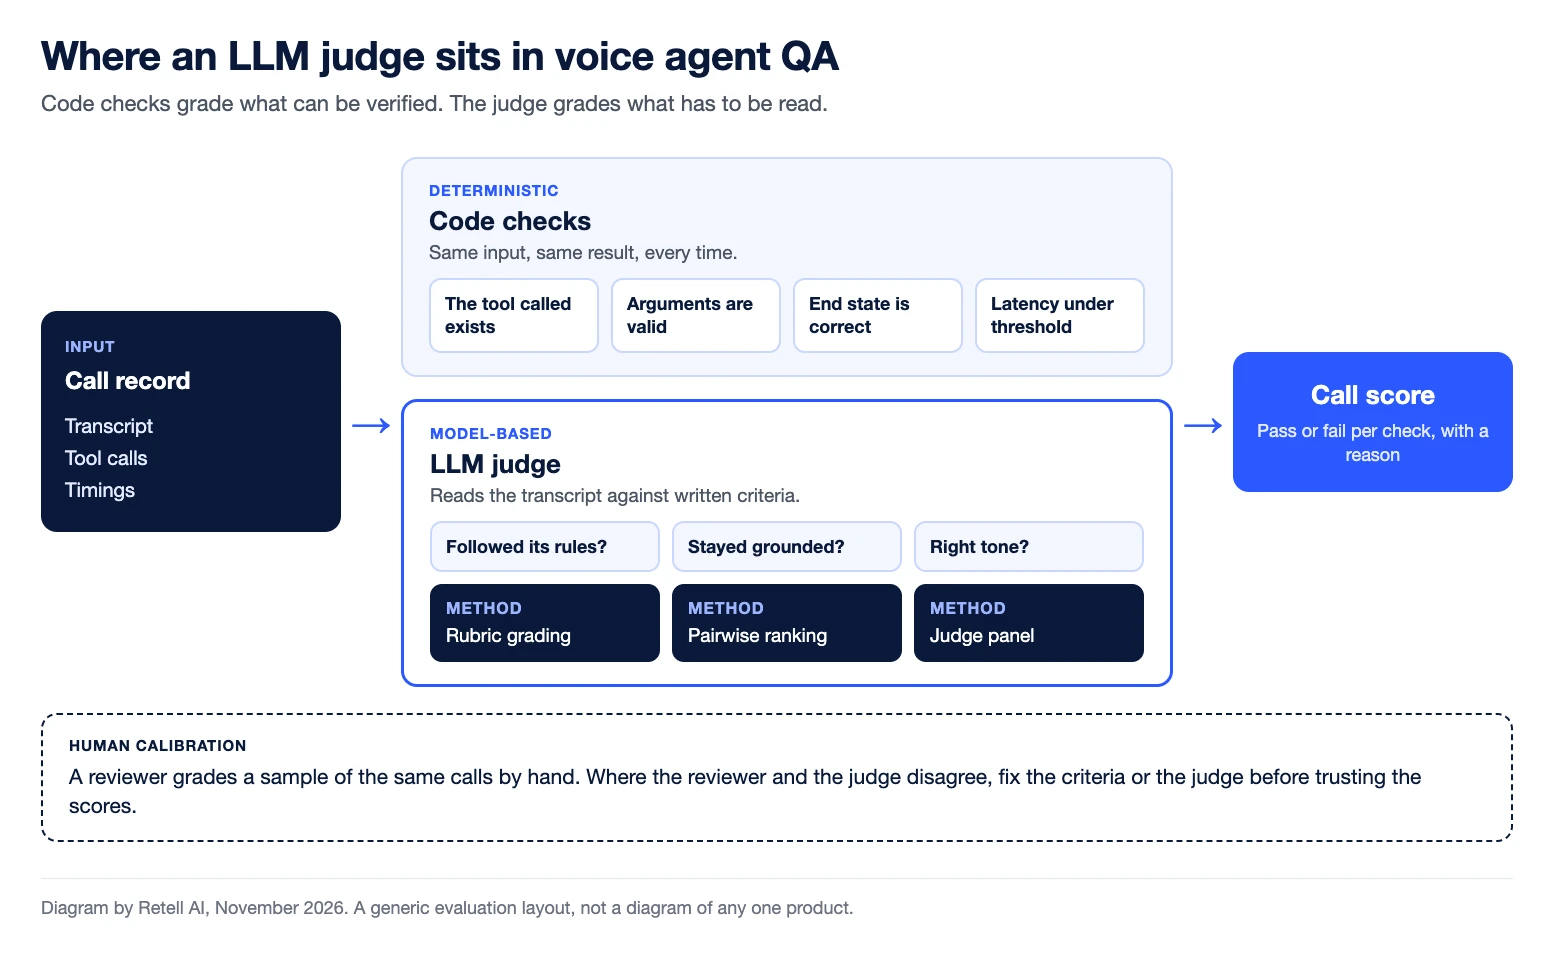
Πώς χρησιμοποιείται το LLM ως κριτής στο QA και στα benchmarks φωνητικών πρακτόρων AI;
Το QA φωνητικών πρακτόρων AI χρησιμοποιεί έναν κριτή LLM για τα σημεία μιας κλήσης που μόνο η ανάγνωση της απομαγνητοφώνησης μπορεί να κρίνει: αν ο πράκτορας ακολούθησε τους κανόνες του, αν παρέμεινε εντός των πηγών του και αν επέλυσε το αίτημα.
Η τεκμηρίωση της Retell παρουσιάζει και τις δύο συνήθεις διαμορφώσεις. Στο AI QA, μια συνθήκη που αξιολογείται από AI είναι «ένας ποιοτικός έλεγχος που εκτελεί το AI στην απομαγνητοφώνηση και στο πλαίσιο κάθε κλήσης», γραμμένος ως «το prompt που χρησιμοποιεί το AI για να κρίνει αν η συνθήκη πληρείται». Στον έλεγχο μέσω προσομοίωσης, ένα AI υποδύεται τον καλούντα και «κάθε εκτέλεση βαθμολογείται ως επιτυχία ή αποτυχία με γραπτή εξήγηση».
Τα benchmarks αναφέρουν το ίδιο είδος ετυμηγορίας σε κλίμακα. Το Retell vCX Benchmark δημοσιεύει τη βαθμολογία κάθε σουίτας ως ποσοστό επιτυχίας, «το ποσοστό των σεναρίων ελέγχου που χειρίστηκε σωστά», σε τήρηση οδηγιών, θεμελίωση στις πηγές, κλήση εργαλείων και καθομιλουμένη γλώσσα (ανάγνωση στις 13 Νοεμβρίου 2026).
Για να μετατρέψετε τις ετυμηγορίες σε εβδομαδιαία ανασκόπηση, δείτε την κάρτα βαθμολογίας QA για φωνητικούς πράκτορες AI.
Ποιοι είναι οι γνωστοί τρόποι αποτυχίας ενός κριτή LLM;
Ένας κριτής LLM αποτυγχάνει με τέσσερις τεκμηριωμένους τρόπους. Για καθέναν υπάρχει γνωστός έλεγχος.
- Μεροληψία θέσης. Στη δημοσίευση Large Language Models are not Fair Evaluators, η εναλλαγή της σειράς δύο απαντήσεων επέτρεψε σε ένα μοντέλο να κερδίσει «σε 66 από 80 ερωτήματα ελέγχου». Εκτελείτε κάθε σύγκριση και με τις δύο σειρές.
- Αυτοπροτίμηση. Μια μελέτη του 2024 διαπίστωσε ότι ένας αξιολογητής «βαθμολογεί τις δικές του εξόδους υψηλότερα από εκείνες άλλων, ενώ οι ανθρώπινοι σχολιαστές τις θεωρούν ισάξιας ποιότητας». Χρησιμοποιήστε κριτή από διαφορετική οικογένεια μοντέλων ή μια ομάδα κριτών.
- Αδύναμη συμφωνία με τους ανθρώπους. Η δημοσίευση Judging the Judges εξέτασε δεκατρία μοντέλα-κριτές και διαπίστωσε ότι «μόνο τα καλύτερα (και μεγαλύτερα) μοντέλα επιτυγχάνουν εύλογη ευθυγράμμιση με τους ανθρώπους», με «τάση προς επιείκεια». Βαθμολογήστε ένα δείγμα με το χέρι και συγκρίνετε.
- Μετατόπιση (drift). Το μοντέλο πίσω από ένα API μπορεί να αλλάξει: μία μελέτη κατέγραψε πτώση της ακρίβειας του GPT-4 από 84% σε 51% στην ίδια εργασία μέσα σε τρεις μήνες. Και τα κριτήρια μετακινούνται. Η δημοσίευση Who Validates the Validators? το ονομάζει μετατόπιση κριτηρίων: «οι χρήστες χρειάζονται κριτήρια για να βαθμολογήσουν εξόδους, αλλά η βαθμολόγηση εξόδων βοηθά τους χρήστες να ορίσουν κριτήρια». Κλειδώστε την έκδοση του κριτή και εκτελέστε ξανά ένα σταθερό σύνολο με χειροκίνητες ετικέτες μετά από κάθε αλλαγή.
Επιπλέον, οι κριτές δεν είναι ντετερμινιστικοί. Η τεκμηρίωση προσομοίωσης της Retell συμβουλεύει: «Κρίνετε ένα σενάριο με βάση το ποσοστό επιτυχίας του σε πολλές εκτελέσεις, όχι σε μία.»
Πότε οι έλεγχοι κώδικα υπερτερούν ενός κριτή LLM;
Οι έλεγχοι κώδικα υπερτερούν ενός κριτή LLM όποτε η απάντηση μπορεί να επαληθευτεί αντί να διαβαστεί. Ο οδηγός της Anthropic για αξιολογήσεις πρακτόρων συνιστά «επιλογή ντετερμινιστικών αξιολογητών όπου είναι δυνατό και αξιολογητών LLM όπου είναι απαραίτητο». Χαρακτηρίζει τους αξιολογητές βασισμένους σε κώδικα γρήγορους, φθηνούς, αντικειμενικούς και αναπαραγώγιμους, και τους αξιολογητές βασισμένους σε μοντέλα μη ντετερμινιστικούς.
Σε μια κλήση, ο κώδικας μπορεί να ελέγξει ότι το εργαλείο που κάλεσε ο πράκτορας υπάρχει, ότι τα ορίσματά του είναι έγκυρα και ότι ο χρόνος απόκρισης έμεινε κάτω από ένα όριο. Το tau-bench βαθμολογεί ολόκληρες συνομιλίες με αυτόν τον τρόπο, συγκρίνοντας «την κατάσταση της βάσης δεδομένων στο τέλος μιας συνομιλίας με την επισημασμένη κατάσταση-στόχο».
Το AI QA της Retell κρατά τα δύο ξεχωριστά: οι μετρικές απόδοσης είναι ποσοτικά όρια, ενώ οι συνθήκες που αξιολογούνται από AI περιλαμβάνουν τους ποιοτικούς ελέγχους. Ο οδηγός Πώς να ελέγξετε και να κυκλοφορήσετε αλλαγές σε φωνητικούς πράκτορες AI εξηγεί πού εκτελείται το καθένα.
Πώς χρησιμοποιούνται οι ομάδες κριτών για την εκπαίδευση ενός φωνητικού μοντέλου;
Το Tell-1, το δικό LLM της Retell, χρησιμοποίησε κριτές LLM σε δύο από τα τρία στάδια εκπαίδευσής του, σύμφωνα με την τεχνική ανάρτηση για το LLM της Retell. Το στάδιο ρύθμισης προτιμήσεων μάθαινε από «ζεύγη προτιμήσεων που κατατάσσονται από μια ομάδα κριτών LLM».
Στο στάδιο της ενισχυτικής μάθησης, σύμφωνα με την ανάρτηση, «το μοντέλο γράφει οκτώ απαντήσεις και κάθε μία βαθμολογείται». Ο κώδικας εκτελείται πρώτος: κλήσεις σε εργαλεία εκτός της εργαλειοθήκης του πράκτορα, κακοσχηματισμένη έξοδος και άλλα κρίσιμα σφάλματα «εντοπίζονται στον κώδικα πριν τα δει οποιοσδήποτε κριτής». Για την ορθότητα, «πολλά μοντέλα-κριτές βαθμολογούν την ορθότητα των κλήσεων εργαλείων, τις ψευδαισθήσεις και την τήρηση οδηγιών, και οι ετυμηγορίες τους συγκεντρώνονται σε ένα ενιαίο σήμα ανταμοιβής». Για τη φυσικότητα, ένας μόνο κριτής κατατάσσει και τις οκτώ απαντήσεις δίπλα-δίπλα με βάση μια ρουμπρίκα, επειδή «η φυσικότητα συγκρίνεται πιο εύκολα παρά βαθμολογείται».
Αυτό είναι το μοτίβο που περιγράφει η παρούσα σελίδα: έλεγχοι κώδικα για ό,τι μπορεί να επαληθευτεί, ομάδα κριτών για την ορθότητα και κατάταξη για τον τόνο.
Συχνές ερωτήσεις για το LLM ως κριτή
Τι κάνει ένας κριτής LLM;
Διαβάζει μια έξοδο, όπως την απομαγνητοφώνηση μιας κλήσης, μαζί με οδηγίες βαθμολόγησης, και επιστρέφει μια ετυμηγορία: επιτυχία ή αποτυχία, μια βαθμολογία ή μια προτίμηση μεταξύ δύο επιλογών.
Πόσο αξιόπιστο είναι το LLM ως κριτής;
Εξαρτάται από το μοντέλο-κριτή και την εργασία. Μία μελέτη βρήκε πάνω από 80% συμφωνία με τις ανθρώπινες προτιμήσεις· μια άλλη διαπίστωσε ότι μόνο οι μεγαλύτεροι κριτές ευθυγραμμίζονταν εύλογα με τους ανθρώπους. Ελέγξτε πρώτα έναν κριτή σε σύγκριση με κλήσεις που έχουν βαθμολογηθεί με το χέρι.
Τι είναι μια ομάδα κριτών;
Μια ομάδα κριτών αποτελείται από πολλά μοντέλα-κριτές που βαθμολογούν την ίδια έξοδο, με τις ετυμηγορίες τους να συγκεντρώνονται. Μειώνει την επίδραση της μεροληψίας οποιουδήποτε μεμονωμένου μοντέλου.
Ποια είναι η διαφορά μεταξύ βαθμολόγησης με ρουμπρίκα και κατάταξης ανά ζεύγη;
Η βαθμολόγηση με ρουμπρίκα βαθμολογεί μία έξοδο με βάση γραπτά κριτήρια. Η κατάταξη ανά ζεύγη δείχνει στον κριτή δύο εξόδους και ρωτά ποια είναι καλύτερη.
Μπορεί ένας κριτής LLM να βαθμολογήσει μια φωνητική κλήση;
Ναι, από την απομαγνητοφώνηση και τις κλήσεις εργαλείων. Οι ιδιότητες που βρίσκονται στον ήχο απαιτούν και τον ήχο: η τεκμηρίωση της Retell αναφέρει ότι η Agent Naturalness «αξιολογείται χρησιμοποιώντας τόσο τον ήχο όσο και την απομαγνητοφώνηση».
Βαθμολογήστε τις δικές σας κλήσεις πριν από την κλιμάκωση
Η Retell AI είναι μια πλατφόρμα φωνητικών πρακτόρων AI για κέντρα επικοινωνίας. Το AI QA αξιολογεί ένα δείγμα των κλήσεών σας με βάση τις συνθήκες και τα όρια που ορίζετε, με τεκμήρια από την απομαγνητοφώνηση για κάθε αποτέλεσμα.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


