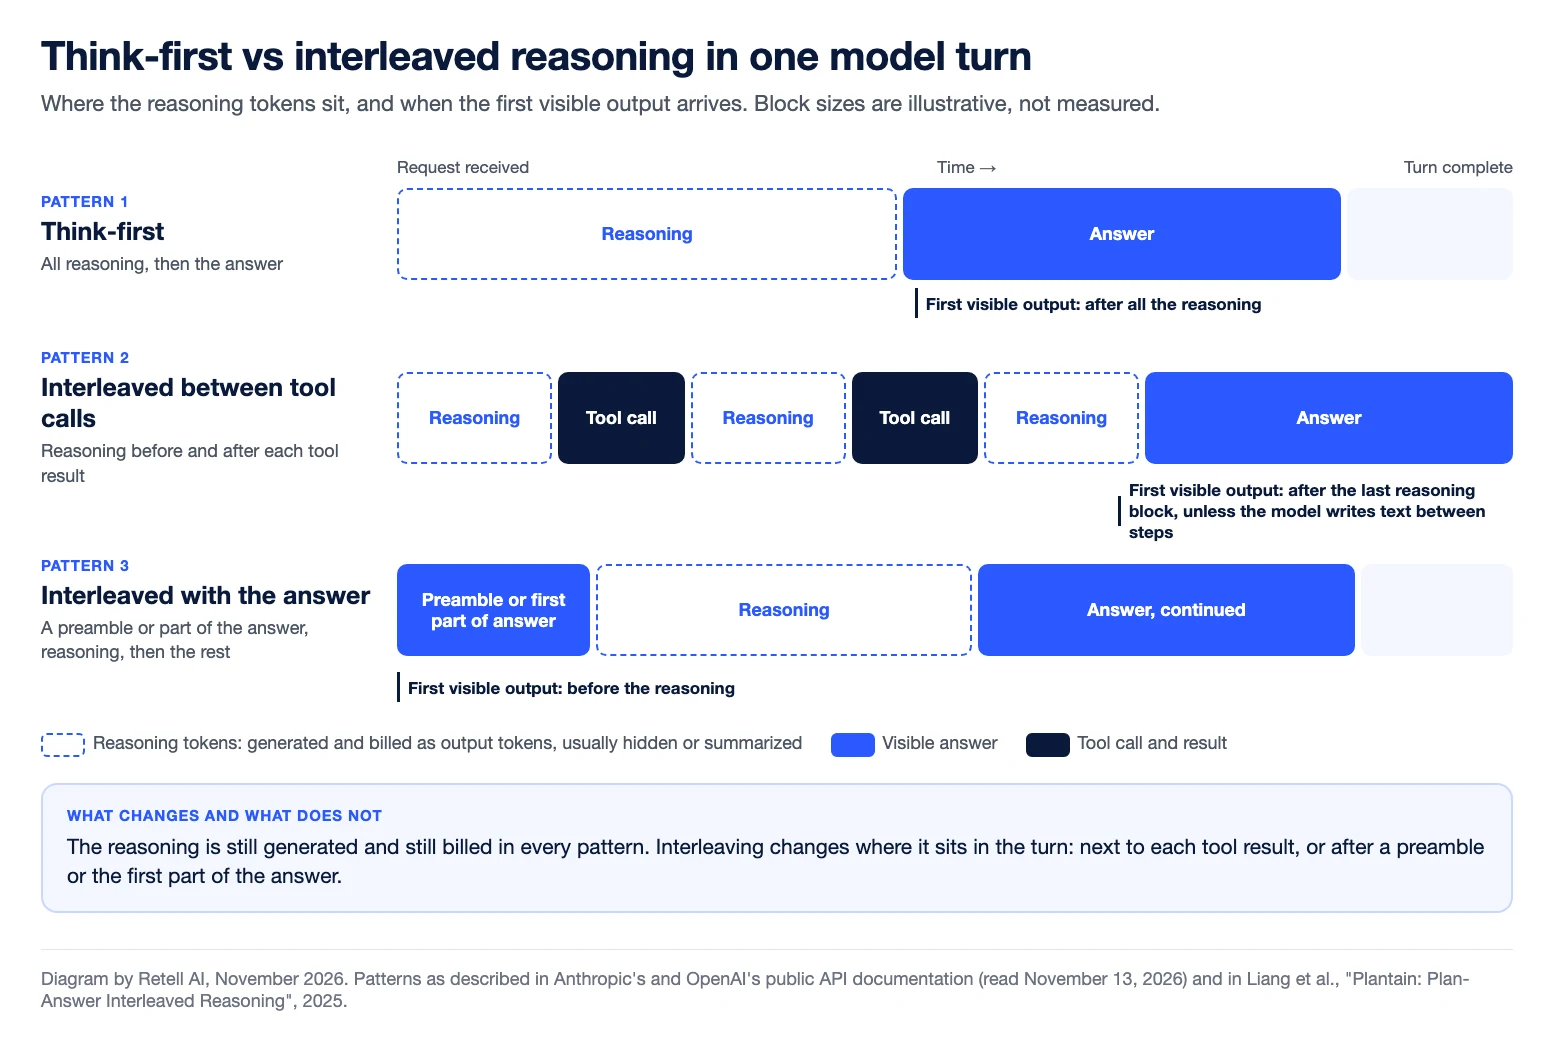
El razonamiento intercalado es una forma de ejecutar un modelo de razonamiento en la que el modelo alterna entre el razonamiento privado y las acciones visibles, como las llamadas a herramientas o partes de su respuesta, en lugar de terminar todo su razonamiento antes de responder.
También se denomina pensamiento intercalado. La documentación de los proveedores usa el término sobre todo para el razonamiento entre llamadas a herramientas. Los artículos de investigación lo usan para un modelo que alterna el pensamiento con partes de su respuesta. Ambos describen el mismo cambio: el razonamiento deja de ser un único bloque al inicio del turno.
¿Qué es un modelo de razonamiento?
Un modelo de razonamiento es un modelo de lenguaje de gran tamaño que genera un razonamiento intermedio antes de su respuesta. La guía de razonamiento de OpenAI lo resume en una línea: «Los modelos de razonamiento usan tokens de razonamiento internos antes de producir una respuesta». La documentación de Gemini de Google dice que un modelo de pensamiento «razona internamente antes de responder», y la documentación de DeepSeek indica que su modo de pensamiento produce un razonamiento de cadena de pensamiento «para mejorar la precisión de la respuesta final».
¿Qué son los tokens de razonamiento?
Los tokens de razonamiento, también llamados tokens de pensamiento, son los tokens que genera un modelo mientras resuelve un problema. No forman parte de la respuesta. Importan tres propiedades:
- Se facturan. OpenAI afirma que los tokens de razonamiento «se facturan como tokens de salida». La documentación de pensamiento de Anthropic dice lo mismo sobre Claude, «incluso cuando el texto del pensamiento no se te devuelve». Google calcula el precio de una respuesta como «la suma de los tokens de salida y los tokens de pensamiento».
- Suelen estar ocultos. Los tokens de razonamiento de OpenAI «no son visibles a través de la API». Anthropic afirma que lo que ves «nunca es la cadena de pensamiento sin procesar». Ambos pueden devolver un resumen si lo solicitas.
- Consumen tiempo y espacio. OpenAI indica que un modelo puede generar «desde unos pocos cientos hasta decenas de miles de tokens de razonamiento» en una sola solicitud, y estos ocupan la ventana de contexto.
Los desarrolladores controlan la cantidad con un ajuste: reasoning effort en OpenAI, effort en Anthropic y thinking level en Google.
¿En qué se diferencia el razonamiento intercalado del razonamiento previo?
En el razonamiento previo (think-first), todo el razonamiento ocurre antes del primer token visible. Anthropic lo llama pensamiento por adelantado: los bloques de pensamiento «llegan antes que los bloques de texto». El razonamiento intercalado divide el razonamiento en bloques más pequeños y los coloca donde se necesitan.
| Patrón | Orden del trabajo en un turno | Lo primero que ve el usuario | Descrito públicamente por |
|---|---|---|---|
| Sin razonamiento | Respuesta | El inicio de la respuesta | Cualquier modelo con el razonamiento desactivado |
| Razonamiento previo | Todo el razonamiento y, después, la respuesta | Nada hasta que termina el razonamiento | Anthropic (pensamiento por adelantado), DeepSeek |
| Intercalado entre llamadas a herramientas | Razonar, llamar a una herramienta, leer el resultado, volver a razonar y, después, responder | Nada hasta que termina el último bloque de razonamiento, salvo que el modelo escriba texto entre pasos | Anthropic, OpenAI, vLLM, DeepSeek (sin usar el término) |
| Intercalado con la respuesta | Un preámbulo o parte de la respuesta, razonamiento, más respuesta | Un preámbulo o una parte inicial de la respuesta | OpenAI, artículos de investigación |
| Intercalado con el habla | Primera frase de la respuesta, razonamiento silencioso mientras se reproduce y, después, el resto de la respuesta | La primera frase de la respuesta | Tell-1, el LLM propio de Retell |
¿Qué documentan hoy los proveedores?
Consultado el 13 de noviembre de 2026:
- Anthropic. «El pensamiento intercalado permite a Claude pensar entre llamadas a herramientas, razonando sobre cada resultado de una herramienta antes de actuar en consecuencia». Es automático en los modelos que admiten el pensamiento adaptativo. Los modelos con pensamiento extendido manual necesitan un encabezado beta.
- OpenAI. Modelos como gpt-5.5 «admiten el pensamiento intercalado, en el que el modelo puede generar tokens de salida visibles antes y entre los pensamientos, y puede pensar entre llamadas a herramientas».
- Google. La página de pensamiento de Gemini no usa el término. Indica que los pasos de pensamiento «aparecen cronológicamente junto a las llamadas a funciones, las entradas del usuario o las salidas del modelo», y que las firmas de pensamiento son «necesarias para mantener la continuidad del razonamiento en interacciones de varios turnos».
- vLLM. El servidor de inferencia de código abierto admite el pensamiento intercalado para dos series de modelos y advierte de que «aumenta el uso de tokens y la latencia de respuesta».
En el ámbito de la investigación, Xie et al. (2025) entrenaron modelos «para intercalar el pensamiento y la respuesta» y reportan una reducción media de más del 80 % en el tiempo hasta el primer token. Liang et al. (2025) definen el razonamiento intercalado como un modelo que «alterna entre pensar y mostrar respuestas intermedias» y reportan que su variante que planifica primero, Plantain, redujo el tiempo hasta la primera respuesta en más del 60 %. Ambos estudiaron tareas de texto.
¿Por qué el razonamiento previo cuesta silencio en una llamada?
En una llamada, la síntesis de voz no puede empezar hasta que el modelo produce las primeras palabras de su respuesta. Cada token de razonamiento generado antes de esas palabras es tiempo en el que quien llama no oye nada. En una ventana de chat, esa misma espera es un indicador de progreso. En una llamada es silencio muerto y latencia añadida.
La documentación de resolución de problemas de latencia de Retell indica que los modelos más grandes y orientados al razonamiento «tardan más en generar el primer token» y «sacrifican latencia a cambio de capacidad». OpenAI menciona la voz como un caso de uso habitual para trabajar con el reasoning effort en none, y sugiere que las aplicaciones sensibles a la latencia «pidan al modelo que genere un breve preámbulo antes de continuar con un razonamiento más profundo». La guía sobre el mejor LLM para agentes de voz con IA trata la elección del modelo.
¿Qué es el razonamiento intercalado en un agente de voz?
En un agente de voz, el razonamiento intercalado significa que el modelo escribe de inmediato la primera frase de su respuesta, razona en silencio mientras esa frase se pronuncia y, después, continúa la respuesta basándose en ese razonamiento. Quien llama oye una única respuesta sin interrupciones, y el razonamiento nunca se pronuncia.
Tell-1 funciona así. El artículo técnico de Retell, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, describe el formato como «una frase inicial hablada, después el razonamiento y, después, el resto de la respuesta». El artículo reporta una media de 200 tokens de razonamiento a mitad de la respuesta, y que el 99,98 % de los turnos se detienen menos de 400 ms después de la primera frase.
En comparación con el razonamiento previo, quien llama no espera en silencio a que termine el razonamiento. El artículo también expone la contrapartida: «hablar antes significa comprometerse con la frase inicial antes de que se haya producido ningún razonamiento». Tell-1 ocupa el puesto n.º 1 en la clasificación general del Retell vCX Benchmark (a noviembre de 2026).
Preguntas frecuentes sobre el razonamiento intercalado
¿El razonamiento intercalado es lo mismo que el pensamiento intercalado?
Sí, en la mayoría de los usos. Anthropic y OpenAI hablan de pensamiento intercalado (interleaved thinking); los artículos de investigación suelen hablar de razonamiento intercalado (interleaved reasoning).
¿Se facturan los tokens de razonamiento?
Sí. OpenAI, Anthropic y Google los cuentan como salida facturada. OpenAI y Anthropic los facturan incluso cuando el texto del razonamiento no se devuelve.
¿Puedes leer los tokens de razonamiento de un modelo?
Normalmente no. OpenAI y Anthropic pueden devolver un resumen si lo solicitas. Ninguno devuelve el razonamiento sin procesar.
¿El razonamiento intercalado hace que un modelo responda más rápido?
No por sí solo. Entre llamadas a herramientas añade tokens, y la documentación de vLLM advierte de que aumenta la latencia de respuesta. La primera salida visible llega antes solo cuando la salida visible aparece antes del razonamiento, o entre bloques más cortos de este.
¿Qué es el razonamiento intercalado en la IA de voz?
Es un modelo que empieza a hablar de inmediato, razona en silencio mientras se reproduce su primera frase y, después, termina la respuesta usando ese razonamiento. Tell-1, el LLM propio de Retell, está creado así.
Ejecuta modelos de razonamiento en llamadas en directo
Retell AI es una plataforma de agentes de voz con IA para centros de contacto. Eliges el modelo que hay detrás de cada agente. Tell-1 es uno de ellos. Habla con el equipo de Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


