La caché de prompts (prompt caching) es una técnica que permite a un modelo de lenguaje de gran tamaño saltarse el trabajo que ya ha hecho: cuando una nueva solicitud empieza con los mismos tokens que una anterior, el modelo reutiliza el cálculo guardado para ese inicio compartido y solo procesa lo nuevo. El resultado es un primer token más rápido y, en la mayoría de las API, un precio más bajo para los tokens reutilizados.
La parte reutilizada se llama prefijo. La guía de OpenAI lo define como «los tokens sin cambios al principio de un prompt». Ahí suelen estar las instrucciones, las definiciones de herramientas y los turnos anteriores de la conversación.
¿Cómo funciona la caché de prompts?
La documentación de Anthropic describe la secuencia: el sistema comprueba si un prefijo del prompt ya está en caché a partir de una consulta reciente; si lo está, usa la versión en caché y, si no, procesa el prompt completo y guarda el prefijo en caché.
De ese diseño se derivan tres reglas:
- La coincidencia es exacta. Anthropic indica que los aciertos de caché requieren «segmentos de prompt 100 % idénticos». Un solo carácter cambiado al principio del prompt hace que todo lo que viene después se procese de nuevo.
- El orden importa. El contenido estable va primero y el contenido que cambia, al final.
- Las entradas caducan. La vida útil predeterminada de la caché de Anthropic es de 5 minutos y se renueva cada vez que se usa el contenido en caché. Las vidas útiles de OpenAI dependen del modelo.
¿Qué relación hay entre la caché de prompts, la caché de prefijos y la caché KV?
Son tres capas de la misma idea. La caché KV son los datos, la caché de prefijos es la reutilización de esos datos entre solicitudes y la caché de prompts es el nombre que dan a la función los proveedores de API.
| Término | Qué es | Alcance | Dónde aparece el término |
|---|---|---|---|
| Caché KV | Los estados de clave y valor que un modelo calcula para cada token que ha leído, guardados para no recalcularlos con cada token nuevo | Dentro de una solicitud | Funcionamiento interno del modelo, motores de inferencia |
| Caché de prefijos | Conservar la caché KV después de que termine una solicitud y reutilizarla en una solicitud posterior que empiece con los mismos tokens | Entre solicitudes en el mismo servidor | Motores de inferencia como vLLM |
| Caché de prompts | Caché de prefijos ofrecida como función de una API, con reglas de vida útil, longitud mínima y precio | Entre llamadas a la API | Documentación y páginas de precios de los proveedores de modelos |
Un artículo explicativo de Hugging Face resume la caché KV de forma sencilla: «En lugar de recalcularlo todo desde cero, el modelo reutiliza lo que ya ha calculado». La documentación de vLLM dice que su caché automática de prefijos «guarda en caché la caché KV de las consultas existentes, de modo que una nueva consulta puede reutilizar directamente la caché KV si comparte el mismo prefijo». OpenAI confirma el vínculo desde el lado de la API: «La caché de prompts almacena tensores de clave-valor (KV), no los propios tokens».
¿Por qué importa la caché de prompts en una llamada telefónica de varios turnos?
Un agente de voz llama al modelo una vez por turno, y cada solicitud incluye las instrucciones, las definiciones de herramientas y la conversación hasta ese momento. En una conversación de varios turnos, casi todo eso es idéntico a la solicitud del turno anterior. Solo el último intercambio es nuevo. Sin caché, el modelo vuelve a leer las mismas instrucciones en cada turno.
Ejemplo práctico (cifras ilustrativas). Un agente tiene 2.500 tokens de instrucciones y herramientas, cada turno añade 100 tokens de conversación y todos los turnos a partir del primero encuentran su prefijo en la caché:
| Turno | Tokens del prompt | Reutilizados de la caché | Tokens nuevos que leer |
|---|---|---|---|
| 1 | 2.600 | 0 | 2.600 |
| 2 | 2.700 | 2.600 | 100 |
| 5 | 3.000 | 2.900 | 100 |
| 10 | 3.500 | 3.400 | 100 |
| Los 10 turnos | 30.500 | 27.000 | 3.500 |
En el conjunto de la llamada, 27.000 de los 30.500 tokens del prompt (alrededor del 89 %) proceden de la caché. A partir del segundo turno, el modelo lee 100 tokens nuevos en lugar de más de 2.600.
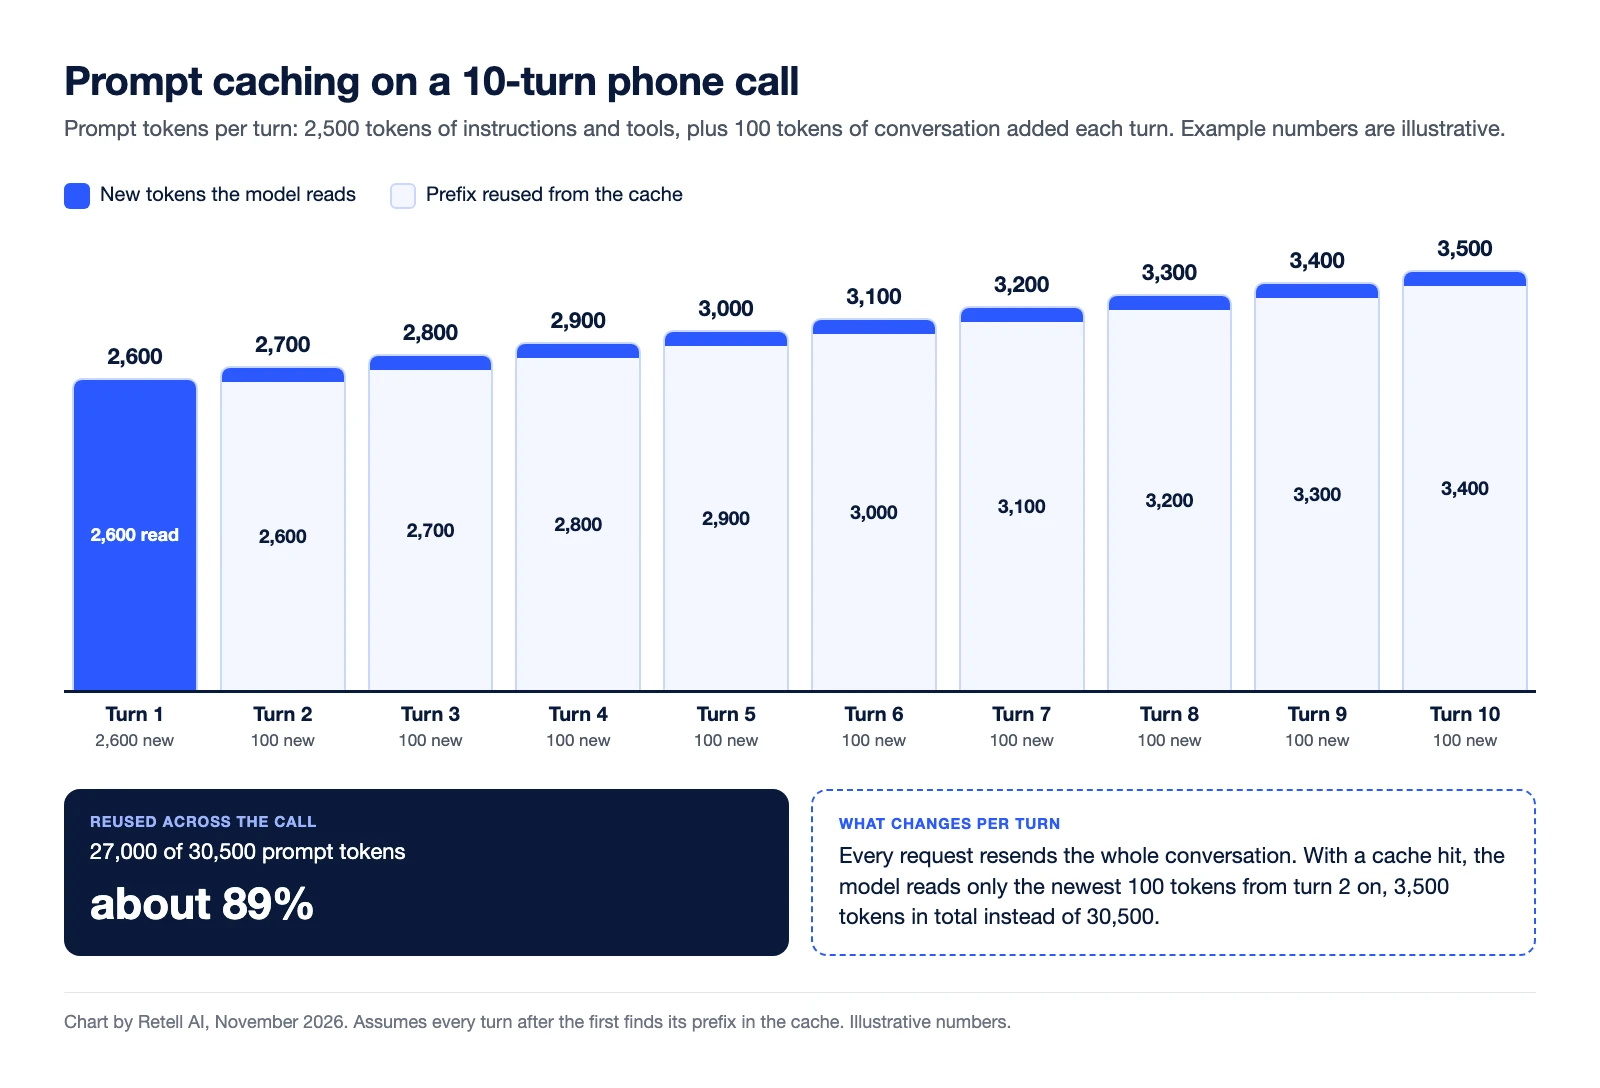
Esto importa por dos motivos. El tiempo hasta el primer token forma parte de la latencia que quien llama percibe como silencio, y leer un prompt largo lleva tiempo. El segundo es el coste: Anthropic cobra las lecturas de caché a 0,1 veces el precio base del token de entrada, y las escrituras en caché a 1,25 veces para la vida útil de 5 minutos.
¿Qué impide un acierto de caché?
- Un prefijo modificado. Una marca de tiempo, el nombre de quien llama o una lista de herramientas reordenada cerca del principio del prompt cambia todos los tokens que vienen después.
- Una pausa más larga que la vida útil de la caché.
- Que la solicitud llegue a otra máquina. La guía de OpenAI señala que «los estados en caché residen en máquinas individuales» y que una solicitud puede reutilizar un prefijo «solo si llega a una máquina que tenga una entrada coincidente que no haya caducado».
El enrutamiento puede cerrar esa última brecha. Tell-1, el LLM propio de Retell, mantiene cada llamada en las GPU que ya la tienen en caché mediante afinidad de sesión. Según el artículo técnico sobre el LLM de Retell, esto casi duplica la proporción de tokens del prompt servidos desde la caché, del 36 % al 69 %, de modo que en cada turno hay menos que leer y las respuestas empiezan antes.
La caché no cambia la respuesta. Las notas de diseño de vLLM indican que la caché de prefijos «no cambiará los resultados del modelo».
Dónde encajan los agentes de voz con IA
La guía de resolución de problemas de latencia de Retell expone directamente el coste de la longitud del prompt: «Cada token de tu prompt se suma al tiempo hasta el primer token, y ese coste se paga en cada turno de la conversación».
Si conectas tu propio modelo a través del LLM WebSocket de Retell, cada solicitud de respuesta llega con la «transcripción en directo completa recopilada en la llamada hasta el momento». Tu servidor construye el prompt, así que el comportamiento de la caché depende de cómo lo construyas y de tu proveedor de modelos: mantén las instrucciones y las herramientas al principio y sin cambios, y añade la transcripción después. Para ver el recorrido completo de un turno, consulta cómo funciona la IA de voz en tiempo real.
Preguntas frecuentes sobre la caché de prompts
¿Qué diferencia hay entre la caché de prompts y la caché KV?
La caché KV es el estado de atención almacenado que un modelo construye mientras lee tokens. La caché de prompts conserva ese estado después de que termine una solicitud para que una solicitud posterior con los mismos tokens iniciales pueda reutilizarlo.
¿La caché de prefijos es lo mismo que la caché de prompts?
Son el mismo mecanismo. Caché de prefijos es el término que usan los motores de inferencia. Caché de prompts es el nombre de producto que usan los proveedores de modelos en sus API.
¿La caché de prompts cambia la respuesta del modelo?
No. Solo evita recalcular el prefijo compartido.
¿Cuánto dura una caché de prompts?
Depende del proveedor. El valor predeterminado de Anthropic es de 5 minutos, renovado con cada uso, con una opción de 1 hora a un precio de escritura más alto. Las vidas útiles de OpenAI dependen del modelo.
¿Por qué importa la caché de prompts para los agentes de voz?
Cada turno de una llamada reenvía las instrucciones y la conversación hasta ese momento. Con un acierto de caché, el modelo solo lee el intercambio más reciente.
Comprueba la diferencia en tus propias llamadas
Retell AI es una plataforma de agentes de voz con IA para centros de contacto. Tell-1 es su propio LLM, creado para llamadas telefónicas. Su documentación explica cómo consultar la latencia de cada llamada por componente, para que veas qué parte de la espera corresponde al modelo. Habla con el equipo de Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


