LLM como juez (LLM as a judge) es un método de evaluación en el que un modelo de lenguaje de gran tamaño puntúa o clasifica la salida de otro sistema de IA según unos criterios escritos, en lugar de un revisor humano. Los equipos lo usan para calificar trabajo abierto, como una conversación telefónica, que no tiene una única respuesta correcta.
El nombre procede de un artículo de 2023, Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Sus autores observaron que jueces potentes como GPT-4 coincidían con las preferencias humanas con "más del 80 % de acuerdo, el mismo nivel de acuerdo que entre humanos". También señalaron sus límites: los sesgos de posición, de verbosidad y de autofavorecimiento.
¿Cómo puntúa una conversación un juez LLM?
Un juez LLM lee la conversación y un conjunto de instrucciones, y después devuelve un veredicto de una de estas tres formas.
| Método | Qué hace el juez | Qué devuelve | Dónde encaja |
|---|---|---|---|
| Calificación con rúbrica | Lee una transcripción según criterios escritos | Aprobado o suspenso, o una puntuación, con un motivo | QA en producción y pruebas de regresión |
| Clasificación por pares | Compara dos o más respuestas al mismo turno | Un ganador o un orden de clasificación | Elegir entre prompts o modelos |
| Panel de jueces | Varios modelos juez califican el mismo elemento y se agregan los veredictos | Una puntuación agregada | Puntuaciones que el sesgo de un solo modelo podría distorsionar |
Calificación con rúbrica. En el artículo de G-Eval, el juez razonaba a partir de los criterios y después rellenaba un formulario de puntuación. En tareas de resumen, sus puntuaciones se correlacionaron con las valoraciones humanas mejor que los métodos anteriores.
Clasificación por pares. Preguntar cuál de dos respuestas es mejor se adapta bien a cualidades como el tono, donde una diferencia es más fácil de ver que de puntuar.
Paneles de jueces. En Replacing Judges with Juries, un panel de modelos más pequeños de distintas familias "supera a un único juez de gran tamaño, muestra menos sesgo intramodelo" y resultó "más de siete veces más barato".
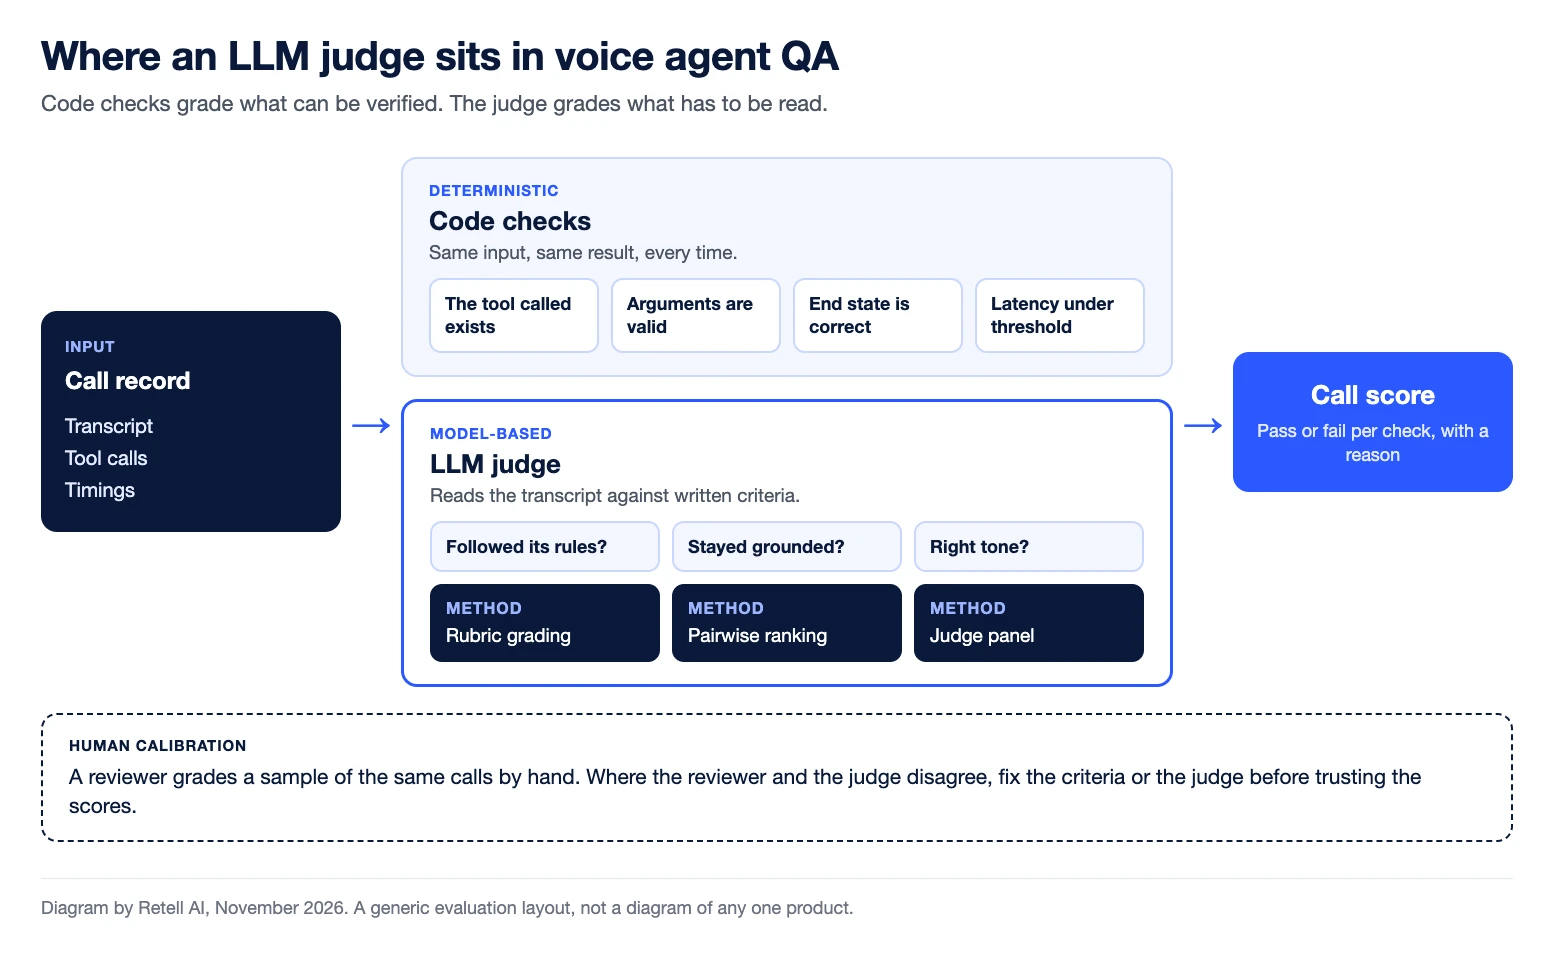
¿Cómo se usa LLM como juez en el QA y los benchmarks de agentes de voz?
El QA de agentes de voz usa un juez LLM para las partes de una llamada que solo la lectura de la transcripción puede resolver: si el agente siguió sus reglas, se ciñó a sus fuentes y resolvió la solicitud.
La documentación de Retell muestra las dos configuraciones habituales. En AI QA, una condición evaluada por IA es "una comprobación cualitativa que la IA ejecuta sobre la transcripción y el contexto de cada llamada", redactada como "el prompt que usa la IA para juzgar si se cumple la condición". En las pruebas de simulación, una IA hace de llamante y "cada ejecución se califica como aprobada o suspendida con una explicación por escrito".
Los benchmarks ofrecen el mismo tipo de veredicto a escala. El Retell vCX Benchmark publica la puntuación de cada conjunto como una tasa de aprobados, "el porcentaje de escenarios probados que gestionó correctamente", en seguimiento de instrucciones, fidelidad a las fuentes, llamadas a herramientas y habla coloquial (consultado el 13 de noviembre de 2026).
Para convertir los veredictos en una revisión semanal, consulta la scorecard de QA para agentes de voz.
¿Cuáles son los modos de fallo conocidos de un juez LLM?
Un juez LLM falla de cuatro formas documentadas. Cada una tiene una comprobación conocida.
- Sesgo de posición. En Large Language Models are not Fair Evaluators, intercambiar el orden de dos respuestas permitió que un modelo ganara "66 de 80 consultas probadas". Ejecuta cada comparación en ambos órdenes.
- Autopreferencia. Un estudio de 2024 observó que un evaluador "puntúa sus propias salidas por encima de las de otros, mientras que los anotadores humanos las consideran de igual calidad". Usa un juez de una familia de modelos distinta, o un panel.
- Escaso acuerdo con los humanos. Judging the Judges probó trece modelos juez y concluyó que "solo los mejores (y más grandes) modelos logran una alineación razonable con los humanos", con "una tendencia a la indulgencia". Califica una muestra a mano y compara.
- Deriva. El modelo que hay detrás de una API puede cambiar: un estudio midió cómo la precisión de GPT-4 caía del 84 % al 51 % en la misma tarea en tres meses. Los criterios también cambian. Who Validates the Validators? lo llama deriva de criterios: "los usuarios necesitan criterios para calificar las salidas, pero calificar las salidas ayuda a los usuarios a definir los criterios". Fija la versión del juez y vuelve a ejecutar un conjunto fijo etiquetado a mano después de cualquier cambio.
Además, los jueces no son deterministas. La documentación de simulación de Retell aconseja: "Juzga un escenario por su tasa de aprobados en varias ejecuciones, no por una sola."
¿Cuándo son mejores las comprobaciones por código que un juez LLM?
Las comprobaciones por código superan a un juez LLM siempre que la respuesta se pueda verificar en lugar de leer. La guía de Anthropic sobre evaluaciones de agentes recomienda "elegir evaluadores deterministas siempre que sea posible y evaluadores LLM cuando sea necesario". Describe los evaluadores basados en código como rápidos, baratos, objetivos y reproducibles, y los basados en modelos como no deterministas.
En una llamada, el código puede comprobar que la herramienta que llamó el agente existe, que sus argumentos son válidos y que el tiempo de respuesta se mantuvo por debajo de un umbral. tau-bench califica conversaciones completas de esta forma, comparando "el estado de la base de datos al final de una conversación con el estado objetivo anotado".
AI QA de Retell mantiene ambas cosas separadas: las métricas de rendimiento son umbrales cuantitativos y las condiciones evaluadas por IA se encargan de las comprobaciones cualitativas. Cómo probar y publicar cambios en agentes de voz explica dónde se ejecuta cada una.
¿Cómo se usan los paneles de jueces para entrenar un modelo de voz?
Tell-1, el LLM propio de Retell, usó jueces LLM en dos de sus tres fases de entrenamiento, según el artículo técnico sobre el LLM de Retell. La fase de ajuste por preferencias aprendió de "pares de preferencia clasificados por un panel de jueces LLM".
En la fase de aprendizaje por refuerzo, según el artículo, "el modelo escribe ocho respuestas y cada una de ellas se puntúa". El código se ejecuta primero: las llamadas a herramientas fuera del conjunto de herramientas del agente, las salidas mal formadas y otros errores críticos "se detectan en el código antes de que ningún juez los vea". Para la corrección, "varios modelos juez califican la corrección de las llamadas a herramientas, las alucinaciones y el seguimiento de instrucciones, y sus veredictos se agregan en una única señal de recompensa". Para la naturalidad, un único juez clasifica las ocho respuestas en paralelo según una rúbrica, porque "la naturalidad es más fácil de comparar que de puntuar".
Ese es el patrón que describe esta página: comprobaciones por código para lo que se puede verificar, un panel de jueces para la corrección y clasificación para el tono.
Preguntas frecuentes sobre LLM como juez
¿Qué hace un juez LLM?
Lee una salida, como la transcripción de una llamada, junto con unas instrucciones de calificación, y devuelve un veredicto: aprobado o suspenso, una puntuación o una preferencia entre dos opciones.
¿Qué fiabilidad tiene LLM como juez?
Depende del modelo juez y de la tarea. Un estudio halló más del 80 % de acuerdo con las preferencias humanas; otro concluyó que solo los jueces más grandes se alineaban razonablemente con los humanos. Contrasta primero un juez con llamadas calificadas a mano.
¿Qué es un panel de jueces?
Un panel de jueces son varios modelos juez que califican la misma salida y cuyos veredictos se agregan. Reduce el efecto del sesgo de cualquier modelo individual.
¿Cuál es la diferencia entre la calificación con rúbrica y la clasificación por pares?
La calificación con rúbrica puntúa una salida según criterios escritos. La clasificación por pares muestra al juez dos salidas y le pregunta cuál es mejor.
¿Puede un juez LLM puntuar una llamada de voz?
Sí, a partir de la transcripción y las llamadas a herramientas. Las cualidades que residen en el audio también necesitan el audio: la documentación de Retell indica que Agent Naturalness se "evalúa usando tanto el audio como la transcripción".
Puntúa tus propias llamadas antes de escalar
Retell AI es una plataforma de agentes de voz con IA para centros de contacto. AI QA evalúa una muestra de tus llamadas según las condiciones y los umbrales que definas, con evidencias de la transcripción para cada resultado.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


