La afinidad de sesión, también llamada sticky sessions o persistencia de sesión, es una técnica de balanceo de carga que envía todas las peticiones de un mismo cliente o sesión al mismo servidor backend, de modo que el estado guardado en la memoria de ese servidor siga siendo accesible.
Sin ella, cada petición se asigna por separado. AWS indica que un Application Load Balancer, por defecto, "enruta cada petición de forma independiente a un destino registrado", y que la función de sticky sessions le permite "vincular la sesión de un usuario a un destino concreto". Esto importa cuando un servidor guarda localmente algo que necesita la siguiente petición: una sesión iniciada, un carrito de la compra o una caché.
¿Cómo implementan los balanceadores de carga la afinidad de sesión?
Un balanceador de carga necesita una forma de reconocer la sesión y una regla que la asigne a un servidor. Tres métodos cubren la mayoría de los productos.
Cookie. El balanceador de carga establece una cookie en la primera respuesta y la lee en las peticiones posteriores. La persistencia basada en duración de AWS usa una cookie llamada AWSALB con una vida útil que tú defines entre 1 segundo y 7 días. HAProxy usa una cookie para "recordar a qué servidor se enrutó antes al cliente". El cliente tiene que admitir cookies.
Hash de IP. La dirección IP del cliente determina el servidor. ip_hash de NGINX usa "los tres primeros octetos de la dirección IPv4 del cliente, o la dirección IPv6 completa" como clave de hash. Un Service de Kubernetes ofrece la misma idea con sessionAffinity: ClientIP, con un tiempo de espera predeterminado de 3 horas. Ninguno necesita cookies, pero los clientes detrás de una misma dirección compartida acaban en el mismo servidor y, con NGINX, también todos los que comparten esos tres octetos.
Hashing consistente. El balanceador de carga aplica un hash a una propiedad de la petición, como una cabecera o un ID de sesión, sobre un anillo de servidores. Envoy indica que, con un anillo bien particionado, añadir o quitar un host de un conjunto de N "solo afectará a 1/N de las peticiones". La directiva hash de NGINX tiene una opción consistent que, según su documentación, "ayuda a lograr una mayor tasa de aciertos de caché en servidores de caché".
| Método | Qué identifica la sesión | Ejemplo documentado | Principal limitación |
|---|---|---|---|
| Cookie | Una cookie establecida por el balanceador de carga o la aplicación | AWS Application Load Balancer, HAProxy | El cliente debe admitir cookies |
| Hash de IP | La dirección IP del cliente | NGINX ip_hash, Kubernetes ClientIP | Los clientes detrás de una dirección compartida se acumulan en un solo servidor |
| Hashing consistente | Cualquier propiedad de la petición que elijas | Ring hash y Maglev de Envoy, NGINX hash ... consistent | Cada petición debe llevar una clave estable |
| Enrutamiento por prefijo | Los tokens iniciales de un prompt de LLM | Prompt caching de OpenAI, Ray Serve | La carga sigue contando, así que un servidor ocupado puede perder la petición |
¿Qué ventajas e inconvenientes tienen las sticky sessions?
La afinidad de sesión sacrifica algo de equilibrio y resiliencia a cambio de mantener el estado cerca.
- La carga puede desequilibrarse. Google Cloud indica que la afinidad "funciona bien cuando hay una distribución razonablemente amplia de conexiones únicas". Con pocas sesiones o sesiones desiguales, algunos servidores soportan más carga, lo que va en contra de la escalabilidad.
- Un servidor caído rompe la afinidad. En AWS, si un destino falla, el balanceador de carga "elige un nuevo destino en buen estado" y mantiene ahí la sesión "aunque el destino que falló vuelva a estar disponible". Todo lo que estuviera solo en la memoria del servidor anterior tiene que reconstruirse.
- Funciona en la medida de lo posible. Google Cloud ofrece la afinidad de sesión "según el principio de mejor esfuerzo" y enumera cambios en las comprobaciones de estado, backends añadidos o eliminados y backends saturados como eventos que pueden romperla.
La documentación de HAProxy da el consejo habitual: "A menudo, lo óptimo es evitar por completo la persistencia de sesión diseñando tus servicios para que no tengan estado", por ejemplo, guardando el estado en una base de datos compartida. La afinidad es para el estado que no puedes mover de forma barata. Una caché es el caso típico.
¿Por qué importa la afinidad de sesión al servir LLM?
Importa porque la caché que abarata un prompt repetido reside en una sola máquina. Un servidor de modelos guarda en memoria el estado calculado de un prompt, la caché KV. vLLM la reutiliza cuando una nueva consulta "comparte el mismo prefijo con una de las consultas existentes, lo que permite a la nueva consulta omitir el cálculo de la parte compartida".
Esto solo funciona si la siguiente petición llega a la misma máquina. La guía de prompt caching de OpenAI lo dice claramente: "Los estados en caché residen en máquinas individuales" y "una petición solo puede reutilizar un prefijo en caché si llega a una máquina que tenga una entrada coincidente que no haya caducado". OpenAI enruta según la carga de la máquina, un hash de los tokens iniciales del prompt y, en modelos más antiguos, una clave de caché que tú proporcionas. Para modelos autoalojados, Ray Serve incluye un router que "envía las peticiones con prefijos similares a las mismas réplicas, maximizando la tasa de aciertos de la caché KV", y recurre al balanceo de carga simple cuando las colas están desequilibradas.
Las llamadas telefónicas encajan muy bien en este patrón. En cada turno de una conversación de varios turnos, un agente de voz envía al modelo de lenguaje de gran tamaño sus instrucciones más la transcripción hasta ese momento, porque el modelo no conserva la llamada entre peticiones. Cada petición repite la mayor parte de la anterior. Así que la llamada es la sesión y el ID de llamada es una clave natural. Un turno que llega a otro servidor vuelve a procesar todo el prompt, lo que aumenta la latencia.
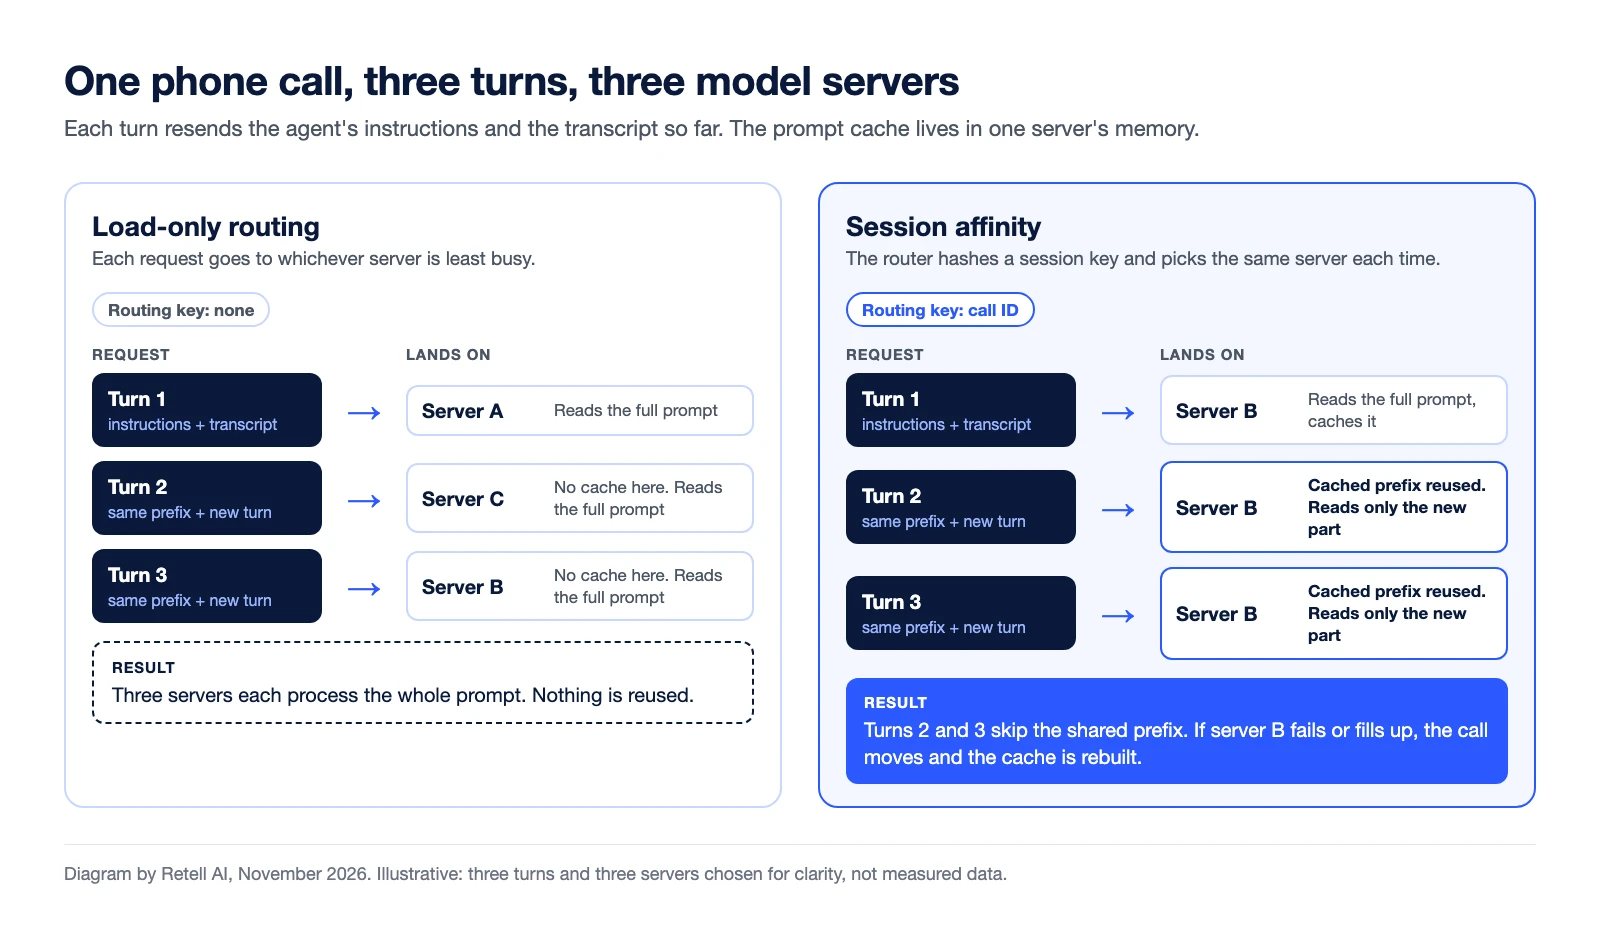
Tell-1, el LLM propio de Retell, se sirve de esta manera. El artículo técnico sobre el LLM de Retell lo llama enrutamiento consciente de la llamada: cada turno reenvía toda la conversación, así que cada llamada se mantiene en las GPU que ya la tienen en caché. Según el artículo, eso elevó la proporción de tokens de prompt servidos desde caché del 36 % al 69 %.
Dónde aparece la afinidad de sesión en Retell
Aparece cuando ejecutas tu propio servidor de modelos. Con un LLM personalizado, Retell "abre un WebSocket a tu servidor para cada llamada", con el ID de llamada como último segmento de la ruta de la URL. AWS señala que "las conexiones WebSocket son persistentes por naturaleza", así que una llamada permanece en uno de tus servidores mientras su socket está abierto.
Las buenas prácticas de Retell recomiendan mantener "un estado explícito por llamada en tu servidor, indexado por el ID de llamada de la URL del WebSocket". Retell también restablece una conexión que se cae a mitad de llamada y, si ejecutas varios servidores detrás de un balanceador de carga, el nuevo socket puede llegar a otro distinto. Para que el estado siga accesible, enruta según el ID de llamada de la ruta o guarda ese estado en un almacén compartido. El hash de IP no repartirá la carga en este caso: la guía de configuración indica una única dirección IP saliente para esta conexión, así que todas las llamadas generan el mismo hash y van al mismo servidor.
Preguntas frecuentes sobre la afinidad de sesión
¿La afinidad de sesión es lo mismo que las sticky sessions?
Sí. AWS describe su función de sticky sessions como "también conocida como afinidad de sesión". Persistencia de sesión es un tercer nombre para lo mismo.
¿Qué le ocurre a una sticky session cuando el servidor falla?
El balanceador de carga elige otro servidor en buen estado y la sesión se queda ahí. El estado que solo estaba en la memoria del servidor caído se pierde, salvo que también se guardara en un lugar compartido.
¿Las conexiones WebSocket necesitan sticky sessions?
No mientras la conexión esté abierta, porque todos los mensajes viajan por la misma conexión al mismo servidor. La afinidad vuelve a importar cuando el cliente se reconecta.
¿Por qué importa la afinidad de sesión para el prompt caching?
Una caché de prompts reside en la memoria de la máquina que la generó. Una petición posterior solo obtiene el prefijo en caché si se enruta a esa máquina.
Lleva tu propio modelo a llamadas en directo
Retell AI es una plataforma de agentes de voz con IA para centros de contacto. Retell gestiona la telefonía, la transcripción, la toma de turnos y la voz, y la integración de LLM personalizado conecta tu servidor de modelos mediante un WebSocket por llamada.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


