SSML (Speech Synthesis Markup Language, lenguaje de marcado de síntesis de voz) es un lenguaje de marcado basado en XML que indica a un motor de conversión de texto a voz cómo decir un fragmento de texto: dónde hacer pausas, cómo pronunciar una palabra, cómo leer un número o una fecha y con qué velocidad, volumen o tono hablar. El motor lee las etiquetas como instrucciones y no las pronuncia.
SSML es un estándar del World Wide Web Consortium (W3C). La versión actual, SSML 1.1, se convirtió en Recomendación del W3C el 7 de septiembre de 2010 y la elaboró el Voice Browser Working Group del W3C. La especificación define su propósito como ofrecer a los autores «una forma estándar de controlar aspectos del habla como la pronunciación, el volumen, el tono, la velocidad, etc. en distintas plataformas con capacidad de síntesis».
¿Qué aspecto tiene SSML?
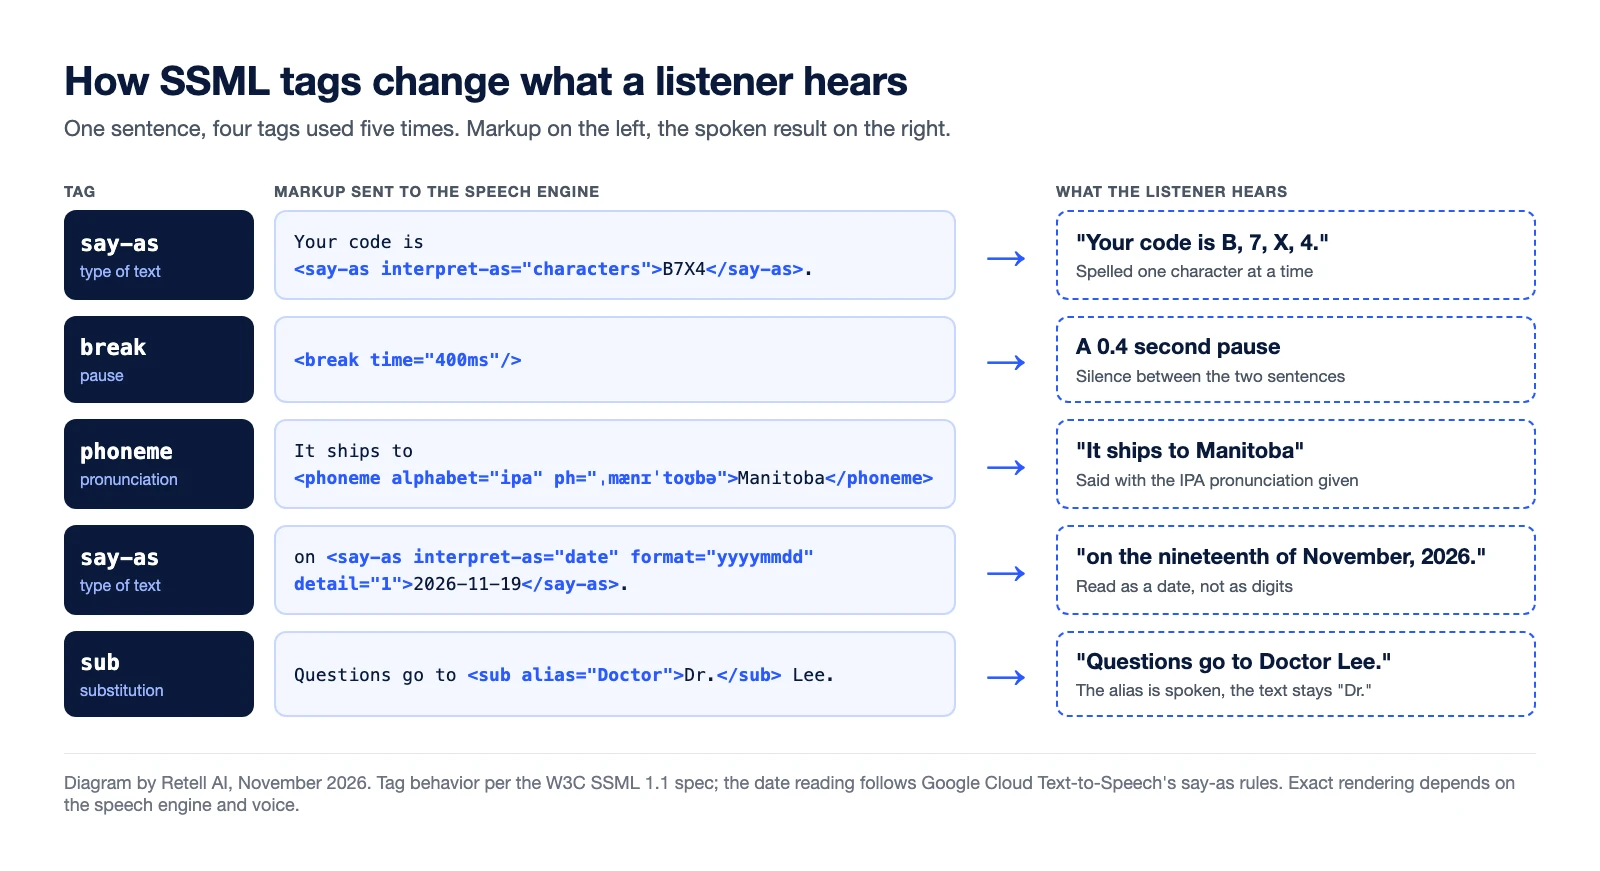
Un documento SSML es XML con un único elemento raíz, <speak>. Este breve ejemplo es SSML 1.1 válido:
<speak version="1.1" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="en-US">
  Your code is <say-as interpret-as="characters">B7X4</say-as>.
  <break time="400ms"/>
  It ships to <phoneme alphabet="ipa" ph="ˌmænɪˈtoʊbə">Manitoba</phoneme>
  on <say-as interpret-as="date" format="yyyymmdd" detail="1">2026-11-19</say-as>.
  Questions go to <sub alias="Doctor">Dr.</sub> Lee.
</speak>
La figura muestra lo que oye quien escucha con cada etiqueta cuando el motor la admite.
¿Cuáles son las etiquetas SSML más habituales?
Las descripciones siguen la especificación del W3C.
| Etiqueta | Qué hace | Ejemplo |
|---|---|---|
<speak> | Elemento raíz de todo documento SSML. En SSML 1.1 los atributos version y xml:lang son obligatorios, además del espacio de nombres de SSML. | <speak version="1.1" xml:lang="en-US"> |
<break> | Añade una pausa o un límite prosódico, definido por strength (de none a x-strong) o por time. | <break time="400ms"/> |
<say-as> | Indica al motor qué tipo de texto está leyendo, como una fecha, una hora, un número o un importe en moneda. | <say-as interpret-as="characters">B7X4</say-as> |
<phoneme> | Proporciona una pronunciación fonética para el texto que encierra. La especificación indica que los motores deberían admitir el alfabeto ipa. | <phoneme alphabet="ipa" ph="..."> |
<sub> | Pronuncia el valor de alias en lugar del texto escrito. | <sub alias="Doctor">Dr.</sub> |
<prosody> | Cambia el tono, la velocidad del habla y el volumen del texto que encierra. | <prosody rate="slow"> |
<emphasis> | Solicita énfasis en una palabra o frase, con un level de strong, moderate, none o reduced. | <emphasis level="strong"> |
Dos detalles de la especificación explican por qué los resultados varían. En primer lugar, define <say-as> pero «no enumera los valores posibles de los atributos», así que la lista de valores de interpret-as es propia de cada proveedor. En segundo lugar, califica los valores de prosodia como «orientativos» y deja que el motor decida cómo reproducir el énfasis.
¿En qué difiere la compatibilidad con SSML entre motores de voz?
Cada motor implementa su propio subconjunto, y los modelos de voz más recientes suelen admitir menos marcado que los anteriores. Según la documentación de cada proveedor, consultada el 13 de noviembre de 2026:
- Google Cloud Text-to-Speech admite «un subconjunto de las etiquetas SSML disponibles». Sus voces Chirp 3: HD aceptan diez etiquetas sin
<emphasis>, las demás etiquetas «se ignorarán» y las solicitudes en streaming no admiten SSML. - Amazon Polly detalla la compatibilidad de etiquetas por tipo de voz.
<emphasis>no está disponible en las voces neuronales, de formato largo ni generativas, y una etiqueta no admitida en voces estándar, neuronales o de formato largo devuelve un error. - Azure AI Speech basa su implementación en SSML 1.0 y señala que sus elementos admitidos «pueden diferir del estándar del W3C». Añade sus propios elementos
msttspara estilos de habla, y el énfasis a nivel de palabra funciona en tres voces en inglés concretas. - ElevenLabs admite dos etiquetas SSML en algunos modelos:
<break>para pausas de hasta 3 segundos y<phoneme>solo en Flash v2. Eleven v3 y v4 no admiten etiquetas break. - Cartesia Sonic documenta sus propias etiquetas «similares a SSML»: velocidad, volumen, emoción, pausa y deletreo.
Un mismo documento puede ser respetado por un motor, ignorado sin aviso por otro y rechazado por un tercero. Prueba el marcado con la voz y el modelo exactos que vayas a usar.
¿Por qué importa SSML en los agentes de voz?
Quien llama no puede ver el texto. En la IA de voz, una lectura errónea cuesta una repetición o un registro incorrecto:
- Nombres. Pronunciaciones de marcas, medicamentos y apellidos que la voz adivina mal.
- Números. Un código de confirmación leído como una sola palabra o un número de cuenta leído como una cantidad.
- Fechas y horas. Una fecha como 11/19 leída como dos números separados.
- Pausas. Tiempo para anotar cada grupo de un número de teléfono.
SSML encaja con los mensajes guionizados, en los que un desarrollador etiqueta cada línea una sola vez. Eso encaja con un menú de IVR. Encaja peor con un agente de voz con IA en directo.
¿Cómo gestionan la pronunciación sin SSML los agentes de voz basados en LLM?
En un agente basado en LLM, un modelo de lenguaje de gran tamaño redacta cada respuesta durante la llamada y el texto se transmite al motor de voz a medida que se genera (cómo funciona el proceso de STT, LLM y TTS). Nadie etiqueta las frases a mano, y el streaming añade un problema: la documentación de Cartesia advierte de que una etiqueta de velocidad o volumen dividida entre tokens transmitidos se lee en voz alta. En su lugar, los equipos usan cuatro métodos:
- Prompts para texto pronunciable. Indica al modelo que escriba «cuatro uno cinco» en lugar de «415».
- Normalización de texto. Un paso previo a la síntesis convierte números, fechas y monedas a su forma hablada.
- Un diccionario de pronunciación. Una lista de palabras con transcripciones fonéticas que se aplica a cada respuesta.
- Controles de voz de la plataforma. Marcadores en línea que la plataforma traduce para cada proveedor de voz.
¿Cómo gestiona Retell AI las pausas y la pronunciación?
La documentación de Retell AI no describe la entrada de SSML sin procesar. Documenta estos controles:
- Pausas y deletreo. Según la documentación de controles de voz, un guion con un espacio a cada lado añade una pausa, y las etiquetas
<spell>leen un código o un número de cuenta carácter a carácter. Retell convierte la etiqueta «al formato que mejor funciona para la voz de tu agente». - Diccionario de pronunciación. Las entradas admiten una palabra y un fonema en IPA, CMU, Pinyin o Jyutping. Las voces de la plataforma Retell admiten IPA y CMU, y algunos modelos de proveedores no admiten ninguno.
- Speech Normalization. Un ajuste predefinido del Agent Handbook, desactivado por defecto, que convierte números, fechas, importes y números de teléfono a su forma hablada.
Consulta también cómo funcionan los agentes de voz con IA en una llamada.
Preguntas frecuentes sobre SSML
¿Para qué se usa SSML?
Controla cómo un motor de conversión de texto a voz lee el texto en voz alta: pausas, pronunciación, lectura de números y fechas, y tono, velocidad y volumen.
¿SSML es igual en todos los motores de conversión de texto a voz?
No. Cada motor admite su propio subconjunto de la especificación del W3C y añade sus propias etiquetas, así que el marcado suele necesitar cambios entre motores.
¿ElevenLabs admite SSML?
En parte. Su documentación describe etiquetas break para pausas de hasta 3 segundos y etiquetas phoneme en el modelo Flash v2. Eleven v3 y v4 no admiten etiquetas break (a noviembre de 2026).
¿Qué diferencia hay entre SSML y un diccionario de pronunciación?
Las etiquetas SSML se sitúan dentro de un fragmento de texto y solo se aplican ahí. Un diccionario de pronunciación es una lista de palabras independiente que el motor o la plataforma aplica a cada palabra coincidente.
¿Los agentes de voz con IA usan SSML?
Algunos sí, cuando el motor de voz lo acepta. Muchos se basan en prompts, normalización de texto y diccionarios de pronunciación, porque las respuestas se generan en directo y algunos modelos de voz más recientes apenas aceptan SSML.
Haz que cada nombre y cada número suenen bien
Retell AI es una plataforma de agentes de voz con IA para centros de contacto. Puedes controlar las pausas, el deletreo y la pronunciación de cada agente y escuchar el resultado en una prueba de llamada web. Habla con el equipo de Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


