La decodificación especulativa es una técnica para acelerar un modelo de lenguaje de gran tamaño: un pequeño modelo borrador intenta adivinar los siguientes tokens y el modelo grande los comprueba todos en una sola pasada, conservando los que él mismo habría generado.
El método procede de dos artículos de investigación. Google Research le dio nombre en Fast Inference from Transformers via Speculative Decoding (Leviathan, Kalman y Matias, publicado por primera vez en noviembre de 2022). DeepMind describió su propia versión, desarrollada de forma independiente, en Accelerating Large Language Model Decoding with Speculative Sampling (Chen y colaboradores, febrero de 2023).
¿Por qué es lenta la decodificación estándar?
La decodificación estándar es lenta porque un modelo de lenguaje de gran tamaño escribe un token cada vez, y cada token requiere una ejecución completa del modelo. El artículo de Google lo resume en una línea: «decodificar K tokens requiere K ejecuciones en serie del modelo».
Muchos de esos tokens son fáciles de predecir. El mismo artículo observa que «las tareas difíciles de modelado del lenguaje suelen incluir subtareas más sencillas que pueden aproximarse bien con modelos más eficientes».
¿Cómo colaboran el modelo borrador y el modelo completo?
Los dos modelos trabajan por rondas, y cada ronda tiene tres partes:
- Borrador. El modelo pequeño escribe una breve serie de conjeturas, un token tras otro. El artículo de Google lo llama modelo de aproximación; DeepMind lo llama modelo borrador.
- Verificación. El modelo grande, llamado modelo objetivo, puntúa en paralelo todas las posiciones conjeturadas, en una sola pasada.
- Aceptación o corrección. Las conjeturas se aceptan de izquierda a derecha. En la primera conjetura rechazada, el modelo grande aporta su propio token y se descartan las conjeturas posteriores. Si se aceptan todas, el modelo grande añade un token más.
Cada pasada del modelo grande produce como mínimo un token y como máximo el número de conjeturas más uno, por lo que nunca necesita más pasadas que la decodificación estándar.
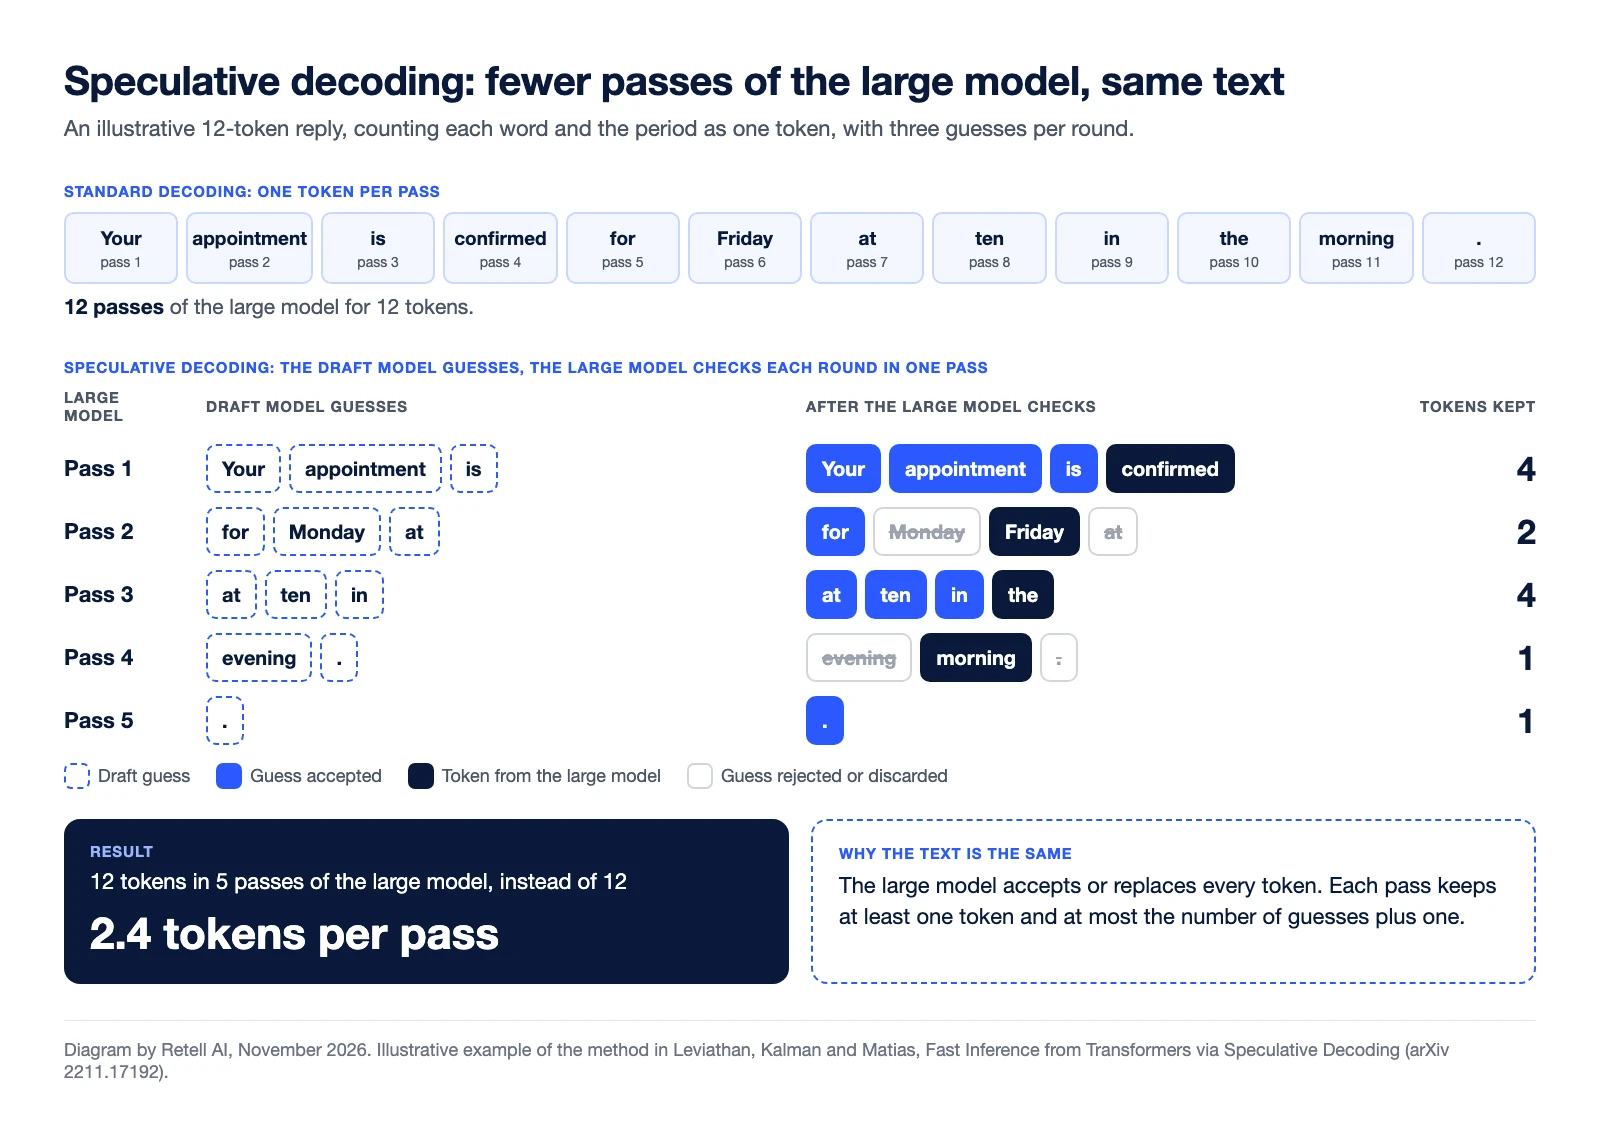
Ejemplo práctico (ilustrativo). Una respuesta de 12 tokens en inglés, contando cada palabra y el punto como un token, con tres conjeturas por ronda:
| Pasada del modelo grande | Conjeturas del modelo borrador | Veredicto del modelo grande | Tokens conservados |
|---|---|---|---|
| 1 | Your appointment is | Se aceptan las tres; añade «confirmed» | 4 |
| 2 | for Monday at | «for» aceptada. «Monday» rechazada y sustituida por «Friday». «at» descartada | 2 |
| 3 | at ten in | Se aceptan las tres; añade «the» | 4 |
| 4 | evening . | «evening» rechazada y sustituida por «morning». Se descarta el punto | 1 |
| 5 | . | Aceptada, y la respuesta termina | 1 |
| Total | 12 tokens en 5 pasadas |
La decodificación estándar necesita 12 pasadas del modelo grande para esta frase. Aquí se ejecuta 5 veces, una media de 2,4 tokens por pasada.
¿Por qué no cambia el resultado?
El resultado no cambia porque el modelo grande tiene la última palabra sobre cada token. Con la decodificación voraz (greedy), en la que el modelo siempre elige su opción principal, una conjetura solo se conserva si es el token que el modelo grande habría elegido. La documentación de vLLM incluye una prueba precisamente para esto: el muestreo voraz con decodificación especulativa «coincide con el muestreo voraz sin ella».
Con el muestreo aleatorio, una conjetura se acepta con una probabilidad que depende de cómo la valoran ambos modelos, y una conjetura rechazada se vuelve a extraer de una distribución ajustada. El artículo de Google demuestra que esto mantiene intacta la distribución de salida. En palabras de DeepMind, el esquema «preserva la distribución del modelo objetivo dentro de la precisión numérica del hardware».
Algunas variantes más recientes relajan la comprobación a propósito para ganar velocidad. vLLM señala que uno de sus métodos de verificación «no preserva la distribución».
¿Cuándo ayuda la decodificación especulativa y cuándo no?
La decodificación especulativa ayuda cuando el modelo borrador es barato y suele acertar, y el servidor dispone de capacidad de cómputo libre.
| Condición | Efecto en la velocidad | Fuente |
|---|---|---|
| Las conjeturas suelen aceptarse | Más tokens por pasada. Tokens esperados por pasada = (1 − α^(γ+1)) ÷ (1 − α), donde α es la tasa de aceptación y γ el número de conjeturas por ronda | Artículo de Google |
| El modelo borrador es mucho más pequeño que el objetivo | Bajo coste de generación del borrador. Un borrador unos dos órdenes de magnitud más pequeño «solía dar los mejores resultados» | Artículo de Google |
| Hay capacidad de cómputo libre | Imprescindible. El método presupone «recursos de cómputo suficientes para soportar la mayor concurrencia» | Artículo de Google |
| Mucho tráfico en el servidor | Menor ganancia. vLLM califica un modelo borrador de «ganancia alta» con tasas de solicitudes bajas y de «ganancia media» con tasas altas | Documentación de vLLM |
| El borrador falla demasiado para lo que cuesta | Sin ganancia. Solo hay aceleración cuando la tasa de aceptación supera el coste del borrador en relación con el objetivo | Artículo de Google |
A modo de ejemplo, una tasa de aceptación de 0,6 con tres conjeturas por ronda da unos 2,2 tokens por pasada.
Aceleraciones publicadas: el artículo de Google informa de entre 2x y 3x en un modelo T5-XXL de 11.000 millones de parámetros. DeepMind informa de entre 2 y 2,5 veces en Chinchilla, de 70.000 millones de parámetros, con un borrador de 4.000 millones de parámetros. Los resultados dependen de los modelos, la tarea y el hardware.
Un ejemplo en producción en el ámbito de la voz: Tell-1, el LLM propio de Retell, utiliza la decodificación especulativa para obtener unos cuatro tokens de cada pasada del modelo completo, según el artículo técnico de Retell sobre Retell LLM.
¿Por qué importa la decodificación especulativa en la voz en tiempo real?
La decodificación especulativa importa en la voz en tiempo real porque quien llama percibe el tiempo del modelo como silencio. En una llamada, el modelo es una etapa del pipeline de voz a texto, LLM y texto a voz, y su retardo se suma a la latencia de la llamada.
Las buenas prácticas para LLM personalizado de Retell explican qué parte del tiempo del modelo cuenta: Retell «empieza a hablar en cuanto tiene tu primera frase completa», así que la cifra que hay que vigilar es «el tiempo hasta el primer token más el tiempo para terminar esa primera frase». La decodificación especulativa actúa sobre la segunda parte: una vez que empieza la generación, los tokens llegan en grupos. No acorta la lectura del prompt que precede al primer token. Para eso, la guía de resolución de problemas de latencia de Retell empieza por la elección del modelo y la longitud del prompt.
El otro motivo es la precisión. Pasar a un modelo más pequeño también reduce el retardo, pero la misma guía advierte de que cambiar de modelo «cambia el comportamiento de tu agente, no solo su velocidad». La decodificación especulativa exacta conserva el resultado del modelo grande.
La aplica quien sirve el modelo, de modo que quien crea un agente la percibe como velocidad del modelo. En Retell, Tell-1 se sirve de esta forma. Para comparar modelos en velocidad y calidad de llamada, consulta los mejores LLM para agentes de voz con IA.
Preguntas frecuentes sobre la decodificación especulativa
¿La decodificación especulativa es sin pérdidas?
En su forma exacta, sí. Los artículos originales demuestran que la distribución de salida coincide con la del modelo grande, y vLLM la describe como «teóricamente sin pérdidas hasta los límites de precisión numérica del hardware». Las variantes que relajan la verificación no son sin pérdidas.
¿Quién creó la decodificación especulativa?
Yaniv Leviathan, Matan Kalman y Yossi Matias, de Google Research, publicaron el artículo en noviembre de 2022 y lo presentaron en ICML 2023. Un equipo de DeepMind publicó su propia versión, llamada muestreo especulativo, en febrero de 2023.
¿Qué es un modelo borrador?
Un modelo borrador es el modelo pequeño y rápido que escribe las conjeturas. La documentación de Hugging Face indica que el método funciona mejor cuando este «es bastante más pequeño que el modelo principal y usa el mismo tokenizador».
¿La decodificación especulativa reduce el coste?
Puede ir en ambos sentidos. El artículo de Google señala que el número total de operaciones aritméticas «podría ser mayor que el del algoritmo de decodificación estándar», ya que las conjeturas rechazadas son trabajo desperdiciado. La retrospectiva de Google de 2024 añade que obtener resultados más rápidos con el mismo hardware implica que «se necesitan menos máquinas para servir el mismo volumen de tráfico».
¿La predicción multitoken es lo mismo que la decodificación especulativa?
No. La predicción multitoken (MTP) es una forma de generar las conjeturas. La documentación de vLLM incluye la MTP junto a los modelos borrador como método de especulación.
Prueba la velocidad del modelo en tus propias llamadas
Retell AI es una plataforma de agentes de voz con IA para centros de contacto. Habla con el equipo de Retell sobre un piloto con llamadas reales.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


