El tiempo hasta el primer token (TTFT) es el tiempo que transcurre entre el envío de una solicitud a un modelo de lenguaje de gran tamaño (LLM) y la recepción del primer token de su respuesta. Mide lo rápido que un modelo empieza a responder, no cuánto tarda la respuesta.
La guía de benchmarking de NVIDIA lo define como «el tiempo desde el envío de la consulta hasta el primer token recibido». En una llamada telefónica, el TTFT es una parte de la latencia que percibe quien llama. Hay otras dos medidas por encima: el tiempo hasta la primera frase y la latencia de voz de extremo a extremo.
¿Qué incluye el TTFT?
El TTFT abarca todo lo que ocurre antes de que el modelo transmita su primer token. IBM enumera cuatro componentes: el retraso en cola, el tiempo de prefill (procesamiento del prompt), la generación del primer token y la sobrecarga de red y de API.
IBM afirma que el prefill es «a menudo el factor que más contribuye al TTFT, sobre todo con prompts más largos». El modelo lee el prompt completo antes de escribir nada, así que un prompt más largo implica una espera más larga. La carga también influye. La documentación de Anyscale señala que un servidor con un uso intenso puede poner en cola las solicitudes entrantes, y esa espera se suma al TTFT.
¿Cómo se mide el TTFT?
- TTFT = momento en que se recibe el primer token menos momento en que se envía la solicitud
Hay tres decisiones que cambian el resultado. Indícalas junto a cualquier cifra de TTFT:
- Dónde está el reloj. Si se mide en el cliente, el TTFT incluye el tiempo de red. Si se mide dentro del servidor del modelo, no.
- Qué percentil. La mediana (P50) muestra la solicitud típica. P90 y P99 muestran las lentas.
- Cuánta carga. Una sola solicitud en un servidor inactivo es el mejor caso. En producción, según NVIDIA, el prefill de una solicitud puede solaparse con la generación de otra.
¿En qué se diferencian el TTFT, el tiempo hasta la primera frase y la latencia de extremo a extremo en una llamada?
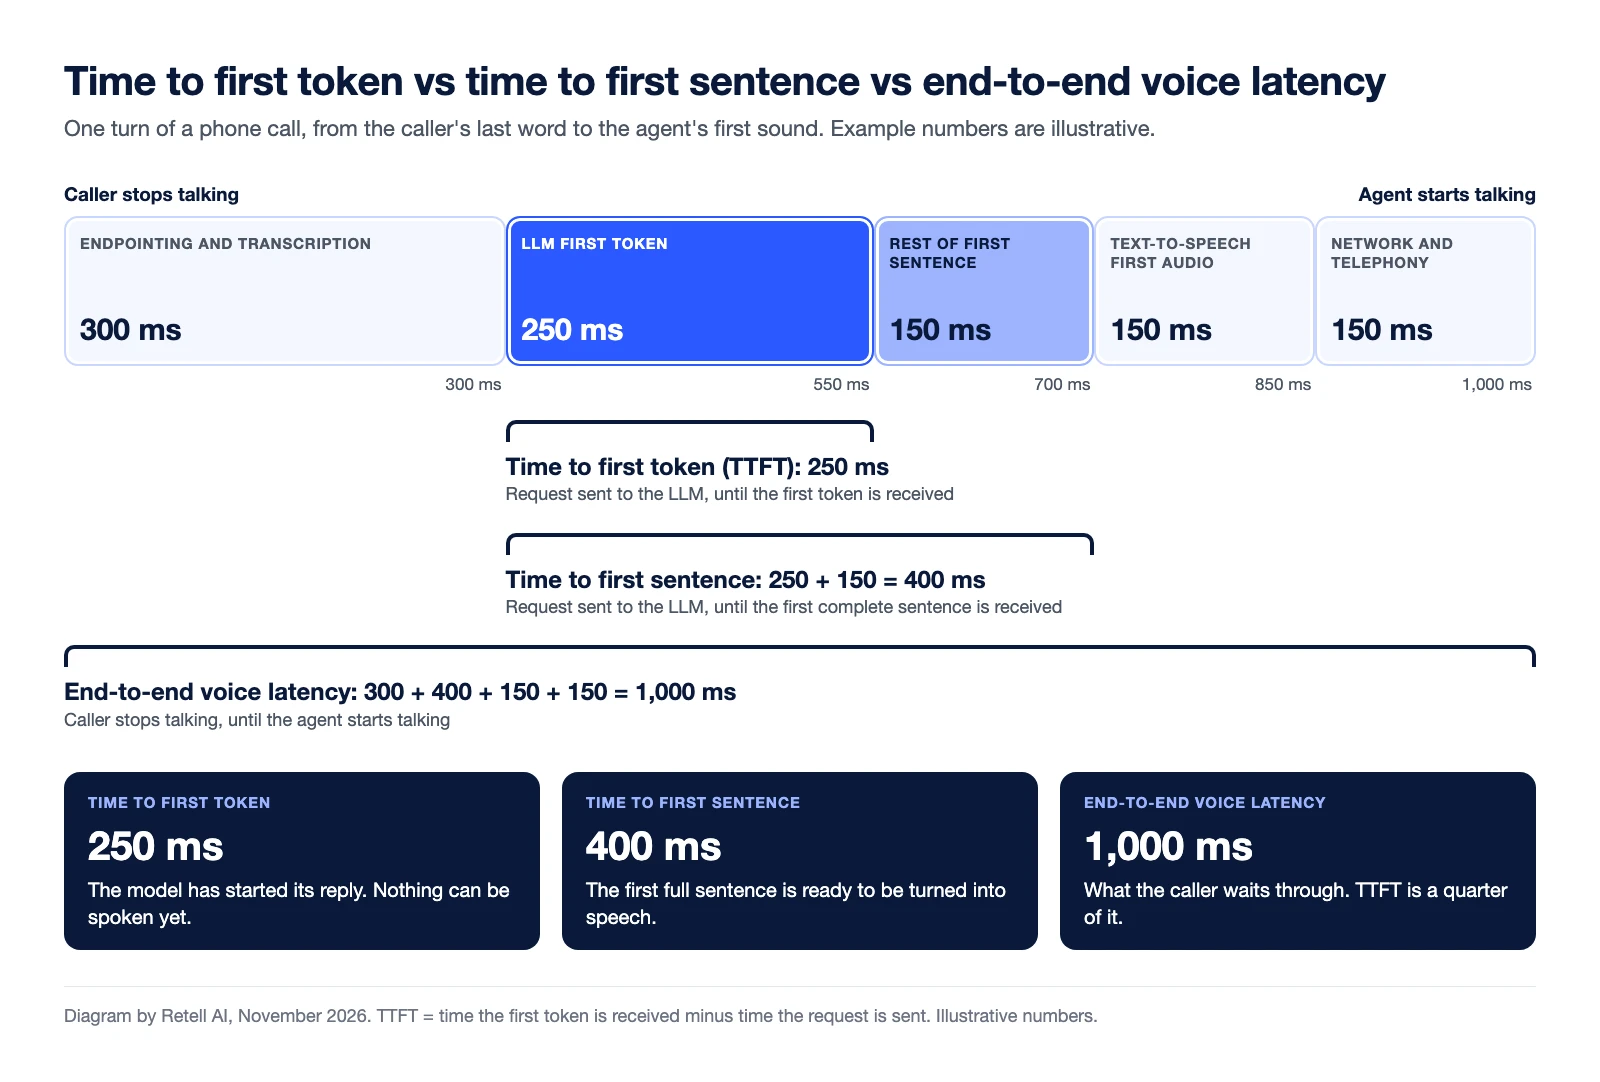
El TTFT se detiene en el primer token. El tiempo hasta la primera frase se detiene cuando ha llegado una frase completa. La latencia de voz de extremo a extremo cubre todo el silencio que percibe quien llama.
Quien llama nunca oye un token. Las buenas prácticas para LLM personalizado de Retell dicen: «Retell empieza a hablar en cuanto tiene tu primera frase completa». La cifra que importa ahí es «el tiempo hasta el primer token más el tiempo para terminar esa primera frase».
La documentación sobre latencia de Retell mide la latencia de extremo a extremo «desde que el usuario deja de hablar hasta que el agente empieza a hablar».
| Medida | Inicio del reloj | Fin del reloj | Qué excluye |
|---|---|---|---|
| Tiempo hasta el primer token (TTFT) | Solicitud enviada al LLM | Primer token recibido | El resto de la primera frase, el reconocimiento de voz y la síntesis de voz |
| Tiempo hasta la primera frase | Solicitud enviada al LLM | Primera frase completa recibida | Reconocimiento de voz, síntesis de voz, telefonía |
| Latencia de voz de extremo a extremo | Quien llama deja de hablar | El agente empieza a hablar | Nada del pipeline. Comprueba si la cifra incluye el tramo de red hasta quien llama |
Una trampa de nomenclatura: en el benchmarking de LLM, la latencia de extremo a extremo llega hasta el último token. NVIDIA la define como «cuánto tiempo transcurre desde que se envía una consulta hasta que se recibe la respuesta completa».
Ejemplo práctico (cifras ilustrativas). Un turno de una llamada:
- Detección de fin de turno y transcripción: 300 ms
- Primer token del LLM: 250 ms
- Resto de la primera frase: 150 ms (15 tokens más a 10 ms cada uno)
- Primer audio de texto a voz: 150 ms
- Red y telefonía: 150 ms
El TTFT es de 250 ms. El tiempo hasta la primera frase es 250 + 150 = 400 ms. La latencia de voz de extremo a extremo es 300 + 400 + 150 + 150 = 1.000 ms, por lo que el TTFT supone una cuarta parte de la espera de quien llama. Nuestra guía de benchmarks de latencia de IA de voz usa el mismo presupuesto.
¿Por qué el TTFT puede llevar a error al comparar modelos?
Una cifra de TTFT solo es comparable con otra cifra de TTFT obtenida de la misma forma. Si comparas el TTFT de un modelo con el tiempo hasta la primera frase de otro, el primero siempre parecerá más rápido. Lo mismo ocurre al comparar el tiempo solo del modelo con el tiempo medido en una llamada real, o una mediana con un P99.
Un modelo también puede enviar su primer token rápidamente y luego transmitir despacio, lo que sigue dejando a quien llama en silencio.
¿Cómo se reduce el TTFT en un agente de voz?
La guía de resolución de problemas de latencia de Retell señala la elección del modelo y la longitud del prompt como las dos causas más habituales de una latencia elevada.
- Elige un modelo más rápido. Tell-1 es una opción diseñada para llamadas. Según la guía, los modelos más grandes y orientados al razonamiento «tardan más en generar el primer token».
- Acorta el prompt. «Cada token de tu prompt se suma al tiempo hasta el primer token», en cada turno. Los prompts de más de unos 8k tokens se vuelven notablemente más lentos.
- Transmite la respuesta en streaming. Con un LLM personalizado, enviar la respuesta completa en un solo evento «coloca toda la generación en el silencio de quien llama».
La Get Call API de Retell devuelve la latencia de extremo a extremo, del LLM y de texto a voz de cada llamada en P50, P90, P95 y P99. La cifra del LLM llega «hasta el primer fragmento pronunciable recibido», por lo que mide texto pronunciable, no el primer token sin procesar.
Algunos modelos se diseñan en torno a esta medida. Tell-1, el LLM propio de Retell, empieza su respuesta y sigue razonando mientras se reproduce la primera frase. Tiene la latencia mediana más baja del Retell vCX Benchmark, con 76 ms, una mediana móvil de 24 horas del tiempo hasta la primera frase (consultada el 13 de noviembre de 2026). La publicación técnica sobre el LLM de Retell explica cómo funciona, y el tiempo del modelo es solo una parte de la latencia de voz de extremo a extremo.
Preguntas frecuentes sobre el tiempo hasta el primer token
¿Qué es un buen tiempo hasta el primer token?
No existe un estándar único. Depende del modelo, de la longitud del prompt y de la carga del servidor. En un agente de voz, valóralo dentro de la cifra de extremo a extremo. La documentación de Retell recomienda mantener la latencia estimada de un agente por debajo de 1,5 segundos.
¿El TTFT es lo mismo que la latencia?
No. El TTFT es el retraso del LLM hasta su primer token. La latencia en una llamada es todo el intervalo entre que quien llama termina y el agente empieza a hablar.
¿El TTFT incluye el tiempo de red?
Depende de dónde se mida. NVIDIA indica que el TTFT «generalmente incluye el tiempo de espera en cola de la solicitud, el tiempo de prefill y la latencia de red». Una cifra solo del modelo obtenida dentro del servidor excluye la red.
¿Cuál es la diferencia entre el TTFT y el tiempo hasta la primera frase?
El TTFT se detiene en el primer token. El tiempo hasta la primera frase se detiene cuando ha llegado la primera frase completa, que es cuando un agente de voz puede empezar a hablar.
Mide la latencia en tus propias llamadas
Retell AI es una plataforma de agentes de voz con IA para centros de contacto. Call History muestra la latencia de cada llamada, desglosada por componente en la Get Call API. Habla con el equipo de Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


