Interleaved reasoning is een manier om een reasoning-model te laten werken waarbij het model afwisselt tussen intern redeneren en zichtbare acties, zoals tool calls of delen van zijn antwoord, in plaats van al het redeneren af te ronden voordat het reageert.
Het wordt ook interleaved thinking genoemd. Documentatie van aanbieders gebruikt de term vooral voor redeneren tussen tool calls. Onderzoekspapers gebruiken hem voor een model dat denken afwisselt met delen van zijn antwoord. Beide beschrijven dezelfde verandering: redeneren is niet langer één blok aan het begin van de beurt.
Wat is een reasoning-model?
Een reasoning-model is een groot taalmodel dat tussenliggende redeneringen genereert vóór zijn antwoord. De reasoning-gids van OpenAI vat het in één zin samen: "Reasoning-modellen gebruiken interne reasoning tokens voordat ze een antwoord produceren." De Gemini-documentatie van Google zegt dat een thinking-model "intern redeneert voordat het antwoordt", en de documentatie van DeepSeek zegt dat de thinking-modus chain-of-thought-redeneringen produceert "om de nauwkeurigheid van het uiteindelijke antwoord te verbeteren".
Wat zijn reasoning tokens?
Reasoning tokens, ook wel thinking tokens genoemd, zijn de tokens die een model genereert terwijl het een probleem doorwerkt. Ze maken geen deel uit van het antwoord. Drie eigenschappen zijn belangrijk:
- Ze worden gefactureerd. OpenAI zegt dat reasoning tokens "worden gefactureerd als output tokens". De thinking-documentatie van Anthropic zegt hetzelfde over Claude, "zelfs wanneer de denktekst niet aan je wordt teruggegeven". Google prijst een antwoord als "de som van output tokens en thinking tokens".
- Ze zijn vaak verborgen. De reasoning tokens van OpenAI "zijn niet zichtbaar via de API". Anthropic zegt dat wat je ziet "nooit de ruwe chain of thought is". Beide kunnen een samenvatting teruggeven als je daarom vraagt.
- Ze kosten tijd en ruimte. OpenAI zegt dat een model op één request "van enkele honderden tot tienduizenden reasoning tokens" kan genereren, en die nemen ruimte in het contextvenster in.
Developers bepalen de hoeveelheid met een instelling: reasoning effort bij OpenAI, effort bij Anthropic, thinking level bij Google.
Hoe verschilt interleaved reasoning van think-first reasoning?
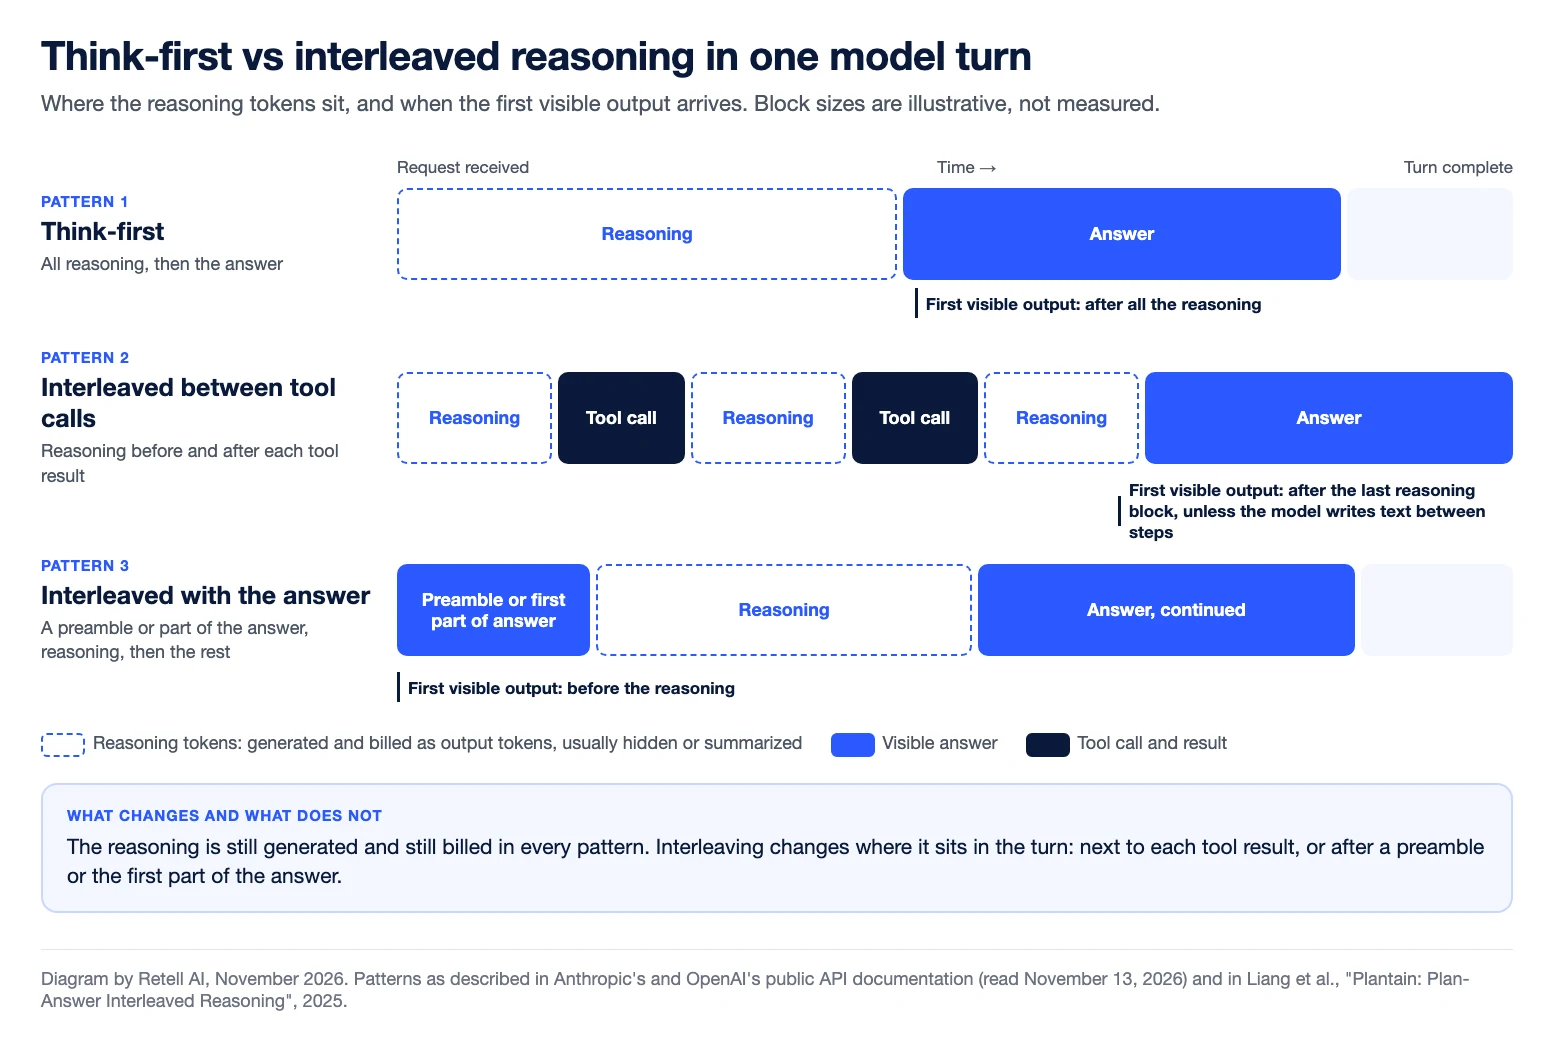
Bij think-first reasoning vindt al het redeneren plaats vóór het eerste zichtbare token. Anthropic noemt dit up-front thinking: thinking-blokken "komen vóór de tekstblokken". Interleaved reasoning splitst het redeneren op in kleinere blokken en plaatst die waar ze nodig zijn.
| Patroon | Volgorde van werk in één beurt | Wat de gebruiker als eerste ziet | Publiek beschreven door |
|---|---|---|---|
| Geen redeneren | Antwoord | Het begin van het antwoord | Elk model met redeneren uitgeschakeld |
| Think-first | Al het redeneren, daarna het antwoord | Niets totdat het redeneren klaar is | Anthropic (up-front thinking), DeepSeek |
| Interleaved tussen tool calls | Redeneren, een tool aanroepen, het resultaat lezen, opnieuw redeneren, dan antwoorden | Niets totdat het laatste redeneerblok klaar is, tenzij het model tussen de stappen tekst schrijft | Anthropic, OpenAI, vLLM, DeepSeek (zonder de term) |
| Interleaved met het antwoord | Een inleiding of deel van het antwoord, redeneren, meer van het antwoord | Een inleiding of een vroeg deel van het antwoord | OpenAI, onderzoekspapers |
| Interleaved met spraak | Eerste zin van het antwoord, stil redeneren terwijl die wordt afgespeeld, daarna de rest van het antwoord | De eerste zin van het antwoord | Tell-1, de eigen LLM van Retell |
Wat documenteren aanbieders vandaag?
Geraadpleegd op 13 november 2026:
- Anthropic. "Met interleaved thinking kan Claude nadenken tussen tool calls en over elk toolresultaat redeneren voordat het ernaar handelt." Het werkt automatisch op modellen die adaptive thinking ondersteunen. Modellen met handmatige extended thinking hebben een bètaheader nodig.
- OpenAI. Modellen zoals gpt-5.5 "ondersteunen interleaved thinking, waarbij het model zichtbare output tokens kan genereren vóór en tussen het denken door, en kan nadenken tussen tool calls".
- Google. De Gemini-pagina over thinking gebruikt de term niet. Er staat dat denkstappen "chronologisch verschijnen naast function calls, gebruikersinput of modeloutput", en dat thought signatures "vereist zijn om de continuïteit van het redeneren te behouden over interacties met meerdere beurten".
- vLLM. De open-source inference-server ondersteunt interleaved thinking voor twee modelseries en waarschuwt dat het "het tokengebruik en de responslatency verhoogt".
In onderzoek trainden Xie et al. (2025) modellen "om denken en antwoorden te verweven" en rapporteren ze een gemiddeld ruim 80% kortere time to first token. Liang et al. (2025) definiëren interleaved reasoning als een model dat "afwisselt tussen denken en het tonen van tussentijdse antwoorden" en rapporteren dat hun plan-first-variant, Plantain, de tijd tot het eerste antwoord met ruim 60% verkortte. Beide onderzochten teksttaken.
Waarom kost think-first reasoning stilte tijdens een telefoongesprek?
Tijdens een telefoongesprek kan spraaksynthese pas starten wanneer het model de eerste woorden van zijn antwoord produceert. Elk reasoning token dat vóór die woorden wordt gegenereerd, is tijd waarin de beller niets hoort. In een chatvenster is diezelfde wachttijd een voortgangsindicator. Tijdens een gesprek is het stilte aan de lijn en extra latency.
De documentatie van Retell over het oplossen van latencyproblemen zegt dat grotere, op redeneren gerichte modellen "trager zijn tot het eerste token" en "latency inruilen voor capaciteit". OpenAI noemt stem als veelvoorkomende use case om te draaien met reasoning effort op none, en raadt latencygevoelige toepassingen aan om "het model te vragen een korte inleiding te genereren voordat het verdergaat met diepgaander redeneren". De gids over de beste LLM voor AI-stemagenten behandelt de modelkeuze.
Wat is interleaved reasoning in een stemagent?
In een stemagent betekent interleaved reasoning dat het model direct de eerste zin van zijn antwoord schrijft, stil redeneert terwijl die zin wordt uitgesproken, en het antwoord daarna voortzet op basis van dat redeneren. De beller hoort één doorlopend antwoord, en het redeneren wordt nooit uitgesproken.
Tell-1 werkt op deze manier. De technische post van Retell, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, beschrijft het formaat als "een gesproken opening, dan redeneren, dan de rest van het antwoord". De post meldt gemiddeld 200 reasoning tokens midden in het antwoord, en dat 99,98% van de beurten minder dan 400 ms pauzeert na de eerste zin.
Vergeleken met think-first reasoning hoeft de beller niet in stilte te wachten tot het redeneren klaar is. De post benoemt ook de afweging: "eerder spreken betekent je vastleggen op de opening voordat er is geredeneerd". Tell-1 staat op de algemene eerste plaats in de Retell vCX Benchmark (per november 2026).
Veelgestelde vragen over interleaved reasoning
Is interleaved reasoning hetzelfde als interleaved thinking?
Ja, in de meeste gevallen. Anthropic en OpenAI spreken van interleaved thinking; onderzoekspapers spreken meestal van interleaved reasoning.
Worden reasoning tokens gefactureerd?
Ja. OpenAI, Anthropic en Google rekenen ze allemaal mee als gefactureerde output. OpenAI en Anthropic factureren ze zelfs wanneer de redeneertekst niet wordt teruggegeven.
Kun je de reasoning tokens van een model lezen?
Meestal niet. OpenAI en Anthropic kunnen een samenvatting teruggeven als je daarom vraagt. Geen van beide geeft het ruwe redeneren terug.
Laat interleaved reasoning een model sneller reageren?
Niet op zichzelf. Tussen tool calls voegt het tokens toe, en de documentatie van vLLM waarschuwt dat het de responslatency verhoogt. De eerste zichtbare output komt alleen eerder wanneer zichtbare output vóór het redeneren komt, of tussen kortere redeneerblokken.
Wat is interleaved reasoning in voice-AI?
Het is een model dat direct begint te spreken, stil redeneert terwijl zijn eerste zin wordt afgespeeld, en het antwoord daarna afmaakt op basis van dat redeneren. Tell-1, de eigen LLM van Retell, is zo gebouwd.
Draai reasoning-modellen op live gesprekken
Retell AI is een platform voor AI-stemagenten voor contactcenters. Je kiest zelf het model achter elke agent. Tell-1 is er een van. Neem contact op met het Retell-team.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


