Prompt caching is een techniek waarmee een large language model werk kan overslaan dat het al heeft gedaan: als een nieuwe request met dezelfde tokens begint als een eerdere, hergebruikt het model de opgeslagen berekening voor dat gedeelde begin en verwerkt het alleen wat nieuw is. Het resultaat is een sneller eerste token en, bij de meeste API's, een lagere prijs voor de hergebruikte tokens.
Het hergebruikte deel heet de prefix. De handleiding van OpenAI definieert die als "de ongewijzigde tokens aan het begin van een prompt". Daar staan meestal de instructies, tooldefinities en eerdere beurten van het gesprek.
Hoe werkt prompt caching?
De documentatie van Anthropic beschrijft de volgorde: het systeem controleert of een promptprefix al in de cache staat van een recente query, gebruikt de gecachte versie als dat zo is, en verwerkt anders de volledige prompt en slaat de prefix op in de cache.
Uit dat ontwerp volgen drie regels:
- De match moet exact zijn. Anthropic stelt dat cache hits "100 procent identieke promptsegmenten" vereisen. Eén gewijzigd teken vroeg in de prompt betekent dat alles daarna opnieuw wordt verwerkt.
- Volgorde doet ertoe. Stabiele content komt eerst en veranderende content als laatste.
- Entries verlopen. De standaardlevensduur van de cache bij Anthropic is 5 minuten, en wordt vernieuwd telkens wanneer de gecachte content wordt gebruikt. Bij OpenAI hangt de levensduur af van het model.
Hoe verhouden prompt caching, prefix caching en de KV-cache zich tot elkaar?
Het zijn drie lagen van hetzelfde idee. De KV-cache is de data, prefix caching is het hergebruik van die data over requests heen, en prompt caching is de naam die API-aanbieders aan de functie geven.
| Term | Wat het is | Bereik | Waar je de term tegenkomt |
|---|---|---|---|
| KV-cache | De key- en value-states die een model berekent voor elk token dat het heeft gelezen, bewaard zodat ze niet voor elk nieuw token opnieuw worden berekend | Binnen één request | Interne werking van modellen, inference-engines |
| Prefix caching | De KV-cache bewaren nadat een request is afgerond en die hergebruiken voor een latere request die met dezelfde tokens begint | Over requests heen op dezelfde server | Inference-engines zoals vLLM |
| Prompt caching | Prefix caching aangeboden als API-functie, met regels voor levensduur, minimale lengte en prijs | Over API-calls heen | Documentatie en prijspagina's van modelaanbieders |
Een uitleg van Hugging Face beschrijft de KV-cache eenvoudig: "In plaats van alles opnieuw te berekenen, hergebruikt het model wat het al heeft berekend". De documentatie van vLLM zegt dat de automatische prefix caching "de KV-cache van bestaande queries opslaat, zodat een nieuwe query de KV-cache direct kan hergebruiken als die dezelfde prefix deelt". OpenAI bevestigt het verband vanaf de API-kant: "De promptcache slaat key-value (KV)-tensors op, niet de tokens zelf."
Waarom is prompt caching belangrijk bij een telefoongesprek met meerdere beurten?
Een stemagent roept het model één keer per beurt aan, en elke request bevat de instructies, de tooldefinities en het gesprek tot nu toe. In een gesprek met meerdere beurten is vrijwel alles daarvan identiek aan de request van de vorige beurt. Alleen de laatste uitwisseling is nieuw. Zonder caching leest het model bij elke beurt opnieuw dezelfde instructies.
Uitgewerkt voorbeeld (illustratieve cijfers). Een agent heeft 2.500 tokens aan instructies en tools, elke beurt voegt 100 tokens gesprek toe, en elke beurt na de eerste vindt zijn prefix in de cache:
| Beurt | Prompttokens | Hergebruikt uit cache | Nieuwe tokens om te lezen |
|---|---|---|---|
| 1 | 2.600 | 0 | 2.600 |
| 2 | 2.700 | 2.600 | 100 |
| 5 | 3.000 | 2.900 | 100 |
| 10 | 3.500 | 3.400 | 100 |
| Alle 10 beurten | 30.500 | 27.000 | 3.500 |
Over het hele gesprek komen 27.000 van de 30.500 prompttokens (ongeveer 89%) uit de cache. Vanaf de tweede beurt leest het model 100 nieuwe tokens in plaats van meer dan 2.600.
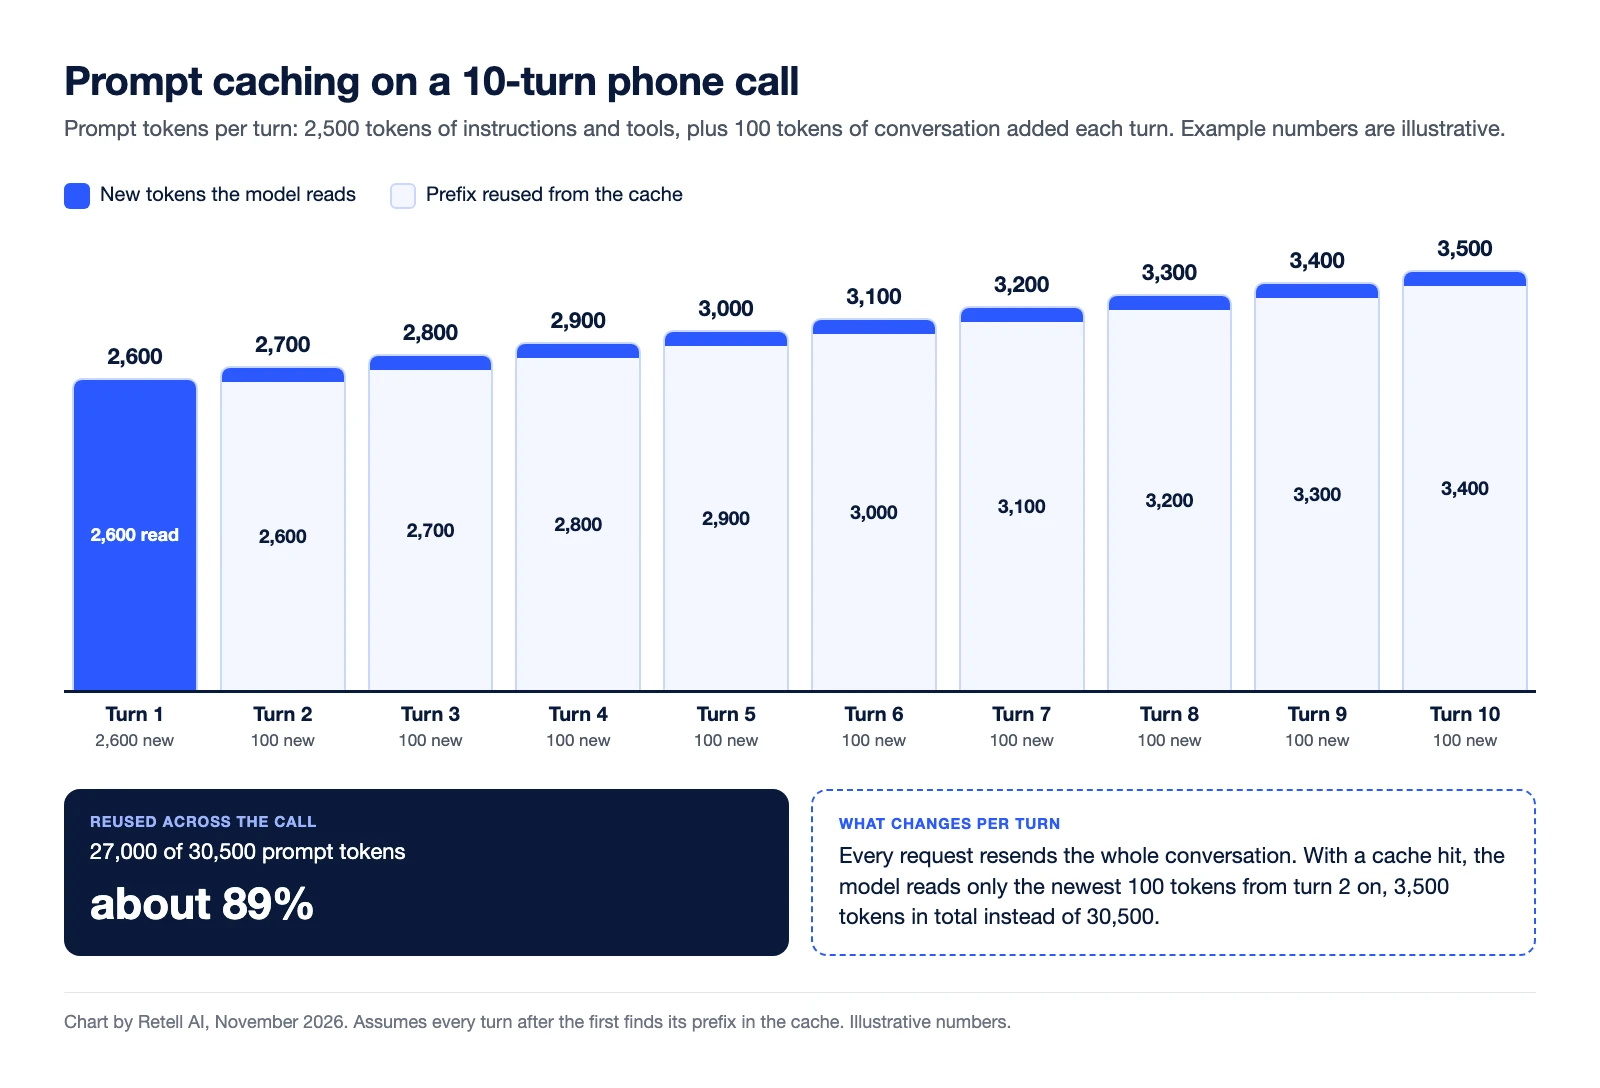
Dat is om twee redenen belangrijk. De tijd tot het eerste token is onderdeel van de latency die een beller als stilte hoort, en het lezen van een lange prompt kost tijd. Kosten zijn de tweede reden: Anthropic rekent voor cache reads 0,1 keer de basisprijs per inputtoken, en voor cache writes 1,25 keer bij de levensduur van 5 minuten.
Wat verhindert een cache hit?
- Een gewijzigde prefix. Een tijdstempel, de naam van een beller of een anders geordende toollijst bovenaan de prompt verandert elk token daarna.
- Een pauze die langer is dan de levensduur van de cache.
- Een request die op een andere machine terechtkomt. De handleiding van OpenAI merkt op dat "gecachte states op individuele machines staan" en dat een request een prefix alleen kan hergebruiken "als die een machine bereikt met een overeenkomende entry die nog niet is verlopen".
Routing kan dat laatste gat dichten. Tell-1, het eigen LLM van Retell, houdt elk gesprek op de GPU's die het al in de cache hebben, met behulp van session affinity. Volgens de technische blogpost over het LLM van Retell verdubbelt dat bijna het aandeel prompttokens dat uit de cache wordt geleverd, van 36% naar 69%, zodat elke beurt minder hoeft in te lezen en antwoorden eerder beginnen.
Caching verandert het antwoord niet. De ontwerpnotities van vLLM stellen dat prefix caching "de output van het model niet verandert".
Waar AI-stemagents in beeld komen
De handleiding van Retell voor het oplossen van latencyproblemen benoemt de kosten van promptlengte direct: "Elk token in je prompt telt op bij de tijd tot het eerste token, en die kosten betaal je bij elke beurt van het gesprek."
Als je je eigen model koppelt via de LLM WebSocket van Retell, komt elke responsrequest binnen met het "volledige live transcript dat tot nu toe in het gesprek is verzameld". Jouw server bouwt de prompt, dus het cachegedrag hangt af van hoe je die opbouwt en van je modelaanbieder: zet instructies en tools vooraan en laat ze ongewijzigd, en voeg het transcript daarna toe. Voor het volledige pad dat een beurt aflegt, zie hoe realtime voice-AI werkt.
Veelgestelde vragen over prompt caching
Wat is het verschil tussen prompt caching en de KV-cache?
De KV-cache is de opgeslagen attention-state die een model opbouwt tijdens het lezen van tokens. Prompt caching bewaart die state nadat een request is afgerond, zodat een latere request met dezelfde begintokens die kan hergebruiken.
Is prefix caching hetzelfde als prompt caching?
Het is hetzelfde mechanisme. Prefix caching is de term die inference-engines gebruiken. Prompt caching is de productnaam die modelaanbieders ervoor gebruiken in hun API's.
Verandert prompt caching het antwoord van het model?
Nee. Het slaat alleen het opnieuw berekenen van de gedeelde prefix over.
Hoe lang blijft een promptcache bewaard?
Dat hangt af van de aanbieder. Bij Anthropic is de standaard 5 minuten, vernieuwd bij elk gebruik, met een optie van 1 uur tegen een hogere schrijfprijs. Bij OpenAI hangt de levensduur af van het model.
Waarom is prompt caching belangrijk voor stemagents?
Elke beurt van een gesprek verstuurt de instructies en het gesprek tot nu toe opnieuw. Bij een cache hit leest het model alleen de nieuwste uitwisseling.
Hoor het verschil in je eigen gesprekken
Retell AI is een platform voor AI-stemagents voor contactcenters. Tell-1 is het eigen LLM van Retell, gebouwd voor telefoongesprekken. De documentatie laat zien hoe je de latency van elk gesprek per component controleert, zodat je ziet hoeveel van de wachttijd door het model komt. Neem contact op met het Retell-team.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


