Time to first token (TTFT) is de tijd tussen het versturen van een verzoek naar een large language model (LLM) en het ontvangen van het eerste token van het antwoord. Het meet hoe snel een model begint te antwoorden, niet hoe lang het antwoord duurt.
De benchmarkinggids van NVIDIA definieert het als "de tijd van het indienen van de query tot het eerste ontvangen token". Tijdens een telefoongesprek is TTFT één onderdeel van de latency die een beller hoort. Twee andere metingen bouwen daarop voort: de tijd tot de eerste zin en de end-to-end voice-latency.
Wat omvat TTFT?
TTFT omvat alles voordat het model zijn eerste token streamt. IBM noemt vier onderdelen: wachtrijvertraging, prefill-tijd (het verwerken van de prompt), het genereren van het eerste token, en netwerk- en API-overhead.
IBM noemt prefill "vaak de grootste factor in TTFT, vooral bij langere prompts". Het model leest de volledige prompt voordat het iets schrijft, dus een langere prompt betekent langer wachten. Ook de belasting speelt mee. De documentatie van Anyscale merkt op dat een zwaar belaste server binnenkomende verzoeken in een wachtrij kan zetten, en die wachttijd telt op bij de TTFT.
Hoe meet je TTFT?
- TTFT = tijdstip waarop het eerste token binnenkomt min tijdstip waarop het verzoek wordt verstuurd
Drie keuzes beïnvloeden het resultaat. Vermeld ze bij elk TTFT-cijfer:
- Waar de klok staat. Gemeten bij de client omvat TTFT netwerktijd. Gemeten binnen de modelserver niet.
- Welk percentiel. De mediaan (P50) toont het typische verzoek. P90 en P99 tonen de trage verzoeken.
- Hoeveel belasting. Eén verzoek op een inactieve server is het beste scenario. In productie, zo merkt NVIDIA op, kan de prefill van het ene verzoek overlappen met de generatie van een ander.
Hoe verschillen TTFT, tijd tot de eerste zin en end-to-end latency tijdens een telefoongesprek?
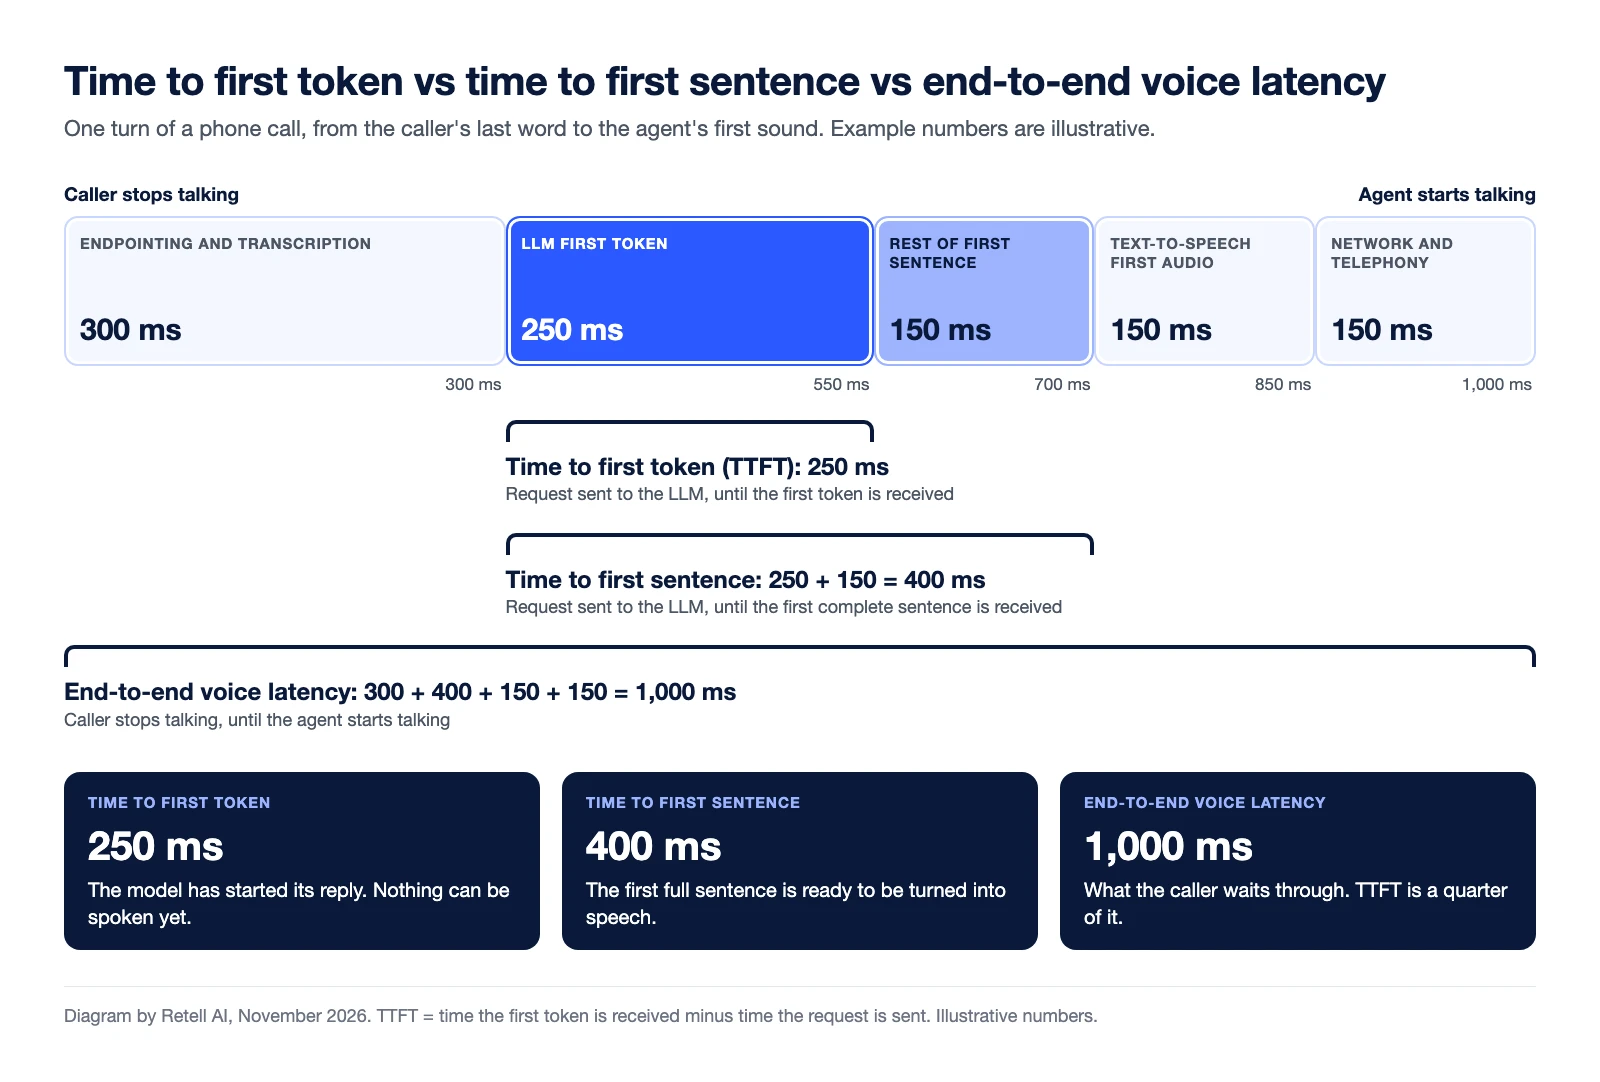
TTFT stopt bij het eerste token. De tijd tot de eerste zin stopt wanneer een volledige zin is binnengekomen. End-to-end voice-latency beslaat de hele stilte die de beller hoort.
Een beller hoort nooit een token. De best practices voor een custom LLM van Retell zeggen: "Retell begint te spreken zodra het je eerste volledige zin heeft." Het cijfer dat daar telt is "time to first token plus de tijd om die eerste zin af te maken".
De latencydocumentatie van Retell meet end-to-end latency "vanaf het moment dat de gebruiker stopt met praten tot het moment dat de agent begint te praten".
| Meting | Klok start | Klok stopt | Laat buiten beschouwing |
|---|---|---|---|
| Time to first token (TTFT) | Verzoek verstuurd naar de LLM | Eerste token ontvangen | De rest van de eerste zin, spraakherkenning, spraaksynthese |
| Tijd tot de eerste zin | Verzoek verstuurd naar de LLM | Eerste volledige zin ontvangen | Spraakherkenning, spraaksynthese, telefonie |
| End-to-end voice-latency | Beller stopt met praten | Agent begint te praten | Niets in de pipeline. Controleer of het cijfer het netwerktraject naar de beller meetelt |
Eén valkuil in de naamgeving: bij LLM-benchmarking loopt end-to-end latency tot het laatste token. NVIDIA definieert het als "hoe lang het duurt van het indienen van een query tot het ontvangen van het volledige antwoord".
Rekenvoorbeeld (illustratieve cijfers). Eén beurt in een gesprek:
- Endpointing en transcriptie: 300 ms
- Eerste token van de LLM: 250 ms
- Rest van de eerste zin: 150 ms (15 extra tokens van elk 10 ms)
- Eerste audio van text-to-speech: 150 ms
- Netwerk en telefonie: 150 ms
TTFT is 250 ms. De tijd tot de eerste zin is 250 + 150 = 400 ms. End-to-end voice-latency is 300 + 400 + 150 + 150 = 1.000 ms, dus TTFT is een kwart van de wachttijd van de beller. Onze gids over latencybenchmarks voor voice-AI gebruikt hetzelfde budget.
Waarom kan TTFT misleidend zijn als je modellen vergelijkt?
Een TTFT-cijfer is alleen vergelijkbaar met een ander TTFT-cijfer dat op dezelfde manier is gemeten. Zet je de TTFT van het ene model af tegen de tijd tot de eerste zin van een ander, dan lijkt het eerste altijd sneller. Hetzelfde geldt voor tijd van alleen het model tegenover tijd gemeten in een live gesprek, en voor een mediaan tegenover een P99.
Een model kan ook snel zijn eerste token versturen en daarna traag streamen, waardoor de beller nog steeds in stilte zit.
Hoe verlaag je TTFT bij een stemagent?
De gids voor het oplossen van latencyproblemen van Retell noemt modelkeuze en promptlengte als de twee meest voorkomende oorzaken van hoge latency.
- Kies een sneller model. Tell-1 is een optie die speciaal voor gesprekken is gebouwd. Volgens de gids zijn grotere, op redeneren gerichte modellen "trager tot het eerste token".
- Kort de prompt in. "Elk token in je prompt telt op bij de time-to-first-token", bij elke beurt. Prompts van meer dan ongeveer 8k tokens worden merkbaar trager.
- Stream het antwoord. Met een custom LLM zet het versturen van het volledige antwoord in één event "de hele generatie in de stilte van de beller".
De Get Call API van Retell geeft per gesprek de end-to-end-, LLM- en text-to-speech-latency terug op P50, P90, P95 en P99. Het LLM-cijfer loopt "tot het eerste uitspreekbare stuk dat is ontvangen", dus het meet uitspreekbare tekst, niet het eerste ruwe token.
Sommige modellen zijn rond deze meting gebouwd. Tell-1, de eigen LLM van Retell, begint aan zijn antwoord en blijft redeneren terwijl de eerste zinsnede wordt afgespeeld. Het heeft de laagste mediane latency op de Retell vCX Benchmark met 76 ms, een voortschrijdende 24-uursmediaan van de tijd tot de eerste zin (afgelezen op 13 november 2026). De technische post over de Retell LLM legt uit hoe het werkt, en modeltijd is slechts één onderdeel van de end-to-end voice-latency.
Veelgestelde vragen over time to first token
Wat is een goede time to first token?
Er is geen vaste standaard. Het hangt af van het model, de promptlengte en de serverbelasting. Beoordeel het bij een stemagent binnen het end-to-end-cijfer. De documentatie van Retell adviseert om de geschatte latency van een agent onder de 1,5 seconde te houden.
Is TTFT hetzelfde als latency?
Nee. TTFT is de vertraging van de LLM tot aan het eerste token. Latency in een gesprek is de volledige tijd tussen het moment dat de beller uitgesproken is en het moment dat de agent begint te spreken.
Omvat TTFT netwerktijd?
Dat hangt af van waar het wordt gemeten. NVIDIA stelt dat TTFT "doorgaans de wachtrijtijd van verzoeken, de prefill-tijd en de netwerklatency omvat". Een cijfer van alleen het model, gemeten binnen de server, laat het netwerk buiten beschouwing.
Wat is het verschil tussen TTFT en de tijd tot de eerste zin?
TTFT stopt bij het eerste token. De tijd tot de eerste zin stopt wanneer de eerste volledige zin is binnengekomen; op dat moment kan een stemagent beginnen te spreken.
Meet de latency van je eigen gesprekken
Retell AI is een platform voor AI-stemagenten voor contactcenters. Call History toont de latency van elk gesprek, uitgesplitst per component in de Get Call API. Neem contact op met het Retell-team.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


