Speculative decoding is een techniek om een groot taalmodel sneller te maken. Een klein draftmodel raadt de volgende paar tokens. Het grote model controleert ze daarna allemaal in één pass en behoudt de tokens die het zelf ook zou hebben gegenereerd.
De methode komt uit twee onderzoekspapers. Google Research gaf haar de naam in Fast Inference from Transformers via Speculative Decoding (Leviathan, Kalman en Matias, voor het eerst gepubliceerd in november 2022). DeepMind beschreef een eigen, los daarvan ontwikkelde versie in Accelerating Large Language Model Decoding with Speculative Sampling (Chen en collega's, februari 2023).
Waarom is standaard decoding traag?
Standaard decoding is traag omdat een groot taalmodel één token tegelijk schrijft, en elk token een volledige run van het model vereist. De Google-paper vat het in één zin samen: "het decoderen van K tokens kost K seriële runs van het model".
Veel van die tokens zijn eenvoudig te voorspellen. Dezelfde paper merkt op dat "moeilijke taalmodelleringstaken vaak eenvoudigere subtaken bevatten die goed kunnen worden benaderd door efficiëntere modellen".
Hoe werken het draftmodel en het volledige model samen?
De twee modellen werken in rondes, en elke ronde bestaat uit drie stappen:
- Draft. Het kleine model schrijft een korte reeks gokken, het ene token na het andere. De Google-paper noemt het het benaderingsmodel (approximation model); DeepMind noemt het het draftmodel.
- Verifiëren. Het grote model, het doelmodel (target model) genoemd, beoordeelt elke gegokte positie parallel, in één pass.
- Accepteren of corrigeren. Gokken worden van links naar rechts geaccepteerd. Bij de eerste afgewezen gok levert het grote model zijn eigen token en worden de latere gokken weggegooid. Als elke gok wordt geaccepteerd, voegt het grote model nog één token toe.
Elke pass van het grote model levert minstens één token op en hoogstens het aantal gokken plus één. Er zijn dus nooit meer passes nodig dan bij standaard decoding.
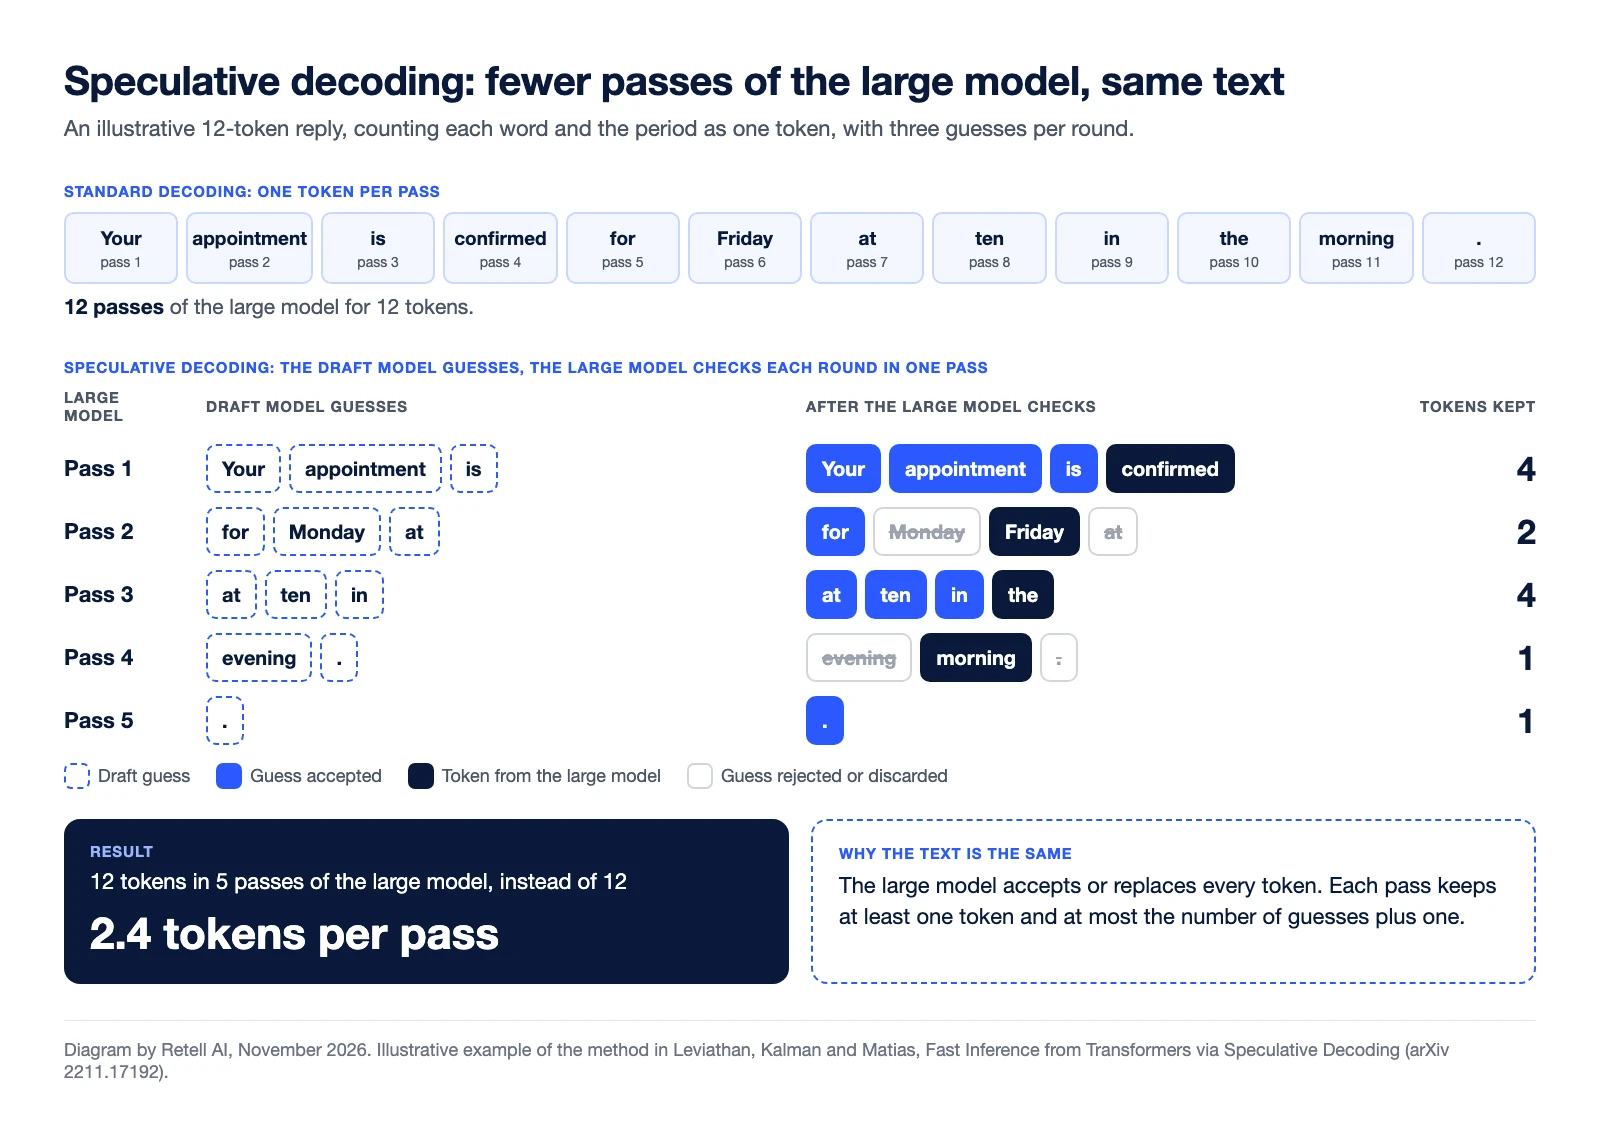
Uitgewerkt voorbeeld (ter illustratie). Een antwoord van 12 tokens, waarbij elk woord en de punt als één token tellen, met drie gokken per ronde:
| Pass van het grote model | Gokken van het draftmodel | Oordeel van het grote model | Behouden tokens |
|---|---|---|---|
| 1 | Je afspraak is | Alle drie geaccepteerd, voegt "bevestigd" toe | 4 |
| 2 | voor maandag om | "voor" geaccepteerd. "maandag" afgewezen en vervangen door "vrijdag". "om" weggegooid | 2 |
| 3 | om tien uur | Alle drie geaccepteerd, voegt "'s" toe | 4 |
| 4 | avonds . | "avonds" afgewezen en vervangen door "ochtends". De punt wordt weggegooid | 1 |
| 5 | . | Geaccepteerd, en het antwoord eindigt | 1 |
| Totaal | 12 tokens in 5 passes |
Standaard decoding heeft voor deze zin 12 passes van het grote model nodig. Hier draait het model 5 keer, gemiddeld 2,4 tokens per pass.
Waarom blijft de output ongewijzigd?
De output blijft ongewijzigd omdat het grote model bij elk token het laatste woord heeft. Bij greedy decoding kiest het model altijd zijn eerste keuze. Een gok blijft dan alleen staan als het het token is dat het grote model zelf zou hebben gekozen. De vLLM-documentatie noemt een test voor precies dit: greedy sampling met speculative decoding "komt overeen met greedy sampling zonder".
Bij willekeurige sampling wordt een gok geaccepteerd met een kans die afhangt van hoe beide modellen hem beoordelen. Een afgewezen gok wordt opnieuw getrokken uit een aangepaste verdeling. De Google-paper bewijst dat de outputverdeling hierdoor niet verandert. DeepMind formuleert het zo dat het schema "de verdeling van het doelmodel behoudt binnen de numerieke precisie van de hardware".
Sommige nieuwere varianten versoepelen de controle bewust om snelheid te winnen. vLLM merkt op dat een van zijn verificatiemethoden "de verdeling niet behoudt".
Wanneer helpt speculative decoding, en wanneer niet?
Speculative decoding helpt wanneer het draftmodel goedkoop is en meestal goed gokt, en de server rekenkracht over heeft.
| Voorwaarde | Effect op snelheid | Bron |
|---|---|---|
| Gokken worden meestal geaccepteerd | Meer tokens per pass. Verwacht aantal tokens per pass = (1 − α^(γ+1)) ÷ (1 − α), waarbij α de acceptatiegraad is en γ het aantal gokken per ronde | Google-paper |
| Draftmodel is veel kleiner dan het doelmodel | Lage draftkosten. Een draftmodel dat ongeveer twee ordes van grootte kleiner is, "presteerde meestal het best" | Google-paper |
| Er is rekenkracht over | Vereist. De methode gaat uit van "voldoende rekenkracht om de toegenomen gelijktijdigheid te ondersteunen" | Google-paper |
| Druk verkeer op de server | Kleinere winst. vLLM beoordeelt een draftmodel als "High gain" bij een laag aantal requests en als "Medium gain" bij een hoog aantal | vLLM-documentatie |
| Draftmodel zit te vaak fout voor wat het kost | Geen winst. Er is alleen versnelling als de acceptatiegraad hoger is dan de kosten van het draftmodel ten opzichte van het doelmodel | Google-paper |
Ter illustratie: een acceptatiegraad van 0,6 met drie gokken per ronde levert ongeveer 2,2 tokens per pass op.
Gepubliceerde versnellingen: de Google-paper rapporteert 2X tot 3X op een T5-XXL-model met 11 miljard parameters. DeepMind rapporteert 2 tot 2,5 keer op het Chinchilla-model met 70 miljard parameters en een draftmodel van 4 miljard parameters. De resultaten hangen af van de modellen, de taak en de hardware.
Een productievoorbeeld uit voice: Tell-1, de eigen LLM van Retell, gebruikt speculative decoding om ongeveer vier tokens uit elke pass van het volledige model te halen, volgens de technische blogpost van Retell over Retell LLM.
Waarom is speculative decoding belangrijk voor realtime voice?
Speculative decoding is belangrijk voor realtime voice omdat een beller de rekentijd van het model als stilte hoort. Tijdens een gesprek is het model één stap in de pipeline van speech-to-text, LLM en text-to-speech, en de vertraging ervan telt op bij de latency van het gesprek.
De best practices voor Custom LLM van Retell leggen uit welk deel van de modeltijd telt. Retell "begint te spreken zodra het je eerste volledige zin heeft". Het getal om in de gaten te houden is dus "de tijd tot het eerste token plus de tijd om die eerste zin af te maken". Speculative decoding werkt op het tweede deel: zodra het genereren begint, komen tokens in groepjes binnen. Het verkort niet het inlezen van de prompt dat aan het eerste token voorafgaat. Daarvoor begint de handleiding voor het oplossen van latencyproblemen van Retell met modelkeuze en promptlengte.
De andere reden is nauwkeurigheid. Overstappen op een kleiner model verkort ook de vertraging, maar dezelfde handleiding waarschuwt dat een ander model "het gedrag van je agent verandert, niet alleen de snelheid". Exacte speculative decoding behoudt de output van het grote model.
De partij die het model host, past de techniek toe. Een agentbouwer merkt het dus als modelsnelheid. Bij Retell wordt Tell-1 op deze manier geserveerd. Wil je modellen vergelijken op snelheid en gesprekskwaliteit? Bekijk dan de beste LLM's voor AI-stemagents.
Veelgestelde vragen over speculative decoding
Is speculative decoding verliesvrij?
In de exacte vorm wel. De oorspronkelijke papers bewijzen dat de outputverdeling overeenkomt met die van het grote model. vLLM omschrijft het als "theoretisch verliesvrij tot aan de precisiegrenzen van de numerieke hardware". Varianten die de verificatie versoepelen, zijn niet verliesvrij.
Wie heeft speculative decoding bedacht?
Yaniv Leviathan, Matan Kalman en Yossi Matias van Google Research publiceerden de paper in november 2022 en presenteerden die op ICML 2023. Een team van DeepMind publiceerde in februari 2023 een eigen versie, speculative sampling genoemd.
Wat is een draftmodel?
Een draftmodel is het kleine, snelle model dat de gokken schrijft. Volgens de documentatie van Hugging Face werkt de methode het best wanneer het draftmodel "aanzienlijk kleiner is dan het hoofdmodel en dezelfde tokenizer gebruikt".
Verlaagt speculative decoding de kosten?
Dat kan beide kanten op. Volgens de Google-paper kan het totale aantal rekenkundige bewerkingen "hoger zijn dan dat van het standaard decoderingsalgoritme". Afgewezen gokken zijn namelijk verspild werk. De terugblik van Google uit 2024 voegt daaraan toe dat snellere resultaten op dezelfde hardware betekenen dat "er minder machines nodig zijn om dezelfde hoeveelheid verkeer te bedienen".
Is multi-token prediction hetzelfde als speculative decoding?
Nee. Multi-token prediction (MTP) is één manier om de gokken te produceren. De documentatie van vLLM noemt MTP naast draftmodellen als speculatiemethode.
Test de modelsnelheid op je eigen gesprekken
Retell AI is een platform voor AI-stemagents voor contactcenters. Neem contact op met het Retell-team over een pilot met echte gesprekken.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


