Session affinity, ook wel sticky sessions of sessiepersistentie genoemd, is een load-balancingtechniek die elk verzoek van dezelfde client of sessie naar dezelfde backendserver stuurt, zodat de status in het geheugen van die server bereikbaar blijft.
Zonder session affinity wordt elk verzoek afzonderlijk geplaatst. AWS stelt dat een Application Load Balancer standaard "elk verzoek onafhankelijk naar een geregistreerd target routeert", en dat de sticky-sessionfunctie het mogelijk maakt om "de sessie van een gebruiker aan een specifiek target te binden". Dat is belangrijk wanneer een server lokaal iets bewaart dat het volgende verzoek nodig heeft: een inlogsessie, een winkelwagen of een cache.
Hoe implementeren load balancers session affinity?
Een load balancer heeft een manier nodig om de sessie te herkennen en een regel die de sessie aan een server koppelt. Drie methoden dekken de meeste producten.
Cookie. De load balancer plaatst een cookie bij het eerste antwoord en leest die bij latere verzoeken uit. De duur-gebaseerde stickiness van AWS gebruikt een cookie met de naam AWSALB, met een levensduur die je instelt tussen 1 seconde en 7 dagen. HAProxy gebruikt een cookie om "te onthouden naar welke server de client eerder is gerouteerd". De client moet cookies ondersteunen.
IP-hash. Het IP-adres van de client bepaalt de server. ip_hash van NGINX gebruikt "de eerste drie octetten van het IPv4-adres van de client, of het volledige IPv6-adres" als hashsleutel. Een Kubernetes Service biedt hetzelfde idee als sessionAffinity: ClientIP, met een standaard time-out van 3 uur. Geen van beide heeft een cookie nodig, maar clients achter één gedeeld adres komen op dezelfde server terecht, en bij NGINX geldt dat ook voor iedereen die die drie octetten deelt.
Consistent hashing. De load balancer hasht een eigenschap van het verzoek, zoals een header of een sessie-ID, op een ring van servers. Envoy stelt dat bij een goed gepartitioneerde ring het toevoegen of verwijderen van één host uit een set van N "slechts 1/N van de verzoeken beïnvloedt". De hash-directive van NGINX heeft een optie consistent die volgens de documentatie "helpt een hogere cache-hitratio te bereiken voor cachingservers".
| Methode | Waaraan de sessie wordt herkend | Gedocumenteerd voorbeeld | Belangrijkste beperking |
|---|---|---|---|
| Cookie | Een cookie die door de load balancer of de applicatie wordt geplaatst | AWS Application Load Balancer, HAProxy | De client moet cookies ondersteunen |
| IP-hash | Het IP-adres van de client | NGINX ip_hash, Kubernetes ClientIP | Clients achter een gedeeld adres stapelen zich op één server op |
| Consistent hashing | Elke verzoekeigenschap die je kiest | Envoy ring hash en Maglev, NGINX hash ... consistent | Elk verzoek moet een stabiele sleutel bevatten |
| Prefix-aware routing | De eerste tokens van een LLM-prompt | OpenAI prompt caching, Ray Serve | De belasting telt nog steeds mee, dus een drukke server kan het verzoek mislopen |
Wat zijn de nadelen van sticky sessions?
Session affinity levert wat balans en veerkracht in om de status dichtbij te houden.
- De belasting kan scheef raken. Google Cloud stelt dat affinity "goed werkt wanneer er een redelijk grote spreiding van unieke verbindingen is". Bij weinig of ongelijke sessies dragen sommige servers meer, wat ten koste gaat van de schaalbaarheid.
- Een uitgevallen server beëindigt de affinity. Als bij AWS een target uitvalt, "kiest de load balancer een nieuw gezond target" en houdt de sessie daar vast, "zelfs als het uitgevallen target terugkomt". Alles wat alleen in het geheugen van de oude server stond, moet opnieuw worden opgebouwd.
- Het is best effort. Google Cloud biedt session affinity "op best-effortbasis" en noemt wijzigingen in health checks, toegevoegde of verwijderde backends en volle backends als gebeurtenissen die de affinity kunnen verbreken.
De documentatie van HAProxy geeft het standaardadvies: "Vaak is het optimaal om sessiepersistentie helemaal te vermijden door je services stateless te bouwen", bijvoorbeeld door de status in een gedeelde database op te slaan. Affinity is bedoeld voor status die je niet goedkoop kunt verplaatsen. Een cache is het gebruikelijke geval.
Waarom is session affinity belangrijk voor LLM-serving?
Omdat de cache die een herhaalde prompt goedkoop maakt op één machine staat. Een modelserver bewaart de berekende status van een prompt, de KV-cache, in het geheugen. vLLM hergebruikt die wanneer een nieuwe query "dezelfde prefix deelt met een van de bestaande queries, zodat de nieuwe query de berekening van het gedeelde deel kan overslaan".
Dat werkt alleen als het volgende verzoek dezelfde machine bereikt. De prompt-cachinggids van OpenAI zegt het rechtstreeks: "Gecachte statussen staan op individuele machines", en "een verzoek kan een gecachte prefix alleen hergebruiken als het een machine bereikt met een overeenkomende entry die niet is verlopen". OpenAI routeert op basis van machinebelasting, een hash van de eerste tokens van de prompt en, bij oudere modellen, een cachesleutel die je zelf opgeeft. Voor zelfgehoste modellen levert Ray Serve een router die "verzoeken met vergelijkbare prefixen naar dezelfde replica's routeert, waardoor de KV-cache-hitratio's worden gemaximaliseerd", en die terugvalt op gewone load balancing wanneer wachtrijen ongelijk zijn.
Telefoongesprekken passen goed in dit patroon. Bij elke beurt van een gesprek met meerdere beurten stuurt een stemagent het large language model zijn instructies plus het transcript tot dan toe, omdat het model het gesprek niet onthoudt tussen verzoeken. Elk verzoek herhaalt het grootste deel van het vorige. Het gesprek is dus de sessie en de call-ID is een logische sleutel. Een beurt die op een andere server terechtkomt, verwerkt de hele prompt opnieuw, wat de latency verhoogt.
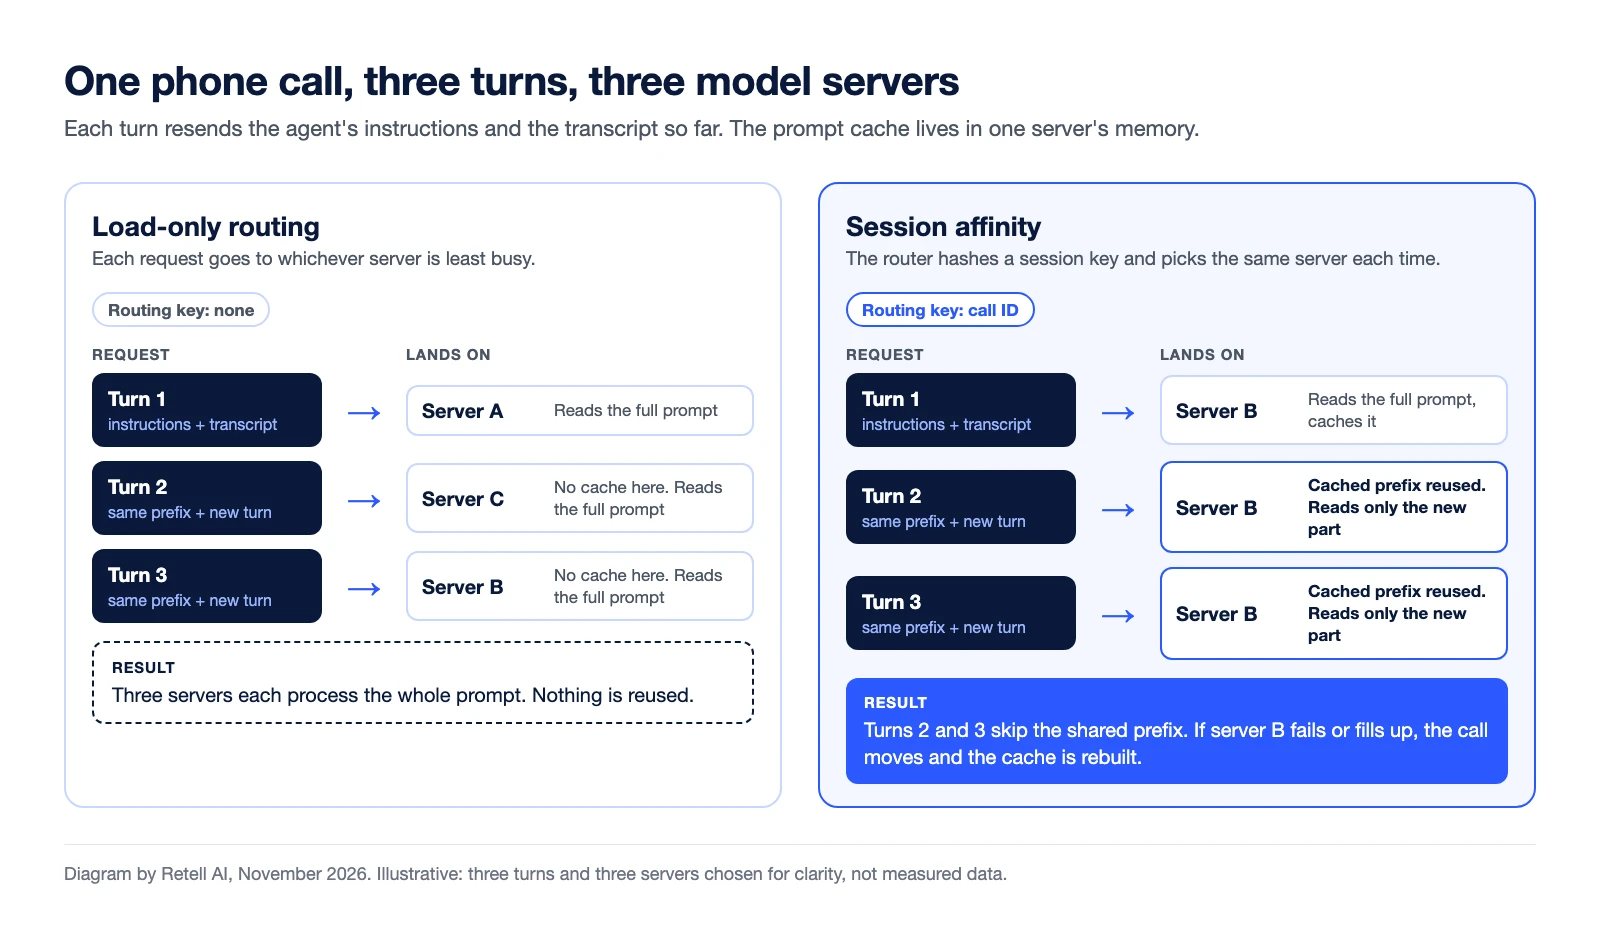
Tell-1, het eigen LLM van Retell, wordt op deze manier geserveerd. Het technische artikel over de Retell LLM noemt dit call-aware routing: elke beurt verstuurt het hele gesprek opnieuw, dus elk gesprek blijft op de GPU's die het al in de cache hebben. Volgens het artikel steeg daardoor het aandeel prompttokens dat uit de cache werd geserveerd van 36% naar 69%.
Waar session affinity een rol speelt bij Retell
Het speelt een rol wanneer je je eigen modelserver draait. Met een Custom LLM "opent Retell voor elk gesprek een WebSocket naar je server", met de call-ID als laatste padsegment van de URL. AWS merkt op dat "WebSocket-verbindingen van nature sticky zijn", dus een gesprek blijft op een van je servers zolang de socket open is.
De best practices van Retell raden aan om "expliciete status per gesprek op je server bij te houden, met de call-ID uit de WebSocket-URL als sleutel". Retell bouwt ook een verbinding opnieuw op die midden in een gesprek wegvalt, en als je meerdere servers achter een load balancer draait, kan de nieuwe socket bij een andere server uitkomen. Om de status bereikbaar te houden, routeer je op de call-ID in het pad, of bewaar je die status in een gedeelde opslag. IP-hash spreidt de belasting hier niet: de installatiegids noemt één uitgaand IP-adres voor deze verbinding, dus elk gesprek wordt naar dezelfde server gehasht.
Veelgestelde vragen over session affinity
Is session affinity hetzelfde als sticky sessions?
Ja. AWS omschrijft zijn sticky-sessionfunctie als "ook bekend als session affinity". Sessiepersistentie is een derde naam voor hetzelfde.
Wat gebeurt er met een sticky session als de server uitvalt?
De load balancer kiest een andere gezonde server en de sessie blijft daar plakken. Status die alleen in het geheugen van de uitgevallen server stond, gaat verloren, tenzij die ook ergens gedeeld was opgeslagen.
Hebben WebSocket-verbindingen sticky sessions nodig?
Niet zolang de verbinding open is, want elk bericht gaat via dezelfde verbinding naar dezelfde server. Affinity wordt weer belangrijk wanneer de client opnieuw verbinding maakt.
Waarom is session affinity belangrijk voor prompt caching?
Een promptcache staat in het geheugen van de machine die hem heeft opgebouwd. Een vervolgverzoek krijgt de gecachte prefix alleen als het naar die machine wordt gerouteerd.
Gebruik je eigen model in live gesprekken
Retell AI is een platform voor AI-stemagenten voor contactcenters. Retell regelt telefonie, transcriptie, beurtwisseling en spraak, en de Custom LLM-integratie verbindt je modelserver via één WebSocket per gesprek.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


