SSML (Speech Synthesis Markup Language) is een op XML gebaseerde opmaaktaal die een text-to-speech-engine vertelt hoe een stuk tekst moet worden uitgesproken: waar te pauzeren, hoe een woord uit te spreken, hoe een getal of datum voor te lezen, en hoe snel, hard of hoog te spreken. De engine leest de tags als instructies en spreekt ze niet uit.
SSML is een standaard van het World Wide Web Consortium (W3C). De huidige versie, SSML 1.1, werd op 7 september 2010 een W3C Recommendation en is opgesteld door de Voice Browser Working Group van het W3C. Volgens de specificatie is het doel om auteurs "een standaardmanier te bieden om aspecten van spraak zoals uitspraak, volume, toonhoogte, tempo enz. te sturen op verschillende platforms die spraaksynthese ondersteunen".
Hoe ziet SSML eruit?
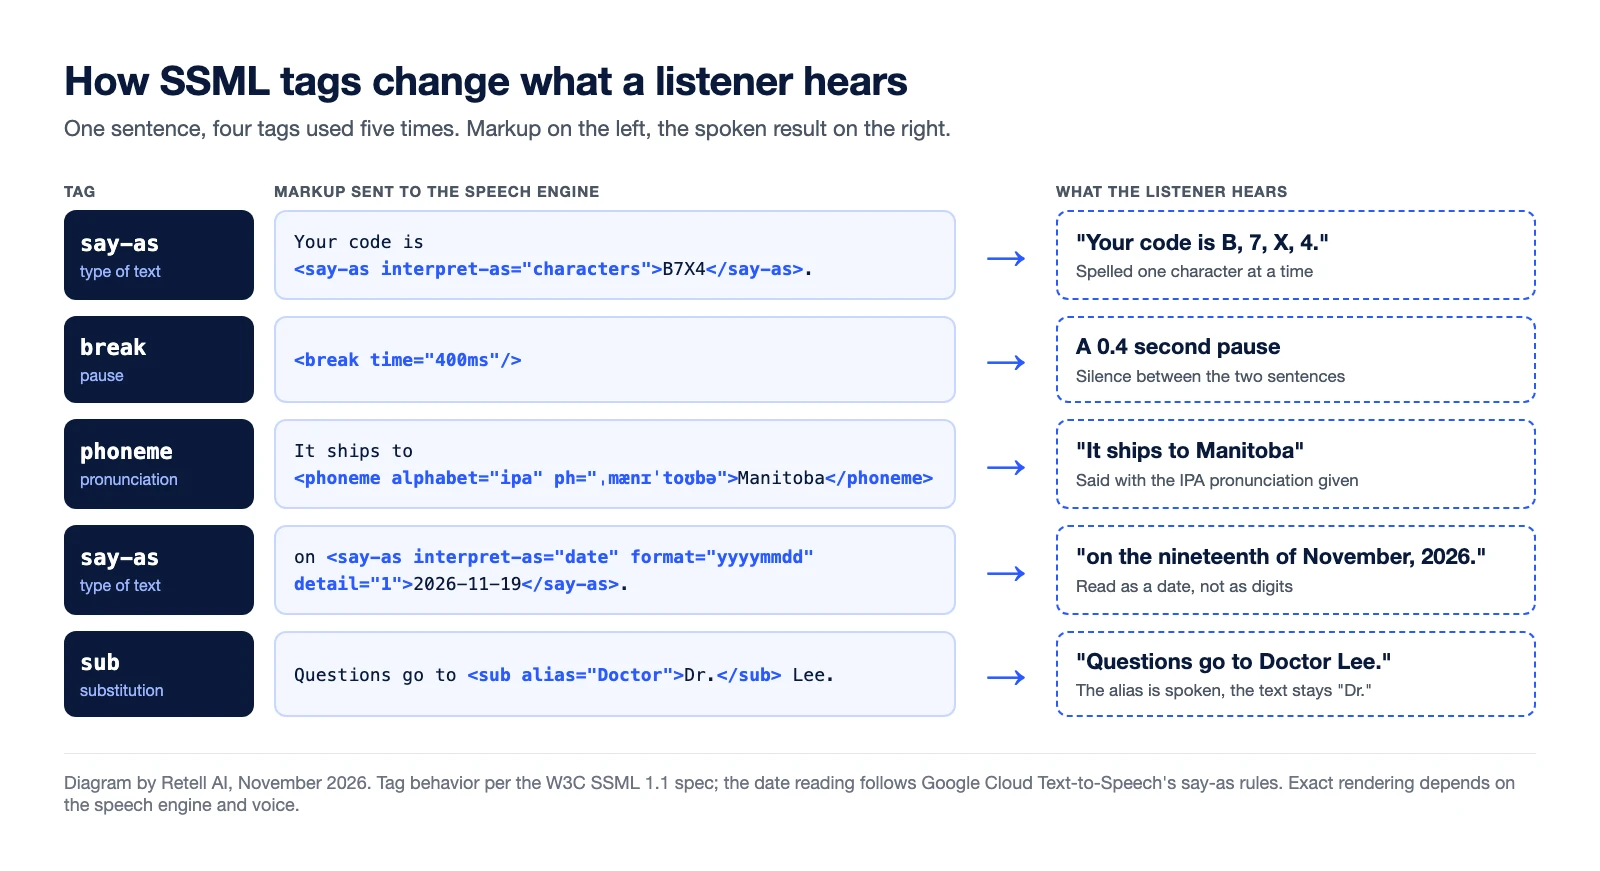
Een SSML-document is XML met één root-element, <speak>. Dit korte voorbeeld is geldige SSML 1.1:
<speak version="1.1" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="en-US">
  Your code is <say-as interpret-as="characters">B7X4</say-as>.
  <break time="400ms"/>
  It ships to <phoneme alphabet="ipa" ph="ˌmænɪˈtoʊbə">Manitoba</phoneme>
  on <say-as interpret-as="date" format="yyyymmdd" detail="1">2026-11-19</say-as>.
  Questions go to <sub alias="Doctor">Dr.</sub> Lee.
</speak>
De afbeelding laat zien wat een luisteraar bij elke tag hoort als de engine die ondersteunt.
Wat zijn de meest gebruikte SSML-tags?
De beschrijvingen volgen de W3C-specificatie.
| Tag | Wat het doet | Voorbeeld |
|---|---|---|
<speak> | Root-element van elk SSML-document. In SSML 1.1 zijn de attributen version en xml:lang verplicht, plus de SSML-namespace. | <speak version="1.1" xml:lang="en-US"> |
<break> | Voegt een pauze of prosodische grens toe, ingesteld via strength (none tot x-strong) of via time. | <break time="400ms"/> |
<say-as> | Vertelt de engine wat voor tekst hij voorleest, zoals een datum, een tijd, een getal of een geldbedrag. | <say-as interpret-as="characters">B7X4</say-as> |
<phoneme> | Geeft een fonetische uitspraak voor de omsloten tekst. Volgens de specificatie moeten engines het ipa-alfabet ondersteunen. | <phoneme alphabet="ipa" ph="..."> |
<sub> | Spreekt de waarde van alias uit in plaats van de geschreven tekst. | <sub alias="Doctor">Dr.</sub> |
<prosody> | Wijzigt de toonhoogte, het spreektempo en het volume van de omsloten tekst. | <prosody rate="slow"> |
<emphasis> | Vraagt om nadruk op een woord of zinsdeel, met een level van strong, moderate, none of reduced. | <emphasis level="strong"> |
Twee details in de specificatie verklaren waarom de resultaten verschillen. Ten eerste definieert ze <say-as>, maar "somt ze de mogelijke waarden voor de attributen niet op", dus elke leverancier bepaalt zelf de lijst met interpret-as-waarden. Ten tweede noemt ze prosodiewaarden "indicatief" en laat ze de engine bepalen hoe nadruk wordt weergegeven.
Waar verschilt de SSML-ondersteuning tussen spraakengines?
Elke engine implementeert een eigen subset, en nieuwere stemmodellen ondersteunen vaak minder opmaak dan oudere. Op basis van de documentatie van elke leverancier, geraadpleegd op 13 november 2026:
- Google Cloud Text-to-Speech ondersteunt "een subset van de beschikbare SSML-tags". De Chirp 3: HD-stemmen accepteren tien tags zonder
<emphasis>, andere tags "worden genegeerd", en streamingverzoeken accepteren geen SSML. - Amazon Polly vermeldt tagondersteuning per stemtype.
<emphasis>is niet beschikbaar voor neural-, long-form- of generatieve stemmen, en een niet-ondersteunde tag bij standard-, neural- of long-form-stemmen geeft een foutmelding. - Azure AI Speech baseert zijn implementatie op SSML 1.0 en meldt dat de ondersteunde elementen "kunnen afwijken van de W3C-standaard". Het voegt eigen
mstts-elementen toe voor spreekstijlen, en nadruk op woordniveau werkt bij drie specifieke Engelse stemmen. - ElevenLabs ondersteunt twee SSML-tags op sommige modellen:
<break>voor pauzes tot 3 seconden, en<phoneme>alleen op Flash v2. Eleven v3 en v4 ondersteunen geen break-tags. - Cartesia Sonic documenteert eigen "SSML-achtige" tags: speed, volume, emotion, break en spell.
Hetzelfde document kan door de ene engine worden gevolgd, door een andere stilzwijgend worden genegeerd en door een derde worden geweigerd. Test je opmaak op precies de stem en het model die je gaat gebruiken.
Waarom is SSML belangrijk voor stemagents?
Een beller kan de tekst niet zien. Bij voice-AI kost een verkeerde uitspraak een herhaling of een foutieve registratie:
- Namen. Uitspraak van merken, medicijnen en achternamen die de stem verkeerd raadt.
- Getallen. Een bevestigingscode die als één woord wordt voorgelezen, of een rekeningnummer dat als hoeveelheid wordt voorgelezen.
- Datums en tijden. Een datum zoals 11/19 die als twee losse getallen wordt voorgelezen.
- Pauzes. Tijd om elk deel van een telefoonnummer op te schrijven.
SSML is geschikt voor gescripte prompts, waarbij een developer elke regel één keer tagt. Dat past bij een IVR-menu. Het past minder goed bij een live AI-stemagent.
Hoe regelen LLM-gestuurde stemagents de uitspraak zonder SSML?
In een LLM-gestuurde agent schrijft een large language model elk antwoord tijdens het gesprek, en de tekst wordt naar de spraakengine gestreamd terwijl die wordt gegenereerd (hoe de STT-, LLM- en TTS-pipeline werkt). Niemand tagt zinnen met de hand, en streaming brengt een extra valkuil met zich mee: de documentatie van Cartesia waarschuwt dat een speed- of volume-tag die over gestreamde tokens wordt opgesplitst, hardop wordt voorgelezen. Teams gebruiken daarom vier andere methoden:
- Prompt voor uitspreekbare tekst. Laat het model "vier één vijf" schrijven in plaats van "415".
- Tekstnormalisatie. Een stap vóór de synthese zet getallen, datums en valuta om in gesproken vorm.
- Een uitspraakwoordenboek. Een woordenlijst met fonetische spellingen, toegepast op elk antwoord.
- Spraakinstellingen van het platform. Inline markeringen die het platform per stemprovider vertaalt.
Hoe regelt Retell AI pauzes en uitspraak?
De documentatie van Retell AI beschrijft geen invoer van ruwe SSML. Wel worden deze instellingen gedocumenteerd:
- Pauzes en spellen. Volgens de documentatie over spraakinstellingen voegt een streepje met een spatie aan weerszijden een pauze toe, en laten
<spell>-tags een code of rekeningnummer teken voor teken voorlezen. Retell zet de tag om "naar het formaat dat het beste werkt voor de stem van je agent". - Uitspraakwoordenboek. Vermeldingen bestaan uit een woord en een foneem in IPA, CMU, Pinyin of Jyutping. Stemmen van het Retell-platform accepteren IPA en CMU, en sommige providermodellen accepteren geen van beide.
- Speech Normalization. Een preset in het Agent Handbook, standaard uitgeschakeld, die getallen, datums, geldbedragen en telefoonnummers omzet in gesproken vorm.
Zie ook hoe AI-stemagents werken tijdens een gesprek.
Veelgestelde vragen over SSML
Waarvoor wordt SSML gebruikt?
Het bepaalt hoe een text-to-speech-engine tekst hardop voorleest: pauzes, uitspraak, het voorlezen van getallen en datums, en toonhoogte, tempo en volume.
Is SSML op elke text-to-speech-engine hetzelfde?
Nee. Elke engine ondersteunt een eigen subset van de W3C-specificatie en voegt eigen tags toe, dus opmaak moet vaak worden aangepast als je van engine wisselt.
Ondersteunt ElevenLabs SSML?
Deels. De documentatie beschrijft break-tags voor pauzes tot 3 seconden en phoneme-tags op het Flash v2-model. Eleven v3 en v4 ondersteunen geen break-tags (stand november 2026).
Wat is het verschil tussen SSML en een uitspraakwoordenboek?
SSML-tags staan in één stuk tekst en gelden alleen daar. Een uitspraakwoordenboek is een aparte woordenlijst die de engine of het platform op elk overeenkomend woord toepast.
Gebruiken AI-stemagents SSML?
Sommige wel, als de spraakengine het accepteert. Veel agents vertrouwen op prompting, tekstnormalisatie en uitspraakwoordenboeken, omdat antwoorden live worden gegenereerd en sommige nieuwere stemmodellen weinig SSML accepteren.
Laat elke naam en elk getal goed klinken
Retell AI is een platform voor AI-stemagents voor contactcenters. Je kunt pauzes, spelling en uitspraak per agent instellen en het resultaat beluisteren in een testgesprek via het web. Neem contact op met het Retell-team.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


