LLM as a judge (LLM als beoordelaar) is een evaluatiemethode waarbij één groot taalmodel de output van een ander AI-systeem scoort of rangschikt aan de hand van vastgelegde criteria, in plaats van een menselijke beoordelaar. Teams gebruiken het om open taken te beoordelen, zoals een telefoongesprek, waarvoor geen enkel juist antwoord bestaat.
De naam komt van een paper uit 2023, Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. De auteurs rapporteerden dat sterke beoordelaars zoals GPT-4 met menselijke voorkeuren overeenkwamen met "meer dan 80% overeenstemming, hetzelfde niveau van overeenstemming als tussen mensen". Ze noemden ook de beperkingen: positiebias, breedsprakigheidsbias en zelfbevoordelingsbias.
Hoe scoort een LLM-beoordelaar een gesprek?
Een LLM-beoordelaar leest het gesprek en een set instructies, en geeft vervolgens een oordeel in een van drie vormen.
| Methode | Wat de beoordelaar doet | Wat je terugkrijgt | Waar het past |
|---|---|---|---|
| Rubricbeoordeling | Leest één transcript aan de hand van vastgelegde criteria | Geslaagd of niet geslaagd, of een score, met een reden | QA in productie en regressietests |
| Paarsgewijze rangschikking | Vergelijkt twee of meer antwoorden op dezelfde beurt | Een winnaar of een rangorde | Kiezen tussen prompts of modellen |
| Beoordelaarspanel | Meerdere beoordelaarsmodellen beoordelen hetzelfde item en de oordelen worden samengevoegd | Eén samengevoegde score | Scores die door de bias van één model scheef kunnen trekken |
Rubricbeoordeling. In de G-Eval-paper redeneerde de beoordelaar eerst de criteria door en vulde daarna een scoreformulier in. Bij samenvattingen correleerden de scores beter met menselijke beoordelingen dan eerdere methoden.
Paarsgewijze rangschikking. Vragen welke van twee antwoorden beter is, werkt goed voor eigenschappen als toon, waarbij een verschil makkelijker te zien is dan te scoren.
Beoordelaarspanels. In Replacing Judges with Juries "presteert" een panel van kleinere modellen uit verschillende modelfamilies "beter dan één grote beoordelaar, vertoont het minder intra-modelbias" en was het "meer dan zeven keer goedkoper".
Hoe wordt LLM as a judge gebruikt bij QA en benchmarks voor AI-stemagenten?
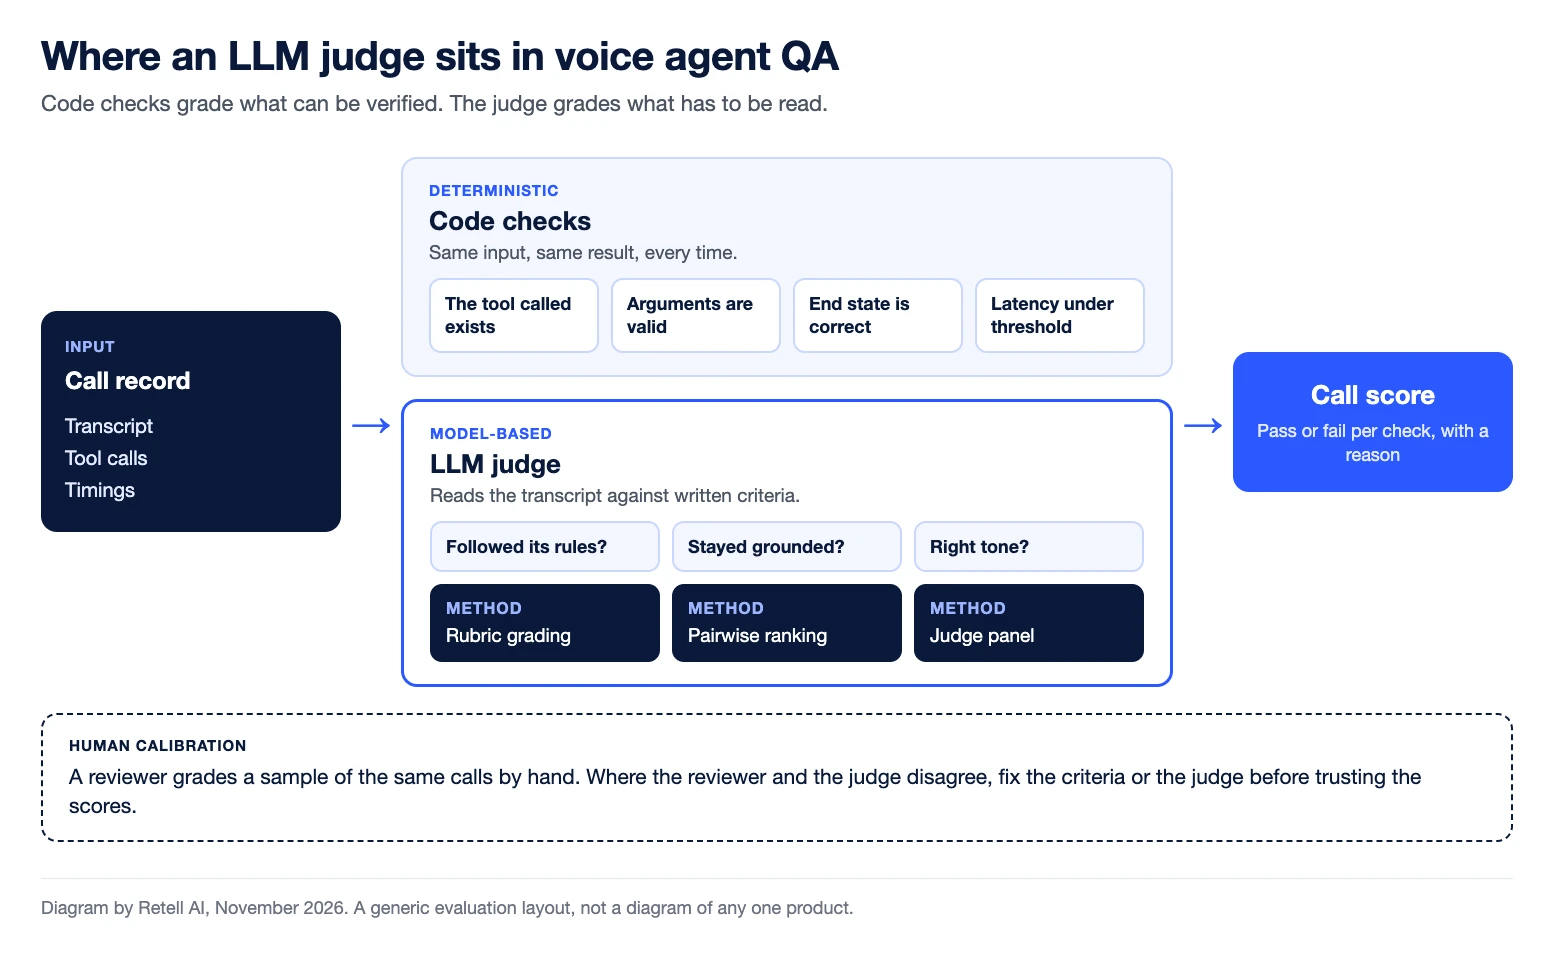
QA voor AI-stemagenten gebruikt een LLM-beoordelaar voor de onderdelen van een gesprek die alleen door het transcript te lezen beslecht kunnen worden: of de agent zich aan de regels hield, binnen de bronnen bleef en het verzoek oploste.
De documentatie van Retell laat beide gangbare opstellingen zien. In AI QA is een door AI beoordeelde voorwaarde "een kwalitatieve controle die de AI uitvoert op het transcript en de context van elk gesprek", geschreven als "de prompt die de AI gebruikt om te beoordelen of aan de voorwaarde is voldaan". Bij simulatietests speelt een AI de beller en "wordt elke run als geslaagd of niet geslaagd beoordeeld, met een schriftelijke toelichting".
Benchmarks rapporteren hetzelfde soort oordeel op schaal. De Retell vCX Benchmark publiceert elke suitescore als slagingspercentage, "het percentage geteste scenario's dat correct werd afgehandeld", voor het opvolgen van instructies, grounding, tool calling en spreektaal (geraadpleegd op 13 november 2026).
Wil je oordelen omzetten in een wekelijkse review? Bekijk de QA-scorecard voor AI-stemagenten.
Wat zijn de bekende faalwijzen van een LLM-beoordelaar?
Een LLM-beoordelaar faalt op vier gedocumenteerde manieren. Voor elk ervan bestaat een bekende controle.
- Positiebias. In Large Language Models are not Fair Evaluators liet het omwisselen van de volgorde van twee antwoorden één model "66 van de 80 geteste queries" winnen. Voer elke vergelijking in beide volgordes uit.
- Zelfvoorkeur. Een studie uit 2024 stelde vast dat een beoordelaar "zijn eigen output hoger scoort dan die van anderen, terwijl menselijke annotators ze van gelijke kwaliteit vinden". Gebruik een beoordelaar uit een andere modelfamilie, of een panel.
- Zwakke overeenstemming met mensen. Judging the Judges testte dertien beoordelaarsmodellen en concludeerde dat "alleen de beste (en grootste) modellen een redelijke afstemming met mensen bereiken", met "een neiging tot mildheid". Beoordeel een steekproef handmatig en vergelijk.
- Drift. Het model achter een API kan veranderen: één studie mat dat de nauwkeurigheid van GPT-4 op dezelfde taak in drie maanden daalde van 84% naar 51%. Ook criteria verschuiven. Who Validates the Validators? noemt dit criteria drift: "gebruikers hebben criteria nodig om output te beoordelen, maar het beoordelen van output helpt gebruikers criteria te definiëren". Zet de versie van de beoordelaar vast en voer na elke wijziging opnieuw een vaste, handmatig gelabelde set uit.
Beoordelaars zijn bovendien niet deterministisch. De simulatiedocumentatie van Retell adviseert: "Beoordeel een scenario op het slagingspercentage over meerdere runs, niet op één run."
Wanneer zijn codecontroles beter dan een LLM-beoordelaar?
Codecontroles winnen van een LLM-beoordelaar zodra het antwoord geverifieerd kan worden in plaats van gelezen. De gids van Anthropic over evals voor agents raadt aan om "waar mogelijk deterministische graders te kiezen, en LLM-graders waar nodig". Codegebaseerde graders worden daarin omschreven als snel, goedkoop, objectief en reproduceerbaar, en modelgebaseerde graders als niet-deterministisch.
Bij een gesprek kan code controleren of de tool die de agent aanriep bestaat, of de argumenten geldig zijn en of de responstijd onder een drempel bleef. tau-bench beoordeelt hele gesprekken op deze manier door "de databasestatus aan het einde van een gesprek te vergelijken met de geannoteerde doelstatus".
AI QA van Retell houdt de twee gescheiden: prestatiestatistieken zijn kwantitatieve drempels, en door AI beoordeelde voorwaarden bevatten de kwalitatieve controles. Wijzigingen aan AI-stemagenten testen en uitrollen beschrijft waar elk ervan wordt uitgevoerd.
Hoe worden beoordelaarspanels gebruikt om een stemmodel te trainen?
Tell-1, het eigen LLM van Retell, gebruikte LLM-beoordelaars in twee van de drie trainingsfasen, volgens de technische blogpost over het Retell LLM. De fase voor preference tuning leerde van "voorkeursparen die door een panel van LLM-beoordelaars waren gerangschikt".
In de reinforcement learning-fase "schrijft het model acht antwoorden en wordt elk ervan gescoord", aldus de post. Code draait eerst: aanroepen van tools buiten de toolbox van de agent, misvormde output en andere kritieke fouten "worden in code opgevangen voordat een beoordelaar ze ziet". Voor correctheid "beoordelen meerdere beoordelaarsmodellen de juistheid van tool calls, hallucinaties en het opvolgen van instructies, en worden hun oordelen samengevoegd tot één beloningssignaal". Voor natuurlijkheid rangschikt één beoordelaar alle acht antwoorden naast elkaar aan de hand van een rubric, omdat "natuurlijkheid makkelijker te vergelijken is dan te scoren".
Dat is het patroon dat deze pagina beschrijft: codecontroles voor wat verifieerbaar is, een beoordelaarspanel voor correctheid en rangschikking voor toon.
Veelgestelde vragen over LLM as a judge
Wat doet een LLM-beoordelaar?
Hij leest een output, zoals een gesprekstranscript, samen met beoordelingsinstructies, en geeft een oordeel: geslaagd of niet geslaagd, een score, of een voorkeur tussen twee opties.
Hoe betrouwbaar is LLM as a judge?
Dat hangt af van het beoordelaarsmodel en de taak. Eén studie vond meer dan 80% overeenstemming met menselijke voorkeuren; een andere stelde vast dat alleen de grootste beoordelaars redelijk met mensen overeenkwamen. Toets een beoordelaar eerst aan handmatig beoordeelde gesprekken.
Wat is een beoordelaarspanel?
Een beoordelaarspanel bestaat uit meerdere beoordelaarsmodellen die dezelfde output beoordelen, waarna hun oordelen worden samengevoegd. Dat beperkt het effect van de bias van één afzonderlijk model.
Wat is het verschil tussen rubricbeoordeling en paarsgewijze rangschikking?
Bij rubricbeoordeling wordt één output gescoord aan de hand van vastgelegde criteria. Bij paarsgewijze rangschikking krijgt de beoordelaar twee outputs te zien met de vraag welke beter is.
Kan een LLM-beoordelaar een telefoongesprek scoren?
Ja, op basis van het transcript en de tool calls. Voor eigenschappen die in de audio zitten, is ook de audio nodig: volgens de documentatie van Retell wordt Agent Naturalness "beoordeeld op basis van zowel de audio als het transcript".
Scoor je eigen gesprekken voordat je opschaalt
Retell AI is een platform voor AI-stemagenten voor contactcenters. AI QA beoordeelt een steekproef van je gesprekken aan de hand van de voorwaarden en drempels die jij instelt, met bewijs uit het transcript voor elk resultaat.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


