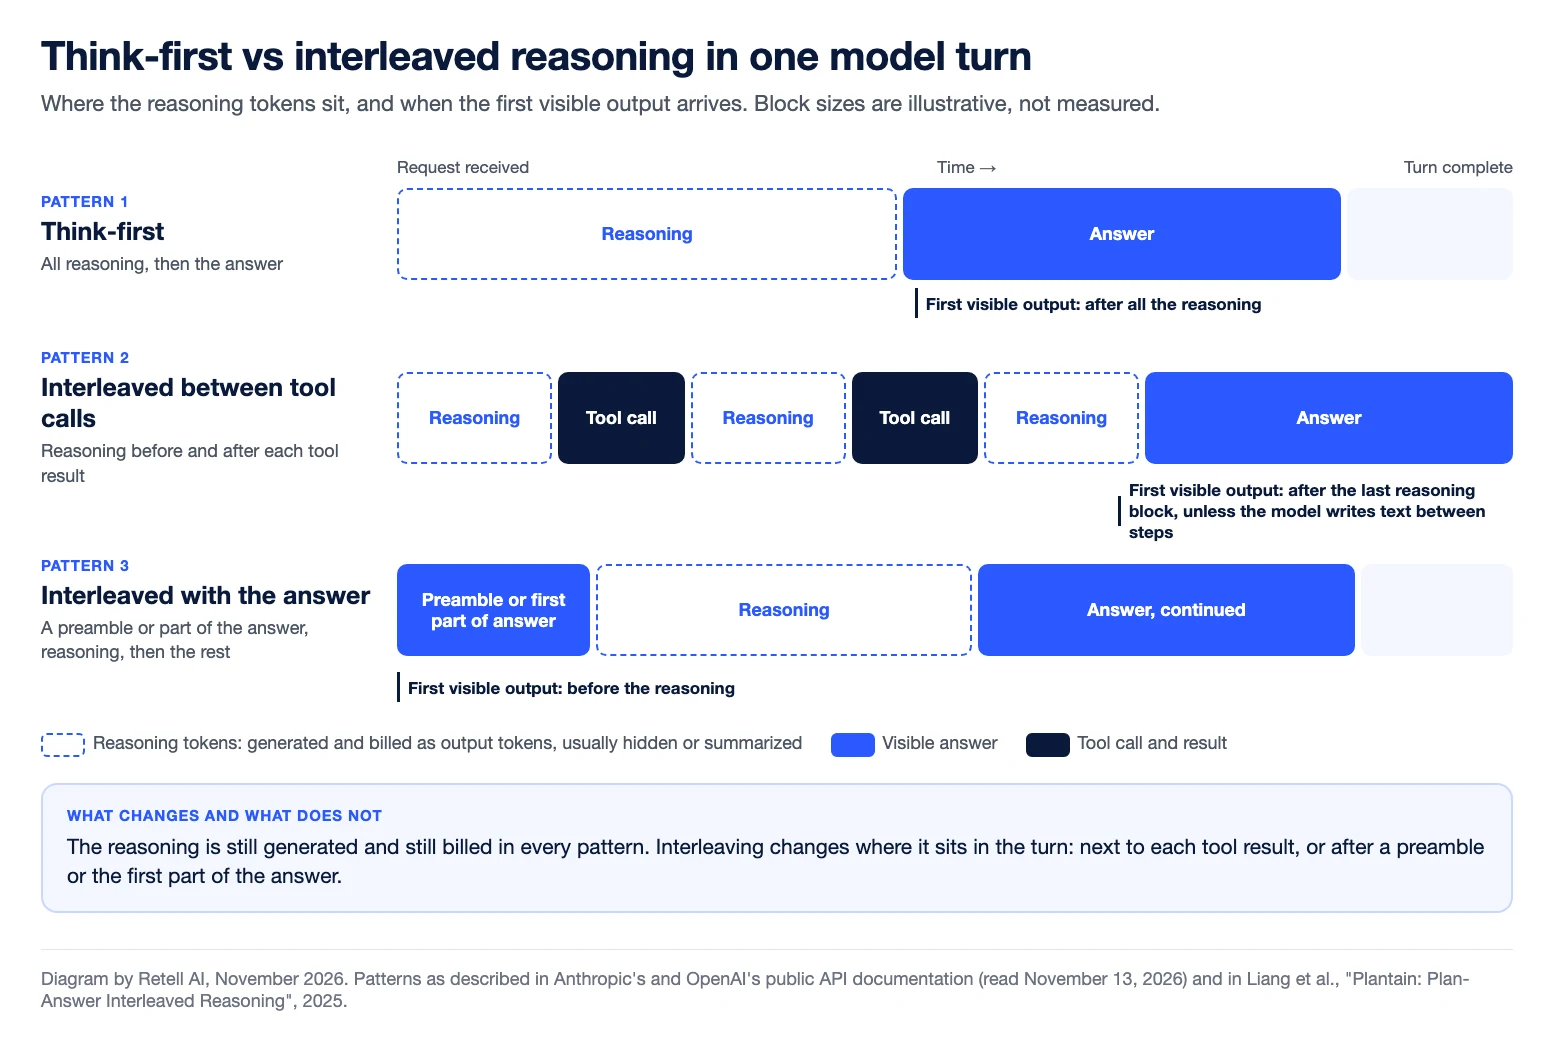
Interleaved Reasoning (verschachteltes Reasoning) ist eine Betriebsweise eines Reasoning-Modells, bei der das Modell zwischen internem Reasoning und sichtbaren Aktionen wie Tool-Aufrufen oder Teilen seiner Antwort wechselt, anstatt sein gesamtes Reasoning abzuschließen, bevor es antwortet.
Man spricht auch von Interleaved Thinking. In der Dokumentation der Anbieter bezeichnet der Begriff meist Reasoning zwischen Tool-Aufrufen. In Forschungsarbeiten steht er für ein Modell, das abwechselnd denkt und Teile seiner Antwort ausgibt. Beide beschreiben dieselbe Veränderung: Das Reasoning ist nicht länger ein einzelner Block am Anfang des Turns.
Was ist ein Reasoning-Modell?
Ein Reasoning-Modell ist ein Large Language Model, das vor seiner Antwort ein Zwischen-Reasoning erzeugt. Der Reasoning-Leitfaden von OpenAI fasst es in einem Satz zusammen: „Reasoning-Modelle verwenden interne Reasoning-Tokens, bevor sie eine Antwort erzeugen.“ Die Gemini-Dokumentation von Google beschreibt ein Thinking-Modell als eines, das „intern schlussfolgert, bevor es antwortet“, und die Dokumentation von DeepSeek besagt, dass sein Thinking-Modus Chain-of-Thought-Reasoning erzeugt, „um die Genauigkeit der endgültigen Antwort zu verbessern“.
Was sind Reasoning-Tokens?
Reasoning-Tokens, auch Thinking-Tokens genannt, sind die Tokens, die ein Modell erzeugt, während es ein Problem durcharbeitet. Sie sind nicht Teil der Antwort. Drei Eigenschaften sind wichtig:
- Sie werden abgerechnet. Laut OpenAI werden Reasoning-Tokens „als Output-Tokens abgerechnet“. Die Thinking-Dokumentation von Anthropic sagt dasselbe über Claude, „auch wenn Ihnen der Thinking-Text nicht zurückgegeben wird“. Google berechnet eine Antwort als „die Summe aus Output-Tokens und Thinking-Tokens“.
- Sie sind oft verborgen. Die Reasoning-Tokens von OpenAI sind „über die API nicht sichtbar“. Anthropic erklärt, dass das, was Sie sehen, „niemals die rohe Chain of Thought“ ist. Beide können auf Anfrage eine Zusammenfassung liefern.
- Sie kosten Zeit und Platz. Laut OpenAI kann ein Modell bei einer einzigen Anfrage „zwischen einigen Hundert und Zehntausenden Reasoning-Tokens“ erzeugen, und diese belegen das Kontextfenster.
Entwickler steuern die Menge über eine Einstellung: Reasoning Effort bei OpenAI, Effort bei Anthropic, Thinking Level bei Google.
Wie unterscheidet sich Interleaved Reasoning von Think-First-Reasoning?
Beim Think-First-Reasoning findet das gesamte Reasoning vor dem ersten sichtbaren Token statt. Anthropic nennt das Up-Front-Thinking: Thinking-Blöcke „kommen vor den Textblöcken an“. Interleaved Reasoning teilt das Reasoning in kleinere Blöcke auf und platziert sie dort, wo sie gebraucht werden.
| Muster | Ablauf innerhalb eines Turns | Was der Nutzer zuerst sieht | Öffentlich beschrieben von |
|---|---|---|---|
| Kein Reasoning | Antwort | Den Anfang der Antwort | Jedes Modell mit deaktiviertem Reasoning |
| Think-First | Gesamtes Reasoning, dann die Antwort | Nichts, bis das Reasoning endet | Anthropic (Up-Front-Thinking), DeepSeek |
| Verschachtelt zwischen Tool-Aufrufen | Reasoning, Tool aufrufen, Ergebnis lesen, erneut Reasoning, dann Antwort | Nichts, bis der letzte Reasoning-Block endet, es sei denn, das Modell schreibt zwischen den Schritten Text | Anthropic, OpenAI, vLLM, DeepSeek (ohne den Begriff) |
| Verschachtelt mit der Antwort | Eine Einleitung oder ein Teil der Antwort, Reasoning, weitere Teile der Antwort | Eine Einleitung oder einen frühen Teil der Antwort | OpenAI, Forschungsarbeiten |
| Verschachtelt mit Sprache | Erster Satz der Antwort, stilles Reasoning während der Wiedergabe, dann der Rest der Antwort | Den ersten Satz der Antwort | Tell-1, das eigene LLM von Retell |
Was dokumentieren die Anbieter heute?
Stand: 13. November 2026:
- Anthropic. „Interleaved Thinking ermöglicht es Claude, zwischen Tool-Aufrufen zu denken und über jedes Tool-Ergebnis nachzudenken, bevor es darauf reagiert.“ Bei Modellen, die Adaptive Thinking unterstützen, ist es automatisch aktiv. Modelle mit manuellem Extended Thinking benötigen einen Beta-Header.
- OpenAI. Modelle wie gpt-5.5 „unterstützen Interleaved Thinking, bei dem das Modell sichtbare Output-Tokens vor und zwischen dem Denken erzeugen und zwischen Tool-Aufrufen denken kann“.
- Google. Die Gemini-Seite zum Thinking verwendet den Begriff nicht. Dort heißt es, dass Denkschritte „chronologisch neben Function Calls, Nutzereingaben oder Modellausgaben erscheinen“ und dass Thought Signatures „erforderlich sind, um die Kontinuität des Reasonings über Multi-Turn-Interaktionen hinweg zu wahren“.
- vLLM. Der Open-Source-Inferenzserver unterstützt Interleaved Thinking für zwei Modellserien und warnt, dass es „den Token-Verbrauch und die Antwortlatenz erhöht“.
In der Forschung haben Xie et al. (2025) Modelle darauf trainiert, „Denken und Antworten zu verschachteln“, und berichten, dass die Time to First Token im Durchschnitt um über 80 % sank. Liang et al. (2025) definieren Interleaved Reasoning als ein Modell, das „zwischen Denken und der Ausgabe von Zwischenantworten wechselt“, und berichten, dass ihre Plan-First-Variante Plantain die Zeit bis zur ersten Antwort um über 60 % verkürzte. Beide untersuchten Textaufgaben.
Warum verursacht Think-First-Reasoning Stille in einem Telefonanruf?
In einem Telefonanruf kann die Sprachsynthese erst beginnen, wenn das Modell die ersten Wörter seiner Antwort erzeugt. Jedes Reasoning-Token, das vor diesen Wörtern erzeugt wird, ist Zeit, in der der Anrufer nichts hört. In einem Chatfenster ist dieselbe Wartezeit eine Fortschrittsanzeige. In einem Anruf ist sie Stille in der Leitung und zusätzliche Latenz.
Die Dokumentation zur Latenz-Fehlerbehebung von Retell hält fest, dass größere, auf Reasoning ausgerichtete Modelle „langsamer beim ersten Token sind“ und „Latenz gegen Leistungsfähigkeit eintauschen“. OpenAI nennt Sprache als typischen Anwendungsfall für den Betrieb mit auf „none“ gesetztem Reasoning Effort und empfiehlt latenzkritischen Anwendungen, „das Modell eine kurze Einleitung erzeugen zu lassen, bevor es mit tieferem Reasoning fortfährt“. Der Leitfaden zum besten LLM für KI-Sprachagenten behandelt die Modellwahl.
Was ist Interleaved Reasoning bei einem Sprachagenten?
Bei einem Sprachagenten bedeutet Interleaved Reasoning, dass das Modell den ersten Satz seiner Antwort sofort schreibt, still schlussfolgert, während dieser Satz gesprochen wird, und die Antwort dann auf Grundlage dieses Reasonings fortsetzt. Der Anrufer hört eine durchgehende Antwort, und das Reasoning wird nie ausgesprochen.
Tell-1 funktioniert auf diese Weise. Der technische Beitrag von Retell, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, beschreibt das Format als „ein gesprochener Einstieg, dann Reasoning, dann der Rest der Antwort“. Laut dem Beitrag entstehen mitten in der Antwort im Durchschnitt 200 Reasoning-Tokens, und bei 99,98 % der Turns beträgt die Pause nach dem ersten Satz weniger als 400 ms.
Im Vergleich zum Think-First-Reasoning wartet der Anrufer nicht in Stille darauf, dass das Reasoning abgeschlossen ist. Der Beitrag benennt auch den Kompromiss: „Früher zu sprechen bedeutet, sich auf den Einstieg festzulegen, bevor überhaupt ein Reasoning stattgefunden hat.“ Tell-1 belegt im Retell vCX Benchmark insgesamt Platz 1 (Stand: November 2026).
Häufig gestellte Fragen zu Interleaved Reasoning
Ist Interleaved Reasoning dasselbe wie Interleaved Thinking?
Ja, in den meisten Fällen. Anthropic und OpenAI sprechen von Interleaved Thinking; Forschungsarbeiten verwenden eher Interleaved Reasoning.
Werden Reasoning-Tokens abgerechnet?
Ja. OpenAI, Anthropic und Google rechnen sie alle zum abgerechneten Output. OpenAI und Anthropic berechnen sie auch dann, wenn der Reasoning-Text nicht zurückgegeben wird.
Kann man die Reasoning-Tokens eines Modells lesen?
In der Regel nicht. OpenAI und Anthropic können auf Anfrage eine Zusammenfassung liefern. Keiner der beiden gibt das rohe Reasoning zurück.
Antwortet ein Modell mit Interleaved Reasoning schneller?
Nicht automatisch. Zwischen Tool-Aufrufen fügt es Tokens hinzu, und die Dokumentation von vLLM warnt, dass es die Antwortlatenz erhöht. Die erste sichtbare Ausgabe kommt nur dann früher an, wenn sichtbare Ausgabe vor dem Reasoning oder zwischen kürzeren Reasoning-Blöcken erfolgt.
Was ist Interleaved Reasoning in der Sprach-KI?
Es handelt sich um ein Modell, das sofort zu sprechen beginnt, still schlussfolgert, während sein erster Satz wiedergegeben wird, und die Antwort dann auf Grundlage dieses Reasonings vervollständigt. Tell-1, das eigene LLM von Retell, ist so aufgebaut.
Reasoning-Modelle in Live-Anrufen einsetzen
Die Retell AI ist eine Plattform für KI-Sprachagenten für Contact Center. Sie wählen das Modell hinter jedem Agenten selbst. Tell-1 ist eines davon. Sprechen Sie mit dem Retell-Team.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


